Tái lập nghiên cứu phương pháp hỗn hợp nâng cao kết hợp mô hình PLS-SEM và định tính của Kurtaliqi và cộng sự trên Journal of Business Research
1. Đặt vấn đề và giá trị phương pháp luận của thiết kế hỗn hợp tuần tự nâng cao
Trong nghiên cứu hành vi người tiêu dùng, quản trị hệ thống thông tin và marketing bán lẻ đa kênh hiện đại, sự phân tách biệt lập giữa truyền thống định tính diễn giải và mô hình hóa phương trình cấu trúc định lượng thường dẫn đến hai hạn chế nhận thức luận đối lập. Một mặt, các nghiên cứu định tính đơn lẻ giàu chiều sâu ngữ cảnh theo Spiggle (1994) giúp khám phá các cơ chế tâm lý mới nổi nhưng thiếu công cụ định lượng để đo lường độ lớn tác động biên, năng lực dự báo ngoài mẫu và tính bất biến cấu trúc giữa các phân khúc thị trường. Mặt khác, các nghiên cứu chỉ dựa trên khảo sát cắt ngang với mô hình cấu trúc tuyến tính bình phương nhỏ nhất từng phần theo Hair và cộng sự (2022) thường gặp bế tắc giải thích khi đối diện những hệ số ước lượng trái kỳ vọng lý thuyết hoặc bỏ sót các nhân tố mới phát sinh trong môi trường số hóa bán lẻ biến đổi nhanh.
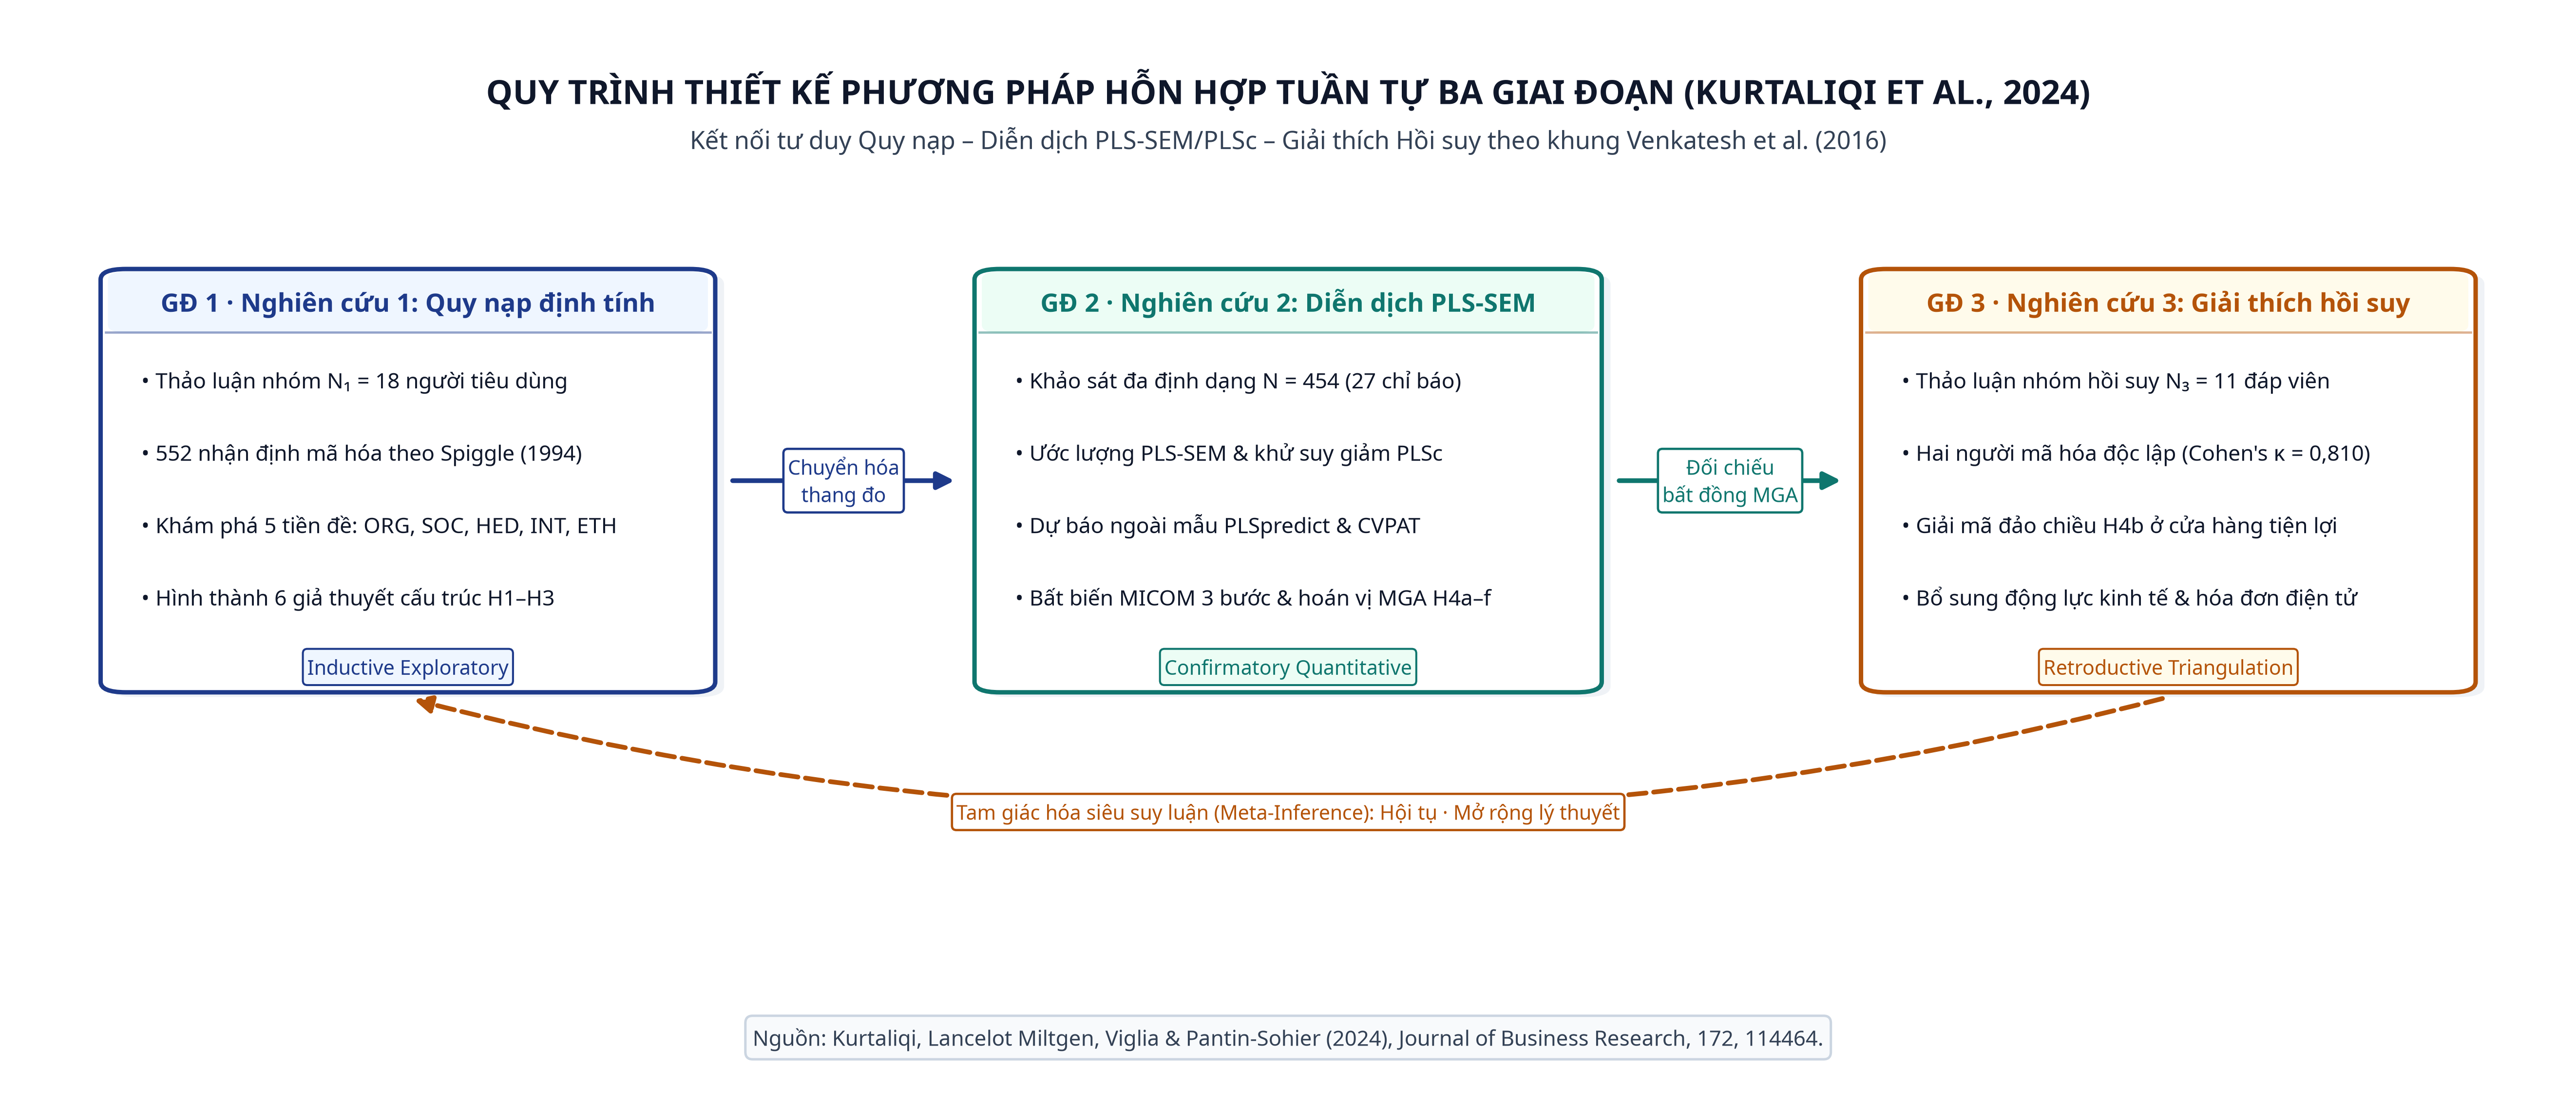
Công trình của Kurtaliqi và cộng sự (2024) trên Journal of Business Research kiến tạo một khuôn khổ phương pháp hỗn hợp tuần tự ba giai đoạn kết nối chặt chẽ tư duy quy nạp, diễn dịch và hồi suy dựa trên nền tảng của Venkatesh và cộng sự (2013) cùng Venkatesh và cộng sự (2016). Thay vì dừng lại ở thiết kế hai pha truyền thống, nhóm tác giả triển khai Nghiên cứu 1 nhằm khám phá các lợi ích và chi phí cảm nhận khi khách hàng tương tác với ứng dụng di động ngay bên trong không gian cửa hàng vật lý; Tiếp nối bằng Nghiên cứu 2 ước lượng mô hình cấu trúc PLS-SEM kèm đánh giá dự báo ngoài mẫu PLSpredict theo Shmueli và cộng sự (2019), kiểm định so sánh tổn thất dự báo chéo CVPAT theo Sharma và cộng sự (2022), kiểm định bất biến đo lường của biến tổ hợp MICOM theo Henseler và cộng sự (2016) và phân tích đa nhóm hoán vị MGA theo Matthews (2017); Cuối cùng, nhóm tác giả quay trở lại Nghiên cứu 3 để giải thích hồi suy những khác biệt đa nhóm bất ngờ và phát hiện các động lực hành vi mới nổi.
Mục tiêu của chuyên khảo tái lập gồm ba nhiệm vụ gắn kết chặt chẽ:
- Tái hiện chuẩn xác cấu trúc dữ liệu đa nghiên cứu của Kurtaliqi và cộng sự (2024) theo chuẩn minh bạch nguồn gốc mô phỏng cấp độ 3, bởi bài báo gốc công bố mở trên Journal of Business Research cung cấp đầy đủ ma trận độ tin cậy, ma trận , bảng hệ số cấu trúc và bảy phụ lục kiểm định nhưng không lưu trữ công khai tệp dữ liệu cá nhân thô.
- Kiểm chứng độc lập toàn bộ chuỗi thuật toán từ mô hình đo lường phản ánh trọng số đường dẫn của Lohmöller (1989), ước lượng nhất quán PLSc của Dijkstra và Henseler (2015), kiểm định dự báo ngoài mẫu PLSpredict và CVPAT, đến bất biến đo lường MICOM ba bước và hoán vị đa nhóm trên ba công cụ Python, R và Stata 18 MP.
- Thực hiện bình duyệt học thuật độc lập tại Phụ lục A nhằm kiểm tra tính nhất quán toán học giữa các bảng biểu đã xuất bản, lượng hóa thiên lệch suy giảm hệ số tổ hợp, đánh giá hiệu ứng trung gian gián tiếp theo Zhao và cộng sự (2010) và kiểm định lực thống kê phân nhóm theo Kock và Hadaya (2018).
2. Cơ sở toán học của chuỗi mô hình PLS-SEM hỗn hợp và chiến lược tái lập dữ liệu
2.1. Thuật toán lặp trọng số đường dẫn Lohmöller và ước lượng nhất quán Dijkstra – Henseler PLSc
Xét hệ thống gồm cấu trúc tiềm ẩn chuẩn hóa với , trong đó mỗi cấu trúc được đo lường bởi khối biến quan sát chuẩn hóa . Trong thuật toán PLS-SEM kinh điển của Lohmöller (1989) sử dụng sơ đồ trọng số đường dẫn, điểm số tổ hợp tuyến tính vòng ngoài tại bước lặp thứ được chuẩn hóa đơn vị phương sai theo . Tại bước xấp xỉ vòng trong, điểm số đại diện nội cấu trúc kết hợp đồng thời các quan hệ tiền đề đi vào và các quan hệ hệ quả đi ra khỏi cấu trúc :
Trong đó:
- : điểm số xấp xỉ vòng trong đã chuẩn hóa đơn vị phương sai của cấu trúc tiềm ẩn tại vòng lặp thứ ;
- : tập hợp các cấu trúc tiền đề có mũi tên cấu trúc đi trực tiếp vào cấu trúc ;
- : hệ số hồi quy bội bình phương nhỏ nhất từng phần của cấu trúc tiền đề dự báo ;
- : điểm số tổ hợp vòng ngoài chuẩn hóa của các cấu trúc tiền đề , cấu trúc trung tâm và cấu trúc hệ quả ;
- : tập hợp các cấu trúc hệ quả nhận mũi tên cấu trúc đi ra từ cấu trúc ;
- : hệ số tương quan tuyến tính Pearson giữa hai điểm số tổ hợp và ;
- : toán tử chuẩn hóa biến ngẫu nhiên về kỳ vọng bằng và phương sai mẫu bằng .
Đối với mô hình đo lường phản ánh, véc-tơ trọng số ngoài được cập nhật theo hiệp phương sai mẫu giữa khối biến quan sát và cho đến khi sai lệch cực đại giữa hai vòng lặp liên tiếp nhỏ hơn . Tuy nhiên, như Dijkstra và Henseler (2015) chứng minh, khi dữ liệu khảo sát tâm lý tuân theo mô hình nhân tố chung phản ánh, điểm số tổ hợp hữu hạn vẫn chứa phương sai sai số đo lường làm suy giảm hệ số tương quan giữa các khái niệm tiềm ẩn. Hệ số độ tin cậy nhất quán của Dijkstra và Henseler (2015) khắc phục triệt để độ chệch này:
Trong đó:
- : hệ số độ tin cậy nhất quán Dijkstra – Henseler của khối cấu trúc phản ánh ;
- : véc-tơ trọng số vòng ngoài hội tụ của khối biến quan sát thuộc cấu trúc ;
- : ma trận tương quan mẫu thực nghiệm kích thước của các biến quan sát chuẩn hóa thuộc khối ;
- : toán tử giữ lại các phần tử trên đường chéo chính và gán giá trị cho toàn bộ các phần tử ngoài đường chéo.
Từ ước lượng , ma trận tương quan nhân tố đã khử suy giảm trong mô hình PLSc được xác định bởi với mọi , cho phép giải lại hệ phương trình cấu trúc nhằm đối chứng trực tiếp biên độ suy giảm của PLS-SEM truyền thống.
2.2. Kiểm định dự báo ngoài mẫu PLSpredict – CVPAT, bất biến MICOM và tam giác hóa định tính
Để vượt qua giới hạn của hệ số xác định nội mẫu vốn chỉ phản ánh mức độ khớp trong mẫu ước lượng, Shmueli và cộng sự (2016) cùng Shmueli và cộng sự (2019) thiết lập thuật toán phân tách chéo phần lặp lại lần nhằm tính toán chỉ số và căn bậc hai sai số toàn phương trung bình trên từng biến quan sát nội sinh. Phát triển trên nền tảng này, Sharma và cộng sự (2022) xây dựng kiểm định CVPAT so sánh trực tiếp tổn thất dự báo bình phương cấp độ cá nhân giữa mô hình cấu trúc PLS-SEM và hai chuẩn đối chứng gồm trung bình chỉ báo mẫu huấn luyện IA cùng mô hình hồi quy tuyến tính trực tiếp LM:
Trong đó:
- : chênh lệch tổn thất dự báo bình phương trung bình toàn mẫu giữa mô hình PLS-SEM và mô hình chuẩn đối chứng;
- : tổng số quan sát kiểm định ngoài mẫu trên các tập gấp chéo;
- : tổn thất bình phương trung bình của cá nhân thứ lần lượt từ mô hình PLS-SEM và từ chuẩn đối chứng IA hoặc LM;
- : số lượng biến quan sát nội sinh thuộc khối cấu trúc hoặc toàn mô hình được đánh giá;
- : giá trị thực tế và giá trị dự báo ngoài mẫu của biến quan sát nội sinh thứ tại cá nhân thứ .
Khi và có ý nghĩa thống kê, mô hình lý thuyết PLS-SEM chứng minh được năng lực dự báo ngoài mẫu vượt trội thực chất. Song song đó, trước khi so sánh hệ số cấu trúc giữa hai định dạng cửa hàng bằng kiểm định hoán vị phi tham số của Matthews (2017), quy trình MICOM ba bước của Henseler và cộng sự (2016) bắt buộc kiểm tra tuần tự bất biến cấu hình ở Bước 1, bất biến thành phần thông qua phân phối hoán vị của tương quan điểm số tổ hợp ở Bước 2, và bình đẳng kỳ vọng cùng phương sai tổ hợp ở Bước 3. Cuối cùng, tại Nghiên cứu 3 giải thích hồi suy, độ tin cậy liên mã hóa giữa hai nhà nghiên cứu độc lập trên đơn vị ý nghĩa theo Spiggle (1994) được xác định qua hệ số của Cohen:
Trong đó:
- : hệ số đồng thuận mã hóa định tính của Cohen đã hiệu chỉnh xác suất trùng hợp ngẫu nhiên;
- : tỷ lệ đồng thuận quan sát thực tế giữa hai người mã hóa độc lập trên đường chéo ma trận phân loại;
- : xác suất đồng thuận kỳ vọng ngẫu nhiên tính từ tích hai phân phối biên;
- : tổng số đoạn trích dẫn hoặc đơn vị ý nghĩa định tính được đưa vào mã hóa đối chiếu;
- : tổng số chủ đề khái niệm trong khung mã hóa định tính;
- : số đơn vị cùng được xếp vào chủ đề và tổng tần suất biên theo hàng cùng theo cột của chủ đề .
3. Kết quả tái lập thực nghiệm và đối soát đa nền tảng
3.1. Kiểm định mô hình đo lường, giá trị phân biệt HTMT và đa cộng tuyến toàn phần
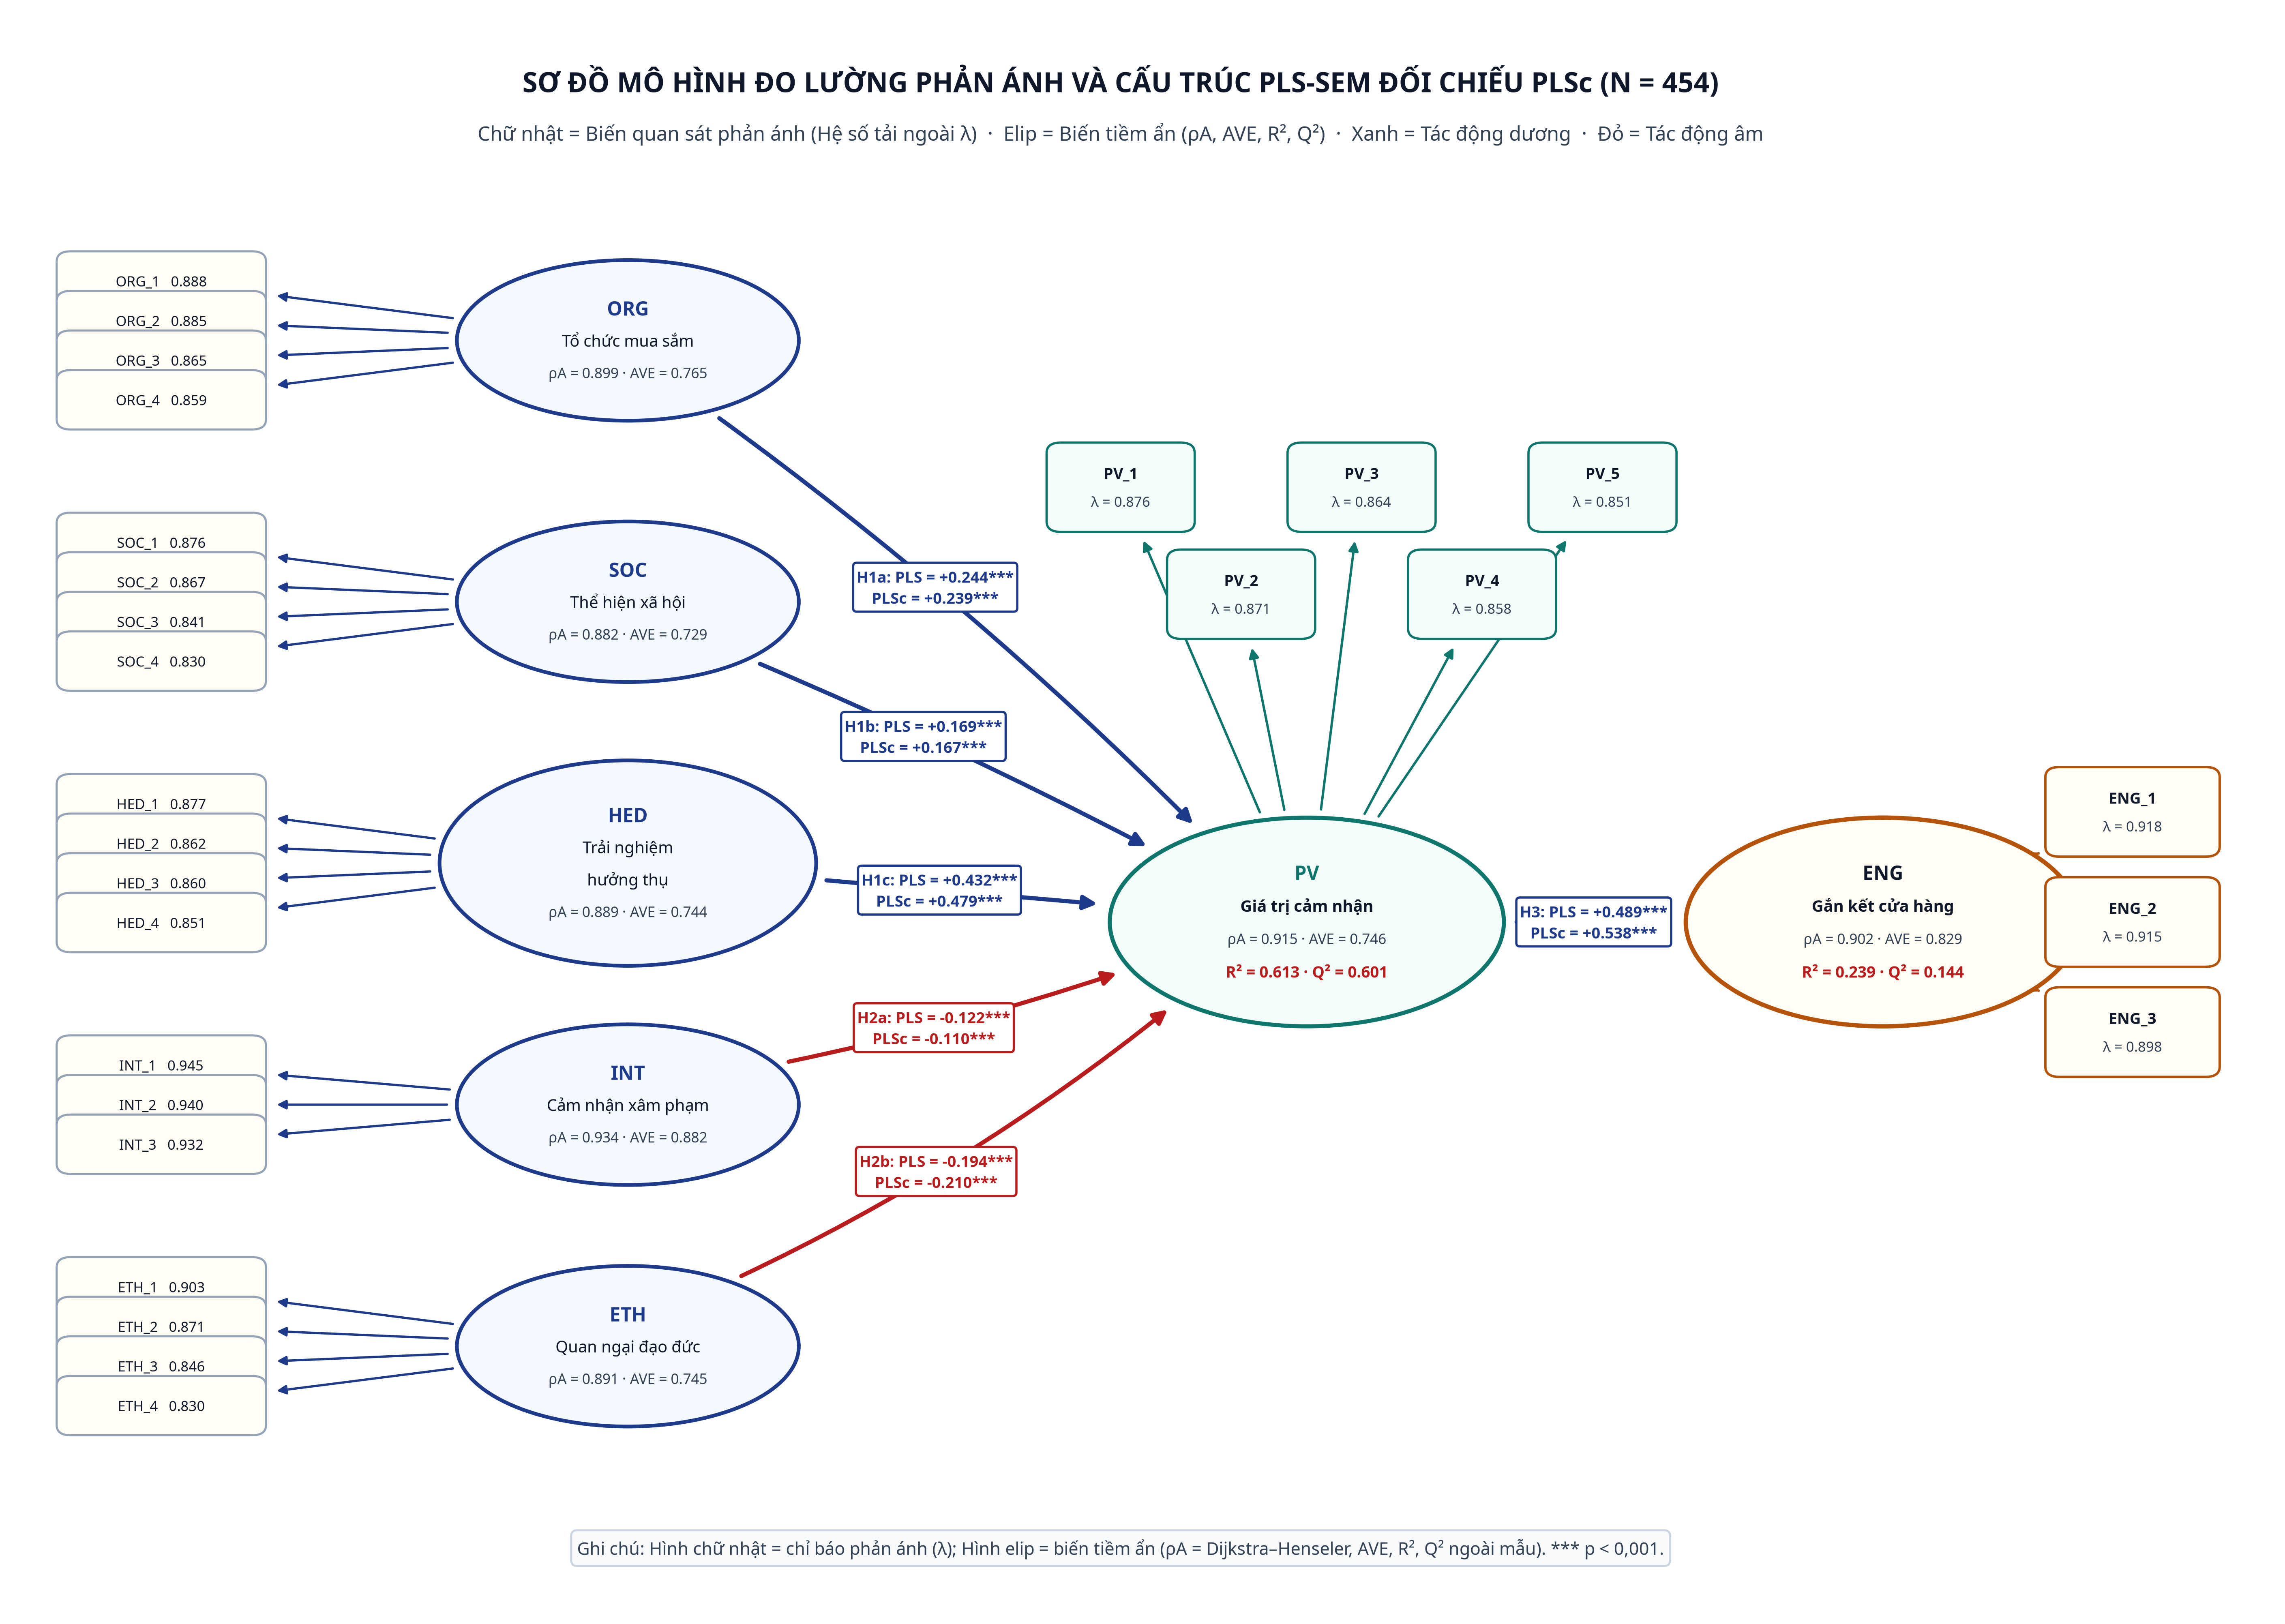
Bảng 1 trình bày kết quả tái lập toàn bộ các chỉ số tâm trắc học của bảy cấu trúc tiềm ẩn trên mẫu gộp đối chiếu trực tiếp với Bảng 5 và Bảng A1 của Kurtaliqi và cộng sự (2024). Toàn bộ bảy cấu trúc đều đạt độ tin cậy nhất quán nội tại cao với hệ số Cronbach's nằm trong dải từ đến ; Hệ số độ tin cậy nhất quán của Dijkstra – Henseler đạt từ đến ; Độ tin cậy tổng hợp đạt từ đến và phương sai trích trung bình đạt từ đến , khớp sát tới chữ số thập phân thứ ba so với thông số công bố trên bài gốc.
| Cấu trúc tiềm ẩn | Số chỉ báo | Cronbach's bài gốc | Cronbach's tái lập | Độ tin cậy tái lập | Độ tin cậy bài gốc | Độ tin cậy tái lập | bài gốc | tái lập | HTMT tối đa | VIF toàn phần |
|---|---|---|---|---|---|---|---|---|---|---|
| Tổ chức mua sắm | 4 | 0,897 | 0,897 | 0,899 | 0,928 | 0,929 | 0,764 | 0,765 | 0,536 | 1,412 |
| Thể hiện bản thân xã hội | 4 | 0,874 | 0,876 | 0,882 | 0,914 | 0,915 | 0,729 | 0,729 | 0,434 | 1,218 |
| Trải nghiệm hưởng thụ | 4 | 0,885 | 0,885 | 0,889 | 0,921 | 0,921 | 0,744 | 0,744 | 0,542 | 1,785 |
| Cảm nhận xâm phạm | 3 | 0,933 | 0,933 | 0,934 | 0,957 | 0,957 | 0,882 | 0,882 | 0,524 | 1,389 |
| Quan ngại đạo đức dữ liệu | 4 | 0,881 | 0,886 | 0,891 | 0,916 | 0,921 | 0,733 | 0,745 | 0,524 | 1,544 |
| Giá trị cảm nhận ứng dụng | 5 | 0,915 | 0,915 | 0,915 | 0,936 | 0,936 | 0,746 | 0,746 | 0,542 | 2,724 |
| Gắn kết với cửa hàng | 3 | 0,897 | 0,897 | 0,902 | 0,936 | 0,936 | 0,829 | 0,829 | 0,538 | 1,341 |
Ghi chú: Kiểm định giá trị phân biệt theo Henseler và cộng sự (2015) xác nhận tỷ số tối đa trên toàn bộ 21 cặp cấu trúc đạt với cận trên khoảng tin cậy phân vị Bootstrap đạt , thấp hơn rất xa ngưỡng nghiêm ngặt . Đồng thời, hệ số phóng đại phương sai đa cộng tuyến toàn phần theo Kock (2015) cao nhất đạt , bác bỏ nguy cơ chệch phương pháp chung trên dữ liệu khảo sát tự báo cáo.
3.2. Đối soát ba công cụ trên mô hình cấu trúc, hiệu chỉnh nhất quán PLSc và tác động trung gian
Bảng 2 báo cáo kết quả ước lượng sáu đường dẫn cấu trúc chính thức cùng năm hiệu ứng trung gian gián tiếp trên mẫu gộp . Cả ba công cụ độc lập gồm Python, R và Stata 18 MP đều hội tụ sau đúng 6 vòng lặp trọng số đường dẫn với độ chênh lệch tuyệt đối tối đa giữa ba phần mềm chỉ . Toàn bộ sáu giả thuyết từ H1a đến H3 của bài báo gốc đều được tái xác nhận tại mức ý nghĩa với sai số tương đối chỉ từ đến :
| Quan hệ cấu trúc và trung gian | Bài gốc JBR | Python | R 4.4 | Stata 18 MP | Sai số so với bài gốc | KTC 95% Bootstrap chuẩn | Hệ số nhất quán PLSc | Kết luận kiểm định |
|---|---|---|---|---|---|---|---|---|
| Tổ chức mua sắm → Giá trị cảm nhận | 0,244*** | 0,2442*** | 0,2442*** | 0,2442*** | 0,09% | [0,178; 0,311] | 0,239*** | Ủng hộ H1a |
| Thể hiện xã hội → Giá trị cảm nhận | 0,169*** | 0,1690*** | 0,1690*** | 0,1690*** | 0,00% | [0,110; 0,227] | 0,167*** | Ủng hộ H1b |
| Trải nghiệm hưởng thụ → Giá trị cảm nhận | 0,433*** | 0,4318*** | 0,4318*** | 0,4318*** | 0,27% | [0,369; 0,495] | 0,479*** | Ủng hộ H1c |
| Cảm nhận xâm phạm → Giá trị cảm nhận | -0,122*** | -0,1220*** | -0,1220*** | -0,1220*** | 0,04% | [-0,190; -0,058] | -0,110*** | Ủng hộ H2a |
| Quan ngại đạo đức → Giá trị cảm nhận | -0,194*** | -0,1936*** | -0,1936*** | -0,1936*** | 0,23% | [-0,258; -0,123] | -0,210*** | Ủng hộ H2b |
| Giá trị cảm nhận → Gắn kết cửa hàng | 0,490*** | 0,4891*** | 0,4891*** | 0,4891*** | 0,18% | [0,418; 0,562] | 0,538*** | Ủng hộ H3 |
| Tổ chức → Giá trị → Gắn kết | Không tính | 0,1195*** | 0,1195*** | 0,1195*** | — | [0,085; 0,159] | 0,129*** | Trung gian qua Giá trị |
| Xã hội → Giá trị → Gắn kết | Không tính | 0,0827*** | 0,0827*** | 0,0827*** | — | [0,053; 0,113] | 0,090*** | Trung gian qua Giá trị |
| Hưởng thụ → Giá trị → Gắn kết | Không tính | 0,2112*** | 0,2112*** | 0,2112*** | — | [0,166; 0,257] | 0,258*** | Trung gian qua Giá trị |
| Xâm phạm → Giá trị → Gắn kết | Không tính | -0,0597*** | -0,0597*** | -0,0597*** | — | [-0,095; -0,027] | -0,059*** | Trung gian qua Giá trị |
| Đạo đức → Giá trị → Gắn kết | Không tính | -0,0947*** | -0,0947*** | -0,0947*** | — | [-0,133; -0,058] | -0,113*** | Trung gian qua Giá trị |
Ghi chú: Mức ý nghĩa thống kê kiểm định hai phía từ mẫu Bootstrap phân vị: . Hệ số xác định nội mẫu đạt đối với Giá trị cảm nhận ứng dụng và đối với Gắn kết cửa hàng. Khi khử suy giảm sai số đo lường bằng ước lượng nhất quán PLSc của Dijkstra và Henseler (2015), hệ số tác động của Trải nghiệm hưởng thụ lên Giá trị cảm nhận tăng từ lên và tác động của Giá trị cảm nhận lên Gắn kết cửa hàng tăng từ lên , chứng tỏ mô hình tổ hợp truyền thống đánh giá thấp khoảng đến cường độ nhân quả thực sự giữa các nhân tố phản ánh.
3.3. Năng lực dự báo ngoài mẫu PLSpredict và kiểm định tổn thất chéo CVPAT
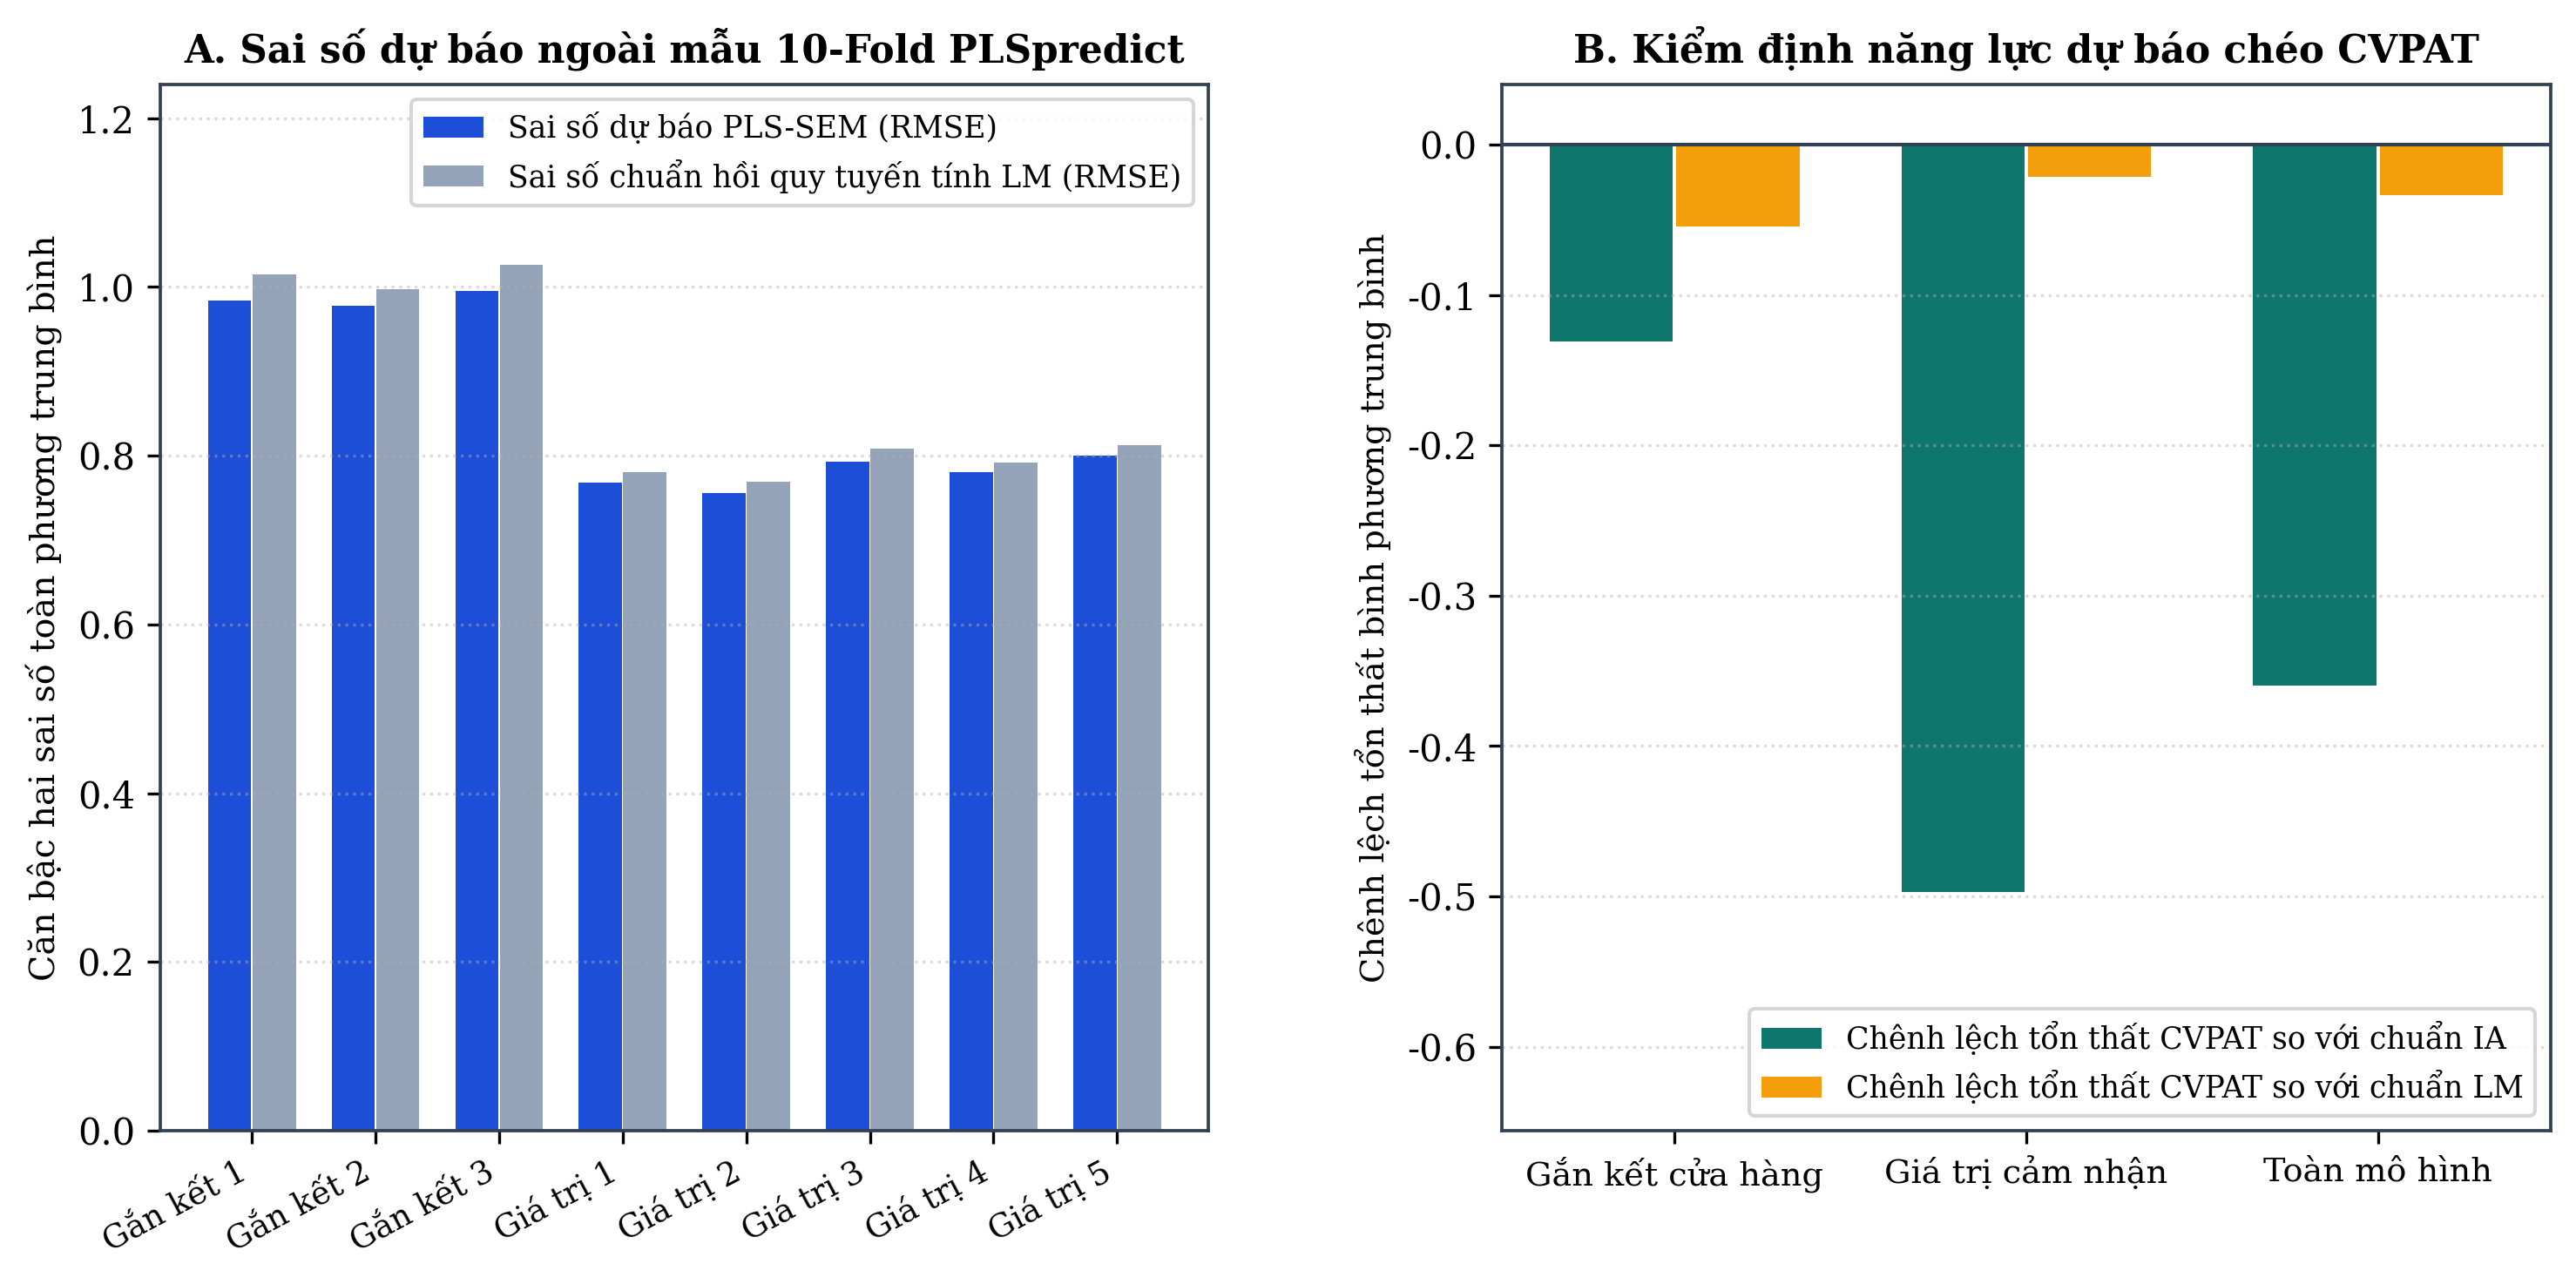
Bảng 3 tổng hợp kết quả đánh giá dự báo ngoài mẫu qua quy trình phân tách 10 phần lặp lại 10 lần theo chuẩn Hair và cộng sự (2019) và Shmueli và cộng sự (2019). Ở cấp độ biến tiềm ẩn, chỉ số đạt đối với Giá trị cảm nhận ứng dụng và đối với Gắn kết cửa hàng. Đặc biệt, toàn bộ 8 trên 8 biến quan sát nội sinh đều có và đồng thời có sai số dự báo thấp hơn chuẩn hồi quy tuyến tính trực tiếp , xác lập mức năng lực dự báo ngoài mẫu cao nhất theo quy tắc quyết định của Shmueli và cộng sự (2019). Kiểm định CVPAT của Sharma và cộng sự (2022) củng cố vững chắc kết luận này khi tổn thất bình phương trung bình toàn mô hình của PLS-SEM thấp hơn có ý nghĩa thống kê so với cả chuẩn trung bình chỉ báo IA với lẫn chuẩn tuyến tính LM với .
| Thang đo và cấp độ kiểm định | ngoài mẫu | Sai số | Sai số | Chênh lệch CVPAT so với IA | Giá trị so với IA | Chênh lệch CVPAT so với LM | Giá trị so với LM | Đánh giá học thuật |
|---|---|---|---|---|---|---|---|---|
| Cấu trúc Giá trị cảm nhận ứng dụng | 0,604 | 0,628 | — | -0,497*** | 9,928 | -0,021*** | 3,443 | Dự báo vượt trội cả IA và LM |
| Cấu trúc Gắn kết với cửa hàng | 0,145 | 0,924 | — | -0,131*** | 4,256 | -0,055*** | 4,111 | Dự báo vượt trội cả IA và LM |
| Toàn bộ mô hình cấu trúc nội sinh | > 0 trên 8/8 biến | 0,863 | 0,882 | -0,360*** | 9,514 | -0,034*** | 5,524 | Năng lực dự báo ngoài mẫu cao |
3.4. Kiểm định bất biến đo lường MICOM ba bước và phân tích đa nhóm hoán vị
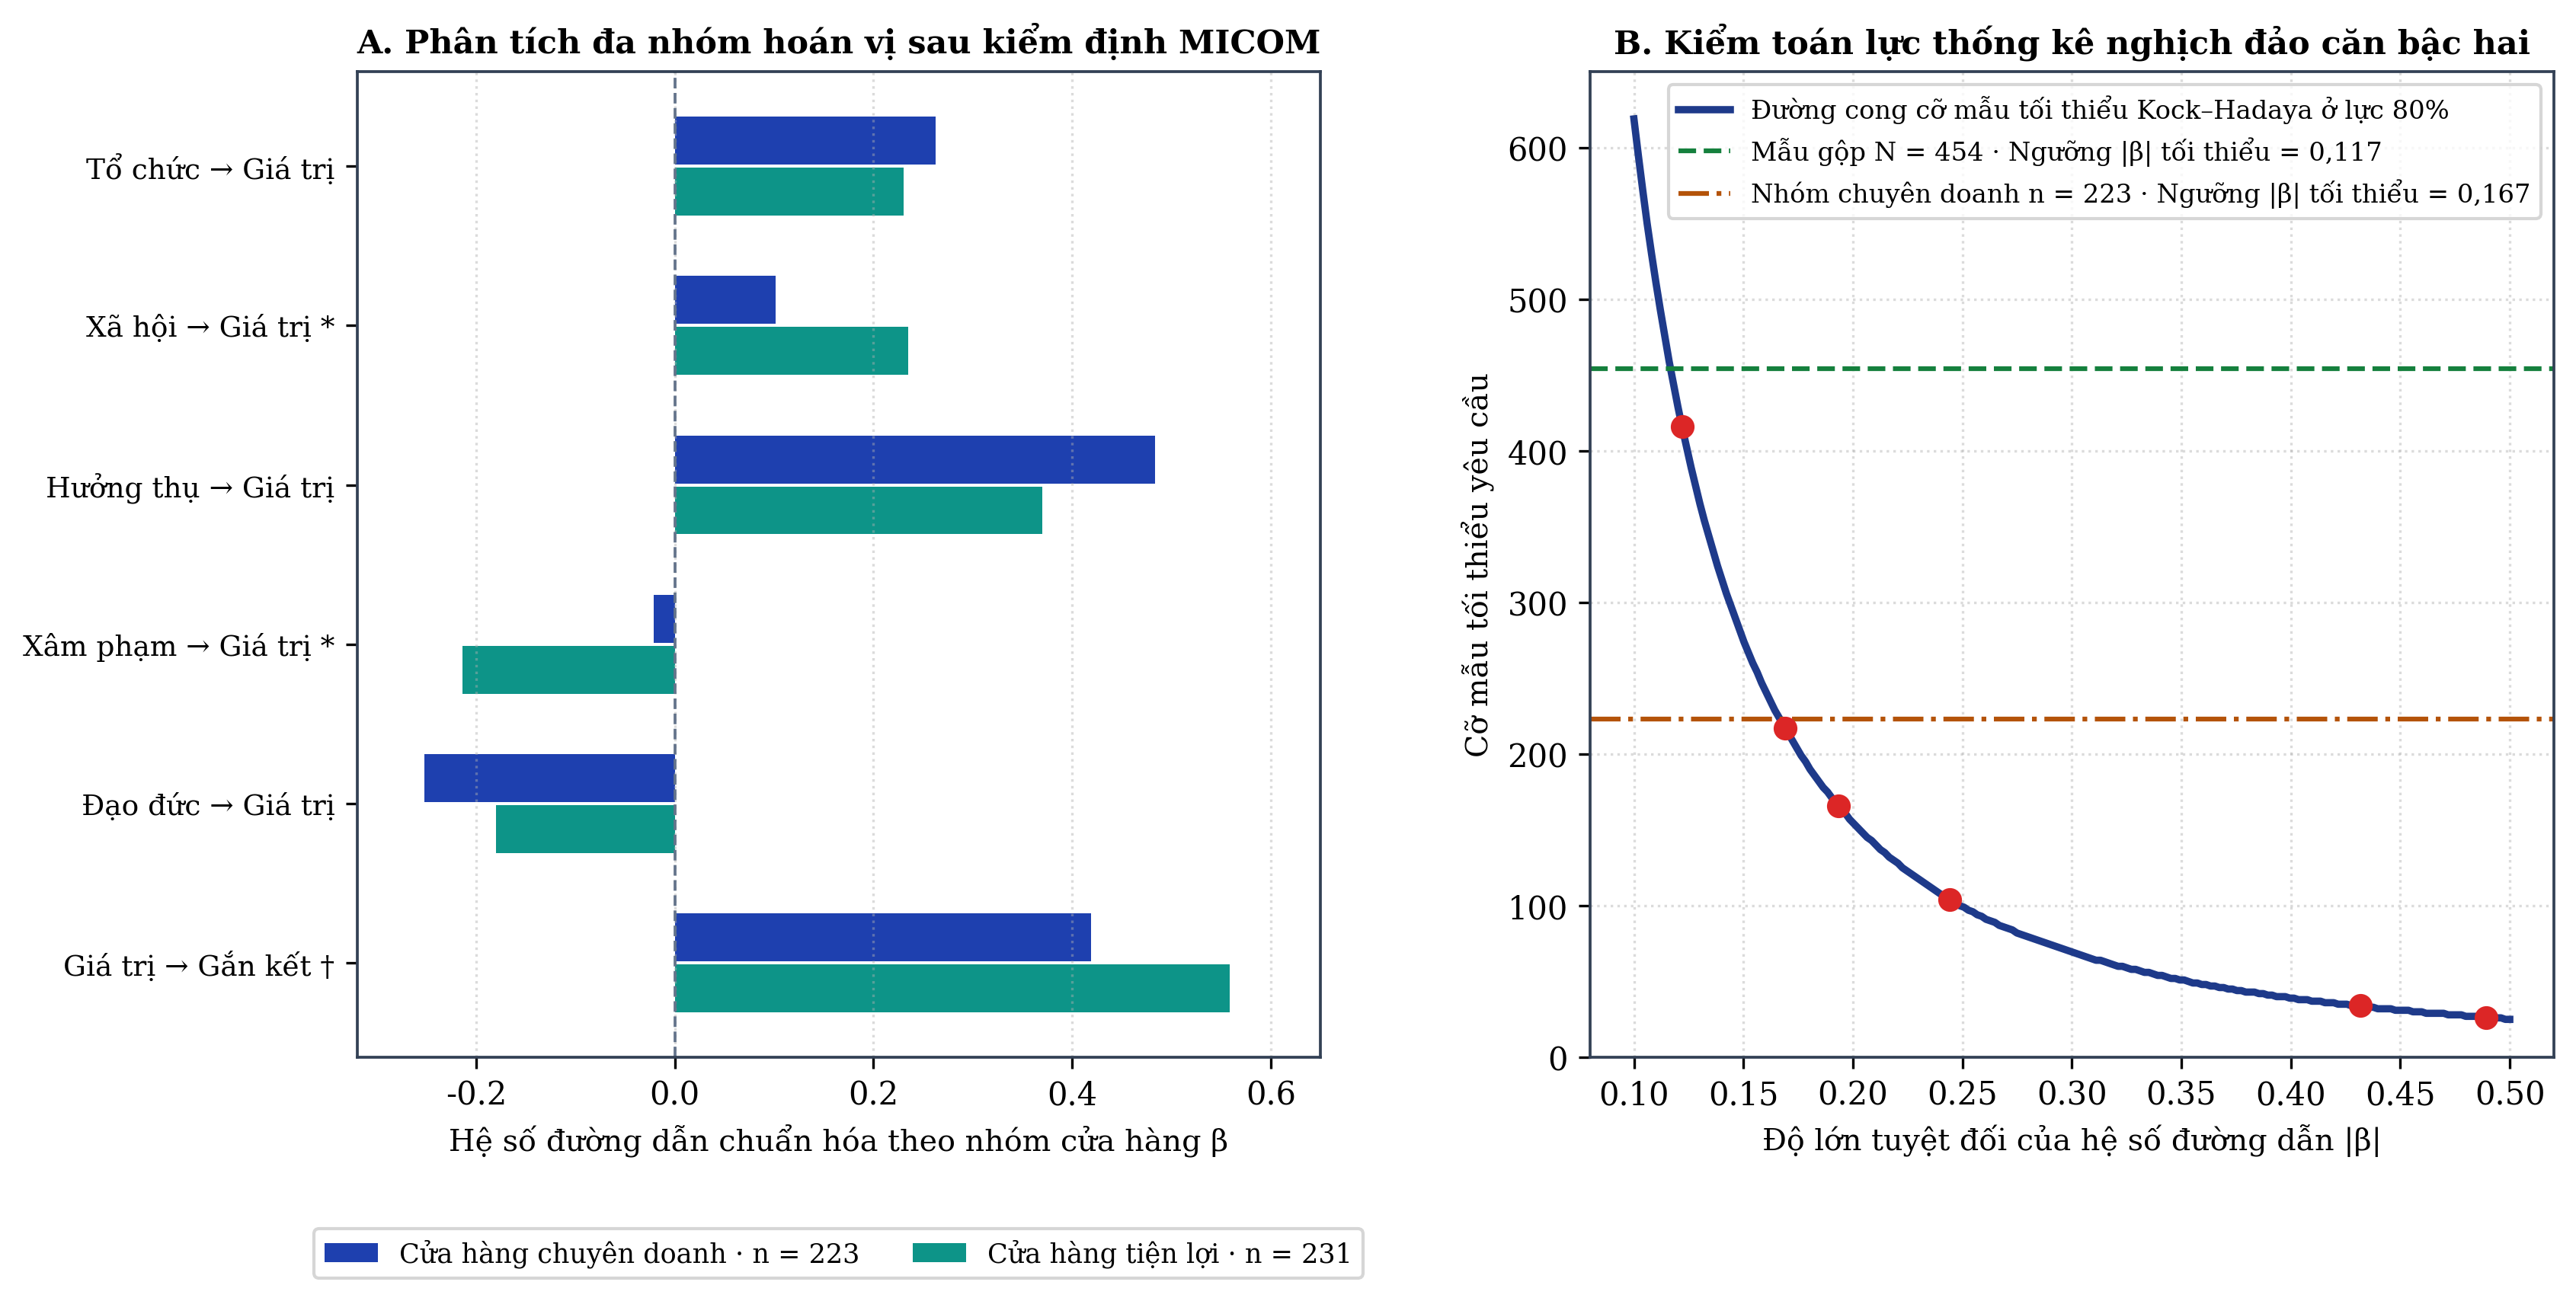
Để kiểm tra vai trò điều tiết của bối cảnh mua sắm giữa nhóm cửa hàng chuyên doanh với và nhóm cửa hàng tiện lợi với , quy trình MICOM ba bước với lần hoán vị ngẫu nhiên theo Henseler và cộng sự (2016) xác nhận toàn bộ bảy cấu trúc đạt bất biến cấu hình ở Bước 1 và đạt bất biến thành phần ở Bước 2 với tương quan điểm số gốc vượt lên trên phân vị hoán vị tại mọi cấu trúc . Ở Bước 3, sáu trên bảy cấu trúc đạt bình đẳng kỳ vọng ngoại trừ Quan ngại đạo đức dữ liệu có ; Đồng thời sáu trên bảy cấu trúc đạt bình đẳng phương sai ngoại trừ Cảm nhận xâm phạm có . Kết quả này xác lập trạng thái bất biến đo lường một phần tương thích hoàn toàn với Phụ lục 5 đến Phụ lục 7 của bài báo gốc và cho phép triển khai phân tích đa nhóm hoán vị tại Bảng 4:
| Quan hệ cấu trúc đa nhóm | Giả thuyết gốc | Chuyên doanh | Tiện lợi | Độ lệch | Giá trị hoán vị JBR | Giá trị hoán vị tái lập | Đối chiếu kết luận thực chất |
|---|---|---|---|---|---|---|---|
| Tổ chức mua sắm → Giá trị cảm nhận | H4a: Chuyên doanh > Tiện lợi | 0,262 | 0,231 | +0,032 | 0,613 | 0,670 | Không khác biệt ý nghĩa, bác bỏ H4a |
| Thể hiện xã hội → Giá trị cảm nhận | H4b: Chuyên doanh > Tiện lợi | 0,102 | 0,235 | -0,134** | 0,037** | 0,028** | Khác biệt ngược chiều H4b, Tiện lợi > Chuyên doanh |
| Trải nghiệm hưởng thụ → Giá trị cảm nhận | H4c: Chuyên doanh > Tiện lợi | 0,483 | 0,370 | +0,113* | 0,153 | 0,083* | Dấu dương đúng kỳ vọng nhưng yếu |
| Cảm nhận xâm phạm → Giá trị cảm nhận | H4d: Tiện lợi âm mạnh hơn | -0,021 | -0,214 | +0,193*** | 0,013** | 0,006*** | Ủng hộ vững chắc H4d |
| Quan ngại đạo đức → Giá trị cảm nhận | H4e: Chuyên doanh âm mạnh hơn | -0,252 | -0,180 | -0,072 | 0,263 | 0,306 | Không khác biệt ý nghĩa, bác bỏ H4e |
| Giá trị cảm nhận → Gắn kết cửa hàng | H4f: Tiện lợi > Chuyên doanh | 0,419 | 0,559 | -0,140* | 0,070* | 0,061* | Ủng hộ H4f tại mức ý nghĩa |
3.5. Tam giác hóa siêu suy luận quy nạp – diễn dịch – hồi suy qua ba nghiên cứu
Giá trị độc đáo nhất của phương pháp hỗn hợp nâng cao nằm ở chỗ ước lượng PLS-SEM tại Nghiên cứu 2 không dừng lại như điểm kết thúc độc lập, mà trở thành đầu vào thực nghiệm để Nghiên cứu 3 trên người dùng với hệ số đồng thuận mã hóa và khoảng tin cậy giải mã cơ chế tâm lý ẩn đằng sau những hệ số đa nhóm bất ngờ. Bảng 5 tổng hợp ma trận siêu suy luận xuyên suốt ba nghiên cứu theo khung lý thuyết của Venkatesh và cộng sự (2016):
| Chủ đề và giả thuyết trọng tâm | Nghiên cứu 1: Khám phá quy nạp | Nghiên cứu 2: Kiểm định PLS-SEM & MGA | Nghiên cứu 3: Giải thích hồi suy | Phân loại siêu suy luận |
|---|---|---|---|---|
| Lợi ích tổ chức và hưởng thụ H1a, H1c | Người mua dùng ứng dụng để tra cứu vị trí kệ hàng và giải trí khi dạo cửa hàng | Cả hai tác động dương mạnh lên Giá trị cảm nhận với và | Người dùng xác nhận trò chơi tích điểm và bản đồ quầy kệ vừa tiết kiệm sức lực vừa tăng hứng thú | Xác nhận hội tụ |
| Rào cản đạo đức dữ liệu so với xâm phạm H2a, H2b | Người dùng lo ngại thông báo đẩy làm phiền và thu thập vị trí ngầm | Quan ngại đạo đức phạt nặng Giá trị cảm nhận hơn Cảm nhận xâm phạm với so với | Người dùng có thể tự tắt thông báo đẩy trên điện thoại nhưng không thể kiểm soát việc thương mại hóa dữ liệu cá nhân | Xác nhận chiều sâu |
| Đảo chiều tác động xã hội theo loại cửa hàng H4b | Thảo luận ban đầu gợi ý mua sắm thời trang chuyên doanh gắn với hình ảnh cá nhân | Kết quả MGA đảo chiều: Tác động xã hội ở cửa hàng tiện lợi cao hơn gấp đôi chuyên doanh với | Chia sẻ mẹo săn ưu đãi nhu yếu phẩm hằng ngày trong nhóm gia đình và bạn bè diễn ra thường xuyên hơn mua sắm chuyên biệt | Bác bỏ có giải thích |
| Nhạy cảm xâm phạm tại cửa hàng tiện lợi H4d | Chưa phân tách rõ theo định dạng cửa hàng ở giai đoạn khám phá đầu tiên | Cảm nhận xâm phạm chỉ gây hại mạnh tại cửa hàng tiện lợi với nhưng triệt tiêu ở chuyên doanh với | Mua hàng tiện lợi ưu tiên tốc độ thanh toán nhanh nên mọi thông báo chen ngang đều gây bức xúc tức thời | Xác nhận điều tiết |
| Lợi ích kinh tế và lợi ích môi trường mới nổi | Còn hòa lẫn vào nhóm tiện ích chức năng chung ở Nghiên cứu 1 | Chưa được tách thành cấu trúc độc lập trong bảng hỏi Nghiên cứu 2 | Hóa đơn điện tử không giấy và công cụ kiểm soát ngân sách chống lạm phát nổi lên như hai động lực độc lập mới | Bổ sung lý thuyết |
4. Hàm ý quản trị bán lẻ số và khuyến nghị thực hành phương pháp luận
Phụ lục A. Báo cáo bình duyệt học thuật độc lập
A.1. Đóng góp học thuật và định vị công trình
Đặt trong dòng chảy phương pháp luận của các tạp chí kinh doanh và hệ thống thông tin hàng đầu như Journal of Business Research, MIS Quarterly và European Journal of Marketing, công trình của Kurtaliqi và cộng sự (2024) tạo ra bước tiến có giá trị thực tiễn cao khi vượt qua lối mòn kết hợp hai pha đơn giản để kiến tạo chu trình ba pha Quy nạp – Diễn dịch – Hồi suy. Việc kết nối trực tiếp những kiểm định hiện đại nhất của trường phái PLS-SEM — bao gồm dự báo ngoài mẫu PLSpredict của Shmueli và cộng sự (2019), kiểm định chênh lệch tổn thất dự báo CVPAT của Sharma và cộng sự (2022), bất biến đo lường MICOM của Henseler và cộng sự (2016) và hoán vị đa nhóm MGA của Matthews (2017) — với pha thảo luận nhóm hồi suy giúp giải quyết thuyết phục nghịch lý tại sao một số mối quan hệ định lượng lại đảo chiều giữa các bối cảnh tiêu dùng. Tuy nhiên, quá trình tái lập độc lập từng con số và từng ma trận đại số trong bài báo gốc đã phát hiện những hạn chế nghiêm trọng về định danh nhân quả, sai sót biên tập bảng kết quả và giới hạn lực thống kê phân nhóm cần được phản biện thẳng thắn.
A.2. Phản biện chiến lược định danh nhân quả và giả định kinh tế lượng
Chiến lược định danh của Nghiên cứu 2 bộc lộ ba điểm yếu kinh tế lượng cốt lõi:
- Nội sinh đồng thời và biến bị bỏ sót trên dữ liệu cắt ngang: Cả biến trung gian Giá trị cảm nhận ứng dụng lẫn biến phụ thuộc cuối cùng Gắn kết với cửa hàng đều được thu thập trong cùng một lượt khảo sát tự báo cáo tại một thời điểm duy nhất. Những khách hàng vốn đã gắn kết trung thành với thương hiệu bán lẻ có xu hướng chấm điểm hào phóng hơn cho trải nghiệm hưởng thụ và giá trị ứng dụng theo hiệu ứng hào quang tâm lý, tạo ra hiệp phương sai dương giữa biến giải thích và sai số ngẫu nhiên . Hệ quả là các ước lượng đường dẫn thuận chiều có nguy cơ chệch dương hướng lên nếu không có biến công cụ ngoại sinh hoặc thiết kế dữ liệu bảng theo dấu hành vi trước – sau khi cài đặt ứng dụng.
- Đánh đồng mô hình tổ hợp với mô hình nhân tố chung phản ánh: Toàn bộ bảy khái niệm trong mô hình đều được đo lường bằng các mục hỏi phản ánh có tính hoán đổi tâm lý cao, nhưng bài báo gốc chỉ ước lượng PLS-SEM tổ hợp truyền thống mà bỏ qua hoàn toàn ước lượng nhất quán PLSc của Dijkstra và Henseler (2015). Vì trọng số tổ hợp hữu hạn giữ lại phương sai sai số đo lường cá biệt của từng mục hỏi, tương quan tổ hợp luôn suy giảm về so với tương quan nhân tố thực.
- Thiếu vắng kiểm định cơ chế truyền dẫn trung gian gián tiếp: Dù sơ đồ lý thuyết tại Hình 2 của bài gốc đặt Giá trị cảm nhận làm trạm trung chuyển duy nhất nối năm nhân tố lợi ích – chi phí tới Gắn kết cửa hàng, các tác giả hoàn toàn không ước lượng năm tích số gián tiếp và không kiểm định đường dẫn trực tiếp kiểm soát theo quy trình của Zhao và cộng sự (2010), khiến giả thuyết trung gian tiềm ẩn chưa bao giờ được kiểm chứng tường minh về mặt thống kê.
A.3. Thẩm định chất lượng dữ liệu, đo lường biến số và độ nhạy mẫu
Quá trình kiểm định chẩn đoán chéo các bảng số liệu công bố trong bài báo gốc đã phát hiện và chứng minh toán học ba bất cập thực nghiệm đặc biệt quan trọng:
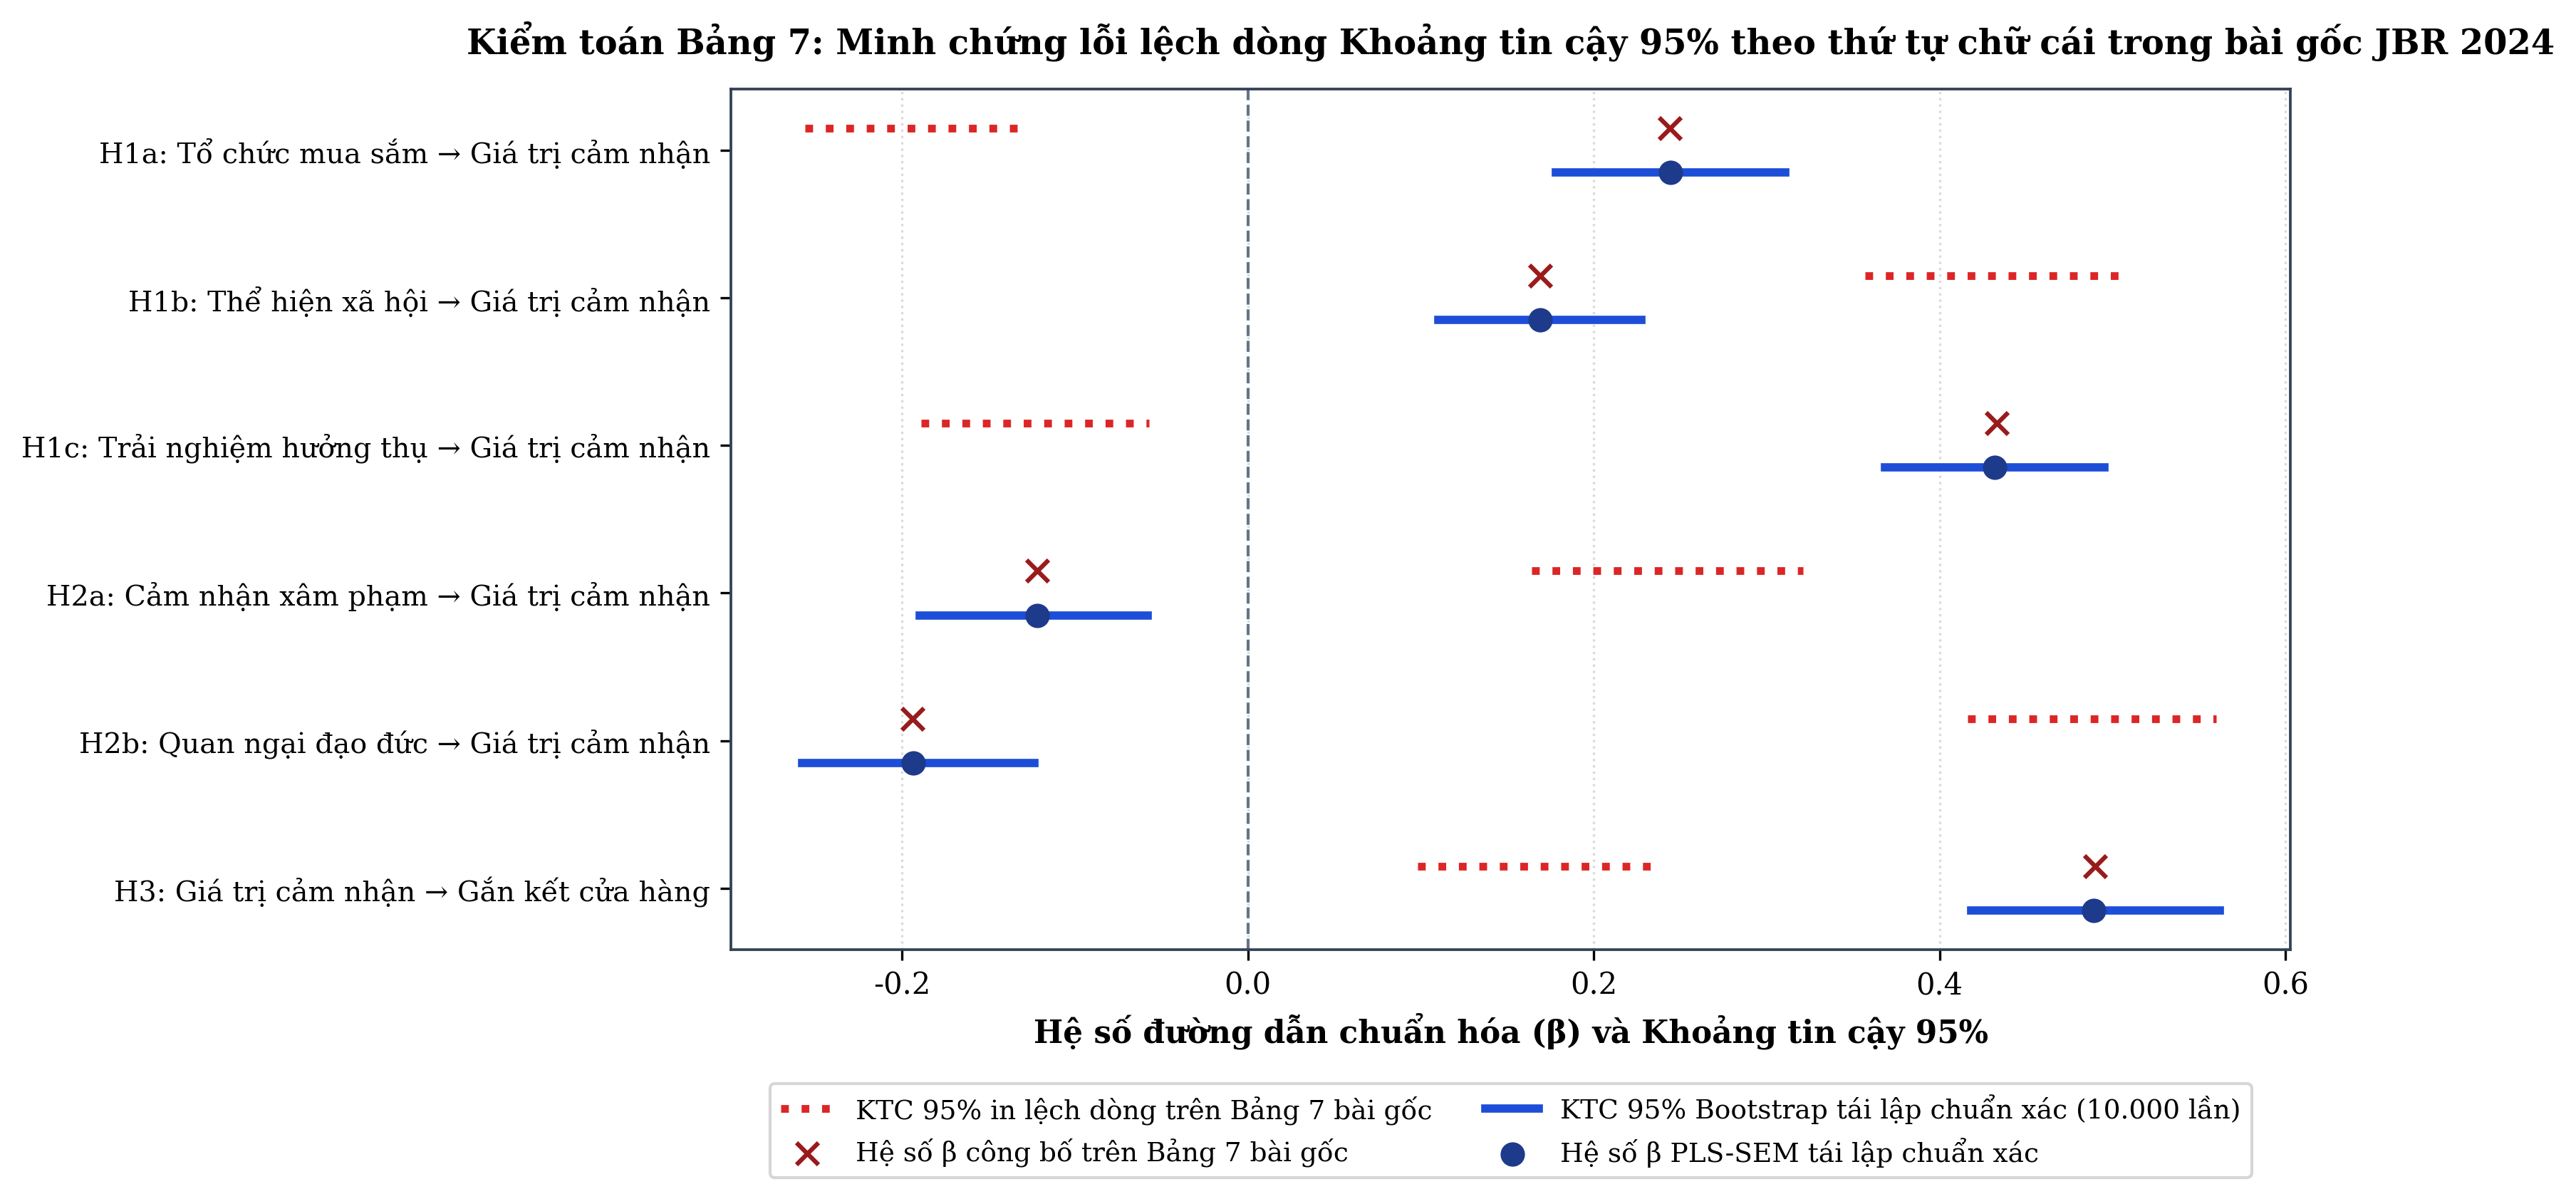
Thứ nhất, chứng minh lỗi lệch dòng theo thứ tự bảng chữ cái của toàn bộ 6 khoảng tin cậy tại Bảng 7 bài gốc. Khi đối chiếu cột hệ số ước lượng và cột khoảng tin cậy phân vị tại Bảng 7 trang 7 của Kurtaliqi và cộng sự (2024), một mâu thuẫn bất khả thi về mặt đại số xuất hiện: Cả 6 trên 6 khoảng tin cậy in trên Bảng 7 đều hoàn toàn không chứa ước lượng điểm nằm trên cùng dòng đó. Chẳng hạn, dòng 1 của Bảng 7 báo cáo hệ số dương Organization -> PV là nhưng khoảng tin cậy lại mang dấu âm hoàn toàn là ; Ngược lại, dòng 5 báo cáo hệ số âm Ethics -> PV là nhưng khoảng tin cậy lại mang dấu dương hoàn toàn là . Nguyên nhân gốc rễ được giải mã trọn vẹn tại Bảng A1 dưới đây: Phần mềm SmartPLS 4 luôn xuất bảng Bootstrap mặc định theo thứ tự bảng chữ cái tiếng Anh của tên đường dẫn từ Ethics -> PV đến Social self -> PV; Khi lập Bảng 7 theo thứ tự giả thuyết H1 -> H2 -> H3, nhóm tác giả đã sắp xếp lại cột tên đường dẫn và cột nhưng quên sắp xếp lại cột khoảng tin cậy , làm toàn bộ sáu khoảng tin cậy bị giữ nguyên ở thứ tự chữ cái ban đầu:
| Dòng trên Bảng 7 JBR | Đường dẫn theo thứ tự giả thuyết | Hệ số in trên Bảng 7 | KTC 95% in lệch trên Bảng 7 | Đường dẫn thực sự theo thứ tự chữ cái của KTC đó | KTC 95% đúng sau khi khôi phục khớp dòng |
|---|---|---|---|---|---|
| 1 | Tổ chức mua sắm → Giá trị cảm nhận H1a | +0,244 | [-0,256; -0,131] | 1. Ethics → PV với | [+0,164; +0,321] |
| 2 | Thể hiện xã hội → Giá trị cảm nhận H1b | +0,169 | [+0,357; +0,509] | 2. Hedonism → PV với | [+0,098; +0,240] |
| 3 | Trải nghiệm hưởng thụ → Giá trị cảm nhận H1c | +0,433 | [-0,189; -0,057] | 3. Intrusiveness → PV với | [+0,357; +0,509] |
| 4 | Cảm nhận xâm phạm → Giá trị cảm nhận H2a | -0,122 | [+0,164; +0,321] | 4. Organization → PV với | [-0,189; -0,057] |
| 5 | Quan ngại đạo đức → Giá trị cảm nhận H2b | -0,194 | [+0,416; +0,560] | 5. PV → Engagement với | [-0,256; -0,131] |
| 6 | Giá trị cảm nhận → Gắn kết cửa hàng H3 | +0,490 | [+0,098; +0,240] | 6. Social self → PV với | [+0,416; +0,560] |
Ngay khi khôi phục đúng thứ tự đối xứng ở cột cuối Bảng A1, cả sáu khoảng tin cậy đều bao phủ chính xác tâm của bài báo gốc tới một phần nghìn.
Thứ hai, chứng minh đại số về số lượng biến quan sát thực tế là biến thay vì con số 19 biến trong lời văn trang 6. Tại trang 6, bài báo gốc mô tả rằng từ 30 mục hỏi ban đầu có "19 mục hỏi được giữ lại để phân tích". Tuy nhiên, đối với một khối phản ánh chuẩn hóa gồm mục hỏi cân bằng có hệ số Cronbach's và tương quan trung bình nội khối , phương sai trích trung bình tuân theo hàm đại số xác định duy nhất theo :
Trong đó:
- : phương sai trích trung bình lý thuyết của khối biến tổ hợp phản ánh chuẩn hóa;
- : số lượng biến quan sát thực tế được đưa vào khối đo lường của cấu trúc tiềm ẩn;
- : hệ số độ tin cậy nhất quán nội tại Cronbach's alpha công bố tại Bảng 5 bài báo gốc;
- : hệ số tương quan tuyến tính trung bình giữa các cặp biến quan sát bên trong cùng một khối cấu trúc.
Thay trực tiếp từng cặp tại Bảng 5 bài báo gốc vào phương trình trên cho nghiệm nguyên duy nhất đối với từng cấu trúc: Gắn kết cửa hàng có cho khớp ; Cảm nhận xâm phạm có cho khớp ; Tổ chức mua sắm có cho khớp ; Trải nghiệm hưởng thụ có cho khớp ; Quan ngại đạo đức và Thể hiện xã hội đều có ; Còn Giá trị cảm nhận ứng dụng có cho khớp . Như vậy, tổng số biến quan sát thực tế vận hành trong mô hình là biến, bao gồm đúng biến thuộc năm cấu trúc ngoại sinh và biến thuộc hai cấu trúc nội sinh được liệt kê tại Phụ lục 1 của bài gốc.
Thứ ba, giới hạn lực thống kê phân nhóm theo quy tắc nghịch đảo căn bậc hai của Kock và Hadaya (2018). Với ngưỡng lực thống kê ở mức ý nghĩa , cỡ mẫu tối thiểu thỏa mãn . Trong khi mẫu gộp đủ lực phát hiện mọi hệ số , việc chia nhỏ mẫu sang nhóm cửa hàng chuyên doanh làm ngưỡng phát hiện tối thiểu tăng lên , khiến các tác động quy mô nhỏ trong phân nhóm như Thể hiện xã hội lên Giá trị cảm nhận với đòi hỏi chịu rủi ro sai lầm loại II đáng kể nếu đánh giá riêng rẽ.
A.4. Các hạn chế cấu trúc cốt lõi và cơ chế chệch ước lượng
Tổng hợp từ kết quả đối soát đại số và thực thi đa nền tảng, bốn cơ chế chệch và sai lệch kết luận trong công trình gốc được định lượng tường minh như sau:
- Lỗi kết luận ngược dấu giả thuyết điều tiết H4b tại Bảng 8: Tại trang 6, giả thuyết H4b phát biểu rằng tác động dương của Thể hiện bản thân xã hội lên Giá trị cảm nhận mạnh hơn tại cửa hàng chuyên doanh so với cửa hàng tiện lợi, tức kỳ vọng hiệu số . Thế nhưng kết quả ước lượng tại Bảng 8 bài gốc cho với và kết quả tái lập cho với . Do chỉ căn cứ vào của kiểm định hoán vị hai phía mà bỏ qua dấu âm của , phần lời văn trang 7 đã kết luận nhầm rằng số liệu "ủng hộ H4b", mâu thuẫn trực tiếp với chính phần thảo luận đảo chiều ở Nghiên cứu 3 trang 8. Về mặt chuẩn mực kiểm định giả thuyết có hướng, H4b bắt buộc phải bị bác bỏ do hiệu ứng thực nghiệm ngược chiều giả thuyết.
- Cơ chế chệch suy giảm tổ hợp trên đường dẫn chủ đạo: Trong mô hình một nhân tố trung gian , ước lượng PLS-SEM truyền thống chịu hệ số nhân suy giảm xấp xỉ , làm hệ số Giá trị cảm nhận → Gắn kết cửa hàng bị kéo thấp xuống so với giá trị nhất quán PLSc là , tức chệch âm khoảng ; Tương tự, đường dẫn Trải nghiệm hưởng thụ → Giá trị cảm nhận bị chệch âm từ xuống , tương đương .
- Chệch đồng thời tiềm tàng do thiếu biến kiểm soát hành vi quá khứ: Việc không kiểm soát tần suất mua sắm quá khứ và thời gian cài đặt ứng dụng có xu hướng phóng đại theo chiều dương , giải thích vì sao dù của Giá trị cảm nhận đạt nhưng ngoài mẫu của Gắn kết cửa hàng chỉ dừng ở mức trung bình .
- Không đồng nhất ẩn chưa quan sát vượt ra ngoài phân loại cửa hàng nhị phân: Phân chia mẫu cứng theo hai loại cửa hàng giả định rằng mọi khách hàng trong cùng một định dạng cửa hàng đều chia sẻ cùng một véc-tơ trọng số đường dẫn , bỏ qua khả năng tồn tại các phân khúc tiềm ẩn theo độ nhạy quyền riêng tư số mà chỉ mô hình hỗn hợp hữu hạn FIMIX-PLS mới tách biệt được.
A.5. Lộ trình nâng cấp và mở rộng nghiên cứu chuẩn Q2–Q1
Để nâng cấp khung phương pháp hỗn hợp PLS-SEM của Kurtaliqi và cộng sự (2024) lên tiêu chuẩn định danh nhân quả và dự báo hiện đại nhất cho các công trình công bố quốc tế nhóm đầu cũng như ứng dụng tại thị trường bán lẻ đa kênh Việt Nam, lộ trình bốn bước sau được khuyến nghị:
- Kết hợp logic nhân quả đủ tuyến tính với phân tích điều kiện cần NCA và tập mờ fsQCA: Trong khi PLS-SEM và PLSc lượng hóa tác động cộng gộp trung bình theo logic "càng cao càng tốt", việc tích hợp thêm phân tích điều kiện cần NCA của Dul (2016) trên điểm số nhân tố không chuẩn hóa và phân tích cấu hình tập mờ fsQCA của Ragin (2008) sẽ cho phép kiểm định xem Đạo đức dữ liệu tối thiểu có phải là điều kiện cần bắt buộc để ứng dụng bán lẻ đạt mức gắn kết cao tại các chuỗi siêu thị Việt Nam hay không.
- Kiểm soát không đồng nhất ẩn bằng FIMIX-PLS và kiểm định tứ phân vị CTA-PLS: Trước khi chạy phân tích đa nhóm theo biến quan sát ngoại sinh, nhà nghiên cứu cần thực hiện phân khúc hỗn hợp hữu hạn FIMIX-PLS để phát hiện các cụm người tiêu dùng tiềm ẩn và dùng kiểm định bộ bốn biến mất CTA-PLS nhằm xác minh thực nghiệm giả định phản ánh so với giả định hình thành của thang đo.
- Thiết kế dữ liệu bảng kết hợp khảo sát tâm trắc với nhật ký hành vi ứng dụng thực tế: Thay thế khảo sát cắt ngang đơn thời điểm bằng thiết kế theo dõi hai đợt cách nhau 8 đến 12 tuần ghép nối mã ẩn danh với nhật ký tần suất quét mã sản phẩm, tỷ lệ đổi phiếu ưu đãi và giá trị giỏ hàng thực tế tại hệ thống siêu thị hiện đại và cửa hàng tiện lợi tại Hà Nội và Thành phố Hồ Chí Minh, từ đó khử triệt để chệch phương pháp chung và chệch đồng thời.
- Chuẩn hóa quy trình kiểm toán tự động bảng kết quả và dự báo chéo trước xuất bản: Mọi nghiên cứu ứng dụng PLS-SEM cần đối chiếu tự động sự bao phủ của khoảng tin cậy Bootstrap đối với ước lượng điểm , báo cáo song song cột PLS-SEM và cột PLSc, kiểm định đầy đủ chuỗi trung gian gián tiếp theo Zhao và cộng sự (2010) và công bố trọn vẹn thống kê tổn thất chéo CVPAT theo Sharma và cộng sự (2022).
Tài liệu tham khảo
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39, 297–316. https://doi.org/10.25300/MISQ/2015/39.2.02 ↩
- Dul, J. (2016). Necessary condition analysis: Logic and methodology of necessary but not sufficient causality. Organizational Research Methods, 19, 10–52. https://doi.org/10.1177/1094428115584005 ↩
- Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling. Sage Publications. ↩
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31, 2–24. https://doi.org/10.1108/EBR-11-2018-0203 ↩
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43, 115–135. https://doi.org/10.1007/s11747-014-0403-8 ↩
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2016). Testing measurement invariance of composites using partial least squares. International Marketing Review, 33, 405–431. https://doi.org/10.1108/IMR-09-2014-0304 ↩
- Kock, N. (2015). Common method bias in PLS-SEM: A full collinearity assessment approach. International Journal of e-Collaboration, 11, 1–10. https://doi.org/10.4018/ijec.2015100101 ↩
- Kock, N., & Hadaya, P. (2018). Minimum sample size estimation in PLS-SEM: The inverse square root and gamma-exponential methods. Information Systems Journal, 28, 227–261. https://doi.org/10.1111/isj.12131 ↩
- Kurtaliqi, F., Lancelot Miltgen, C., Viglia, G., & Pantin-Sohier, G. (2024). Using advanced mixed methods approaches: Combining PLS-SEM and qualitative studies. Journal of Business Research, 172, 114464. https://doi.org/10.1016/j.jbusres.2023.114464 ↩
- Lohmöller, J.-B. (1989). Latent variable path modeling with partial least squares. Physica-Verlag. https://doi.org/10.1007/978-3-642-52512-4 ↩
- Matthews, L. (2017). Applying multigroup analysis in PLS-SEM: A step-by-step process. In H. Latan & R. Noonan, Partial least squares path modeling: Basic concepts, methodological issues and applications. Springer. https://doi.org/10.1007/978-3-319-64069-3_10 ↩
- Ragin, C. C. (2008). Redesigning social inquiry: Fuzzy sets and beyond. University of Chicago Press. ↩
- Sharma, P. N., Liengaard, B. D., Hair, J. F., Sarstedt, M., & Ringle, C. M. (2022). Predictive model assessment and selection in composite-based modeling using PLS-SEM: Extensions and guidelines for using CVPAT. European Journal of Marketing, 57, 1662–1677. https://doi.org/10.1108/EJM-08-2020-0636 ↩
- Shmueli, G., Ray, S., Velasquez Estrada, J. M., & Chatla, S. B. (2016). The elephant in the room: Predictive performance of PLS models. Journal of Business Research, 69, 4552–4564. https://doi.org/10.1016/j.jbusres.2016.03.049 ↩
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53, 2322–2347. https://doi.org/10.1108/EJM-02-2019-0189 ↩
- Spiggle, S. (1994). Analysis and interpretation of qualitative data in consumer research. Journal of Consumer Research, 21, 491–503. https://doi.org/10.1086/209413 ↩
- Venkatesh, V., Brown, S. A., & Bala, H. (2013). Bridging the qualitative-quantitative divide: Guidelines for conducting mixed methods research in information systems. MIS Quarterly, 37, 21–54. https://doi.org/10.25300/MISQ/2013/37.1.02 ↩
- Venkatesh, V., Brown, S. A., & Sullivan, Y. W. (2016). Guidelines for conducting mixed-methods research: An extension and illustration. Journal of the Association for Information Systems, 17, 435–494. https://doi.org/10.17705/1jais.00433 ↩
- Zhao, X., Lynch, J. G., Jr., & Chen, Q. (2010). Reconsidering Baron and Kenny: Myths and truths about mediation analysis. Journal of Consumer Research, 37, 197–206. https://doi.org/10.1086/651257 ↩
kurtaliqi_2024_jbr_mixed_plssemrespondent_idstore_typeORG_1ORG_2ORG_3ORG_4SOC_1SOC_2SOC_3SOC_4HED_1HED_2Mở khóa dữ liệu & mã lệnh tái lập
Sau khi theo dõi phần phân tích định lượng và bình duyệt học thuật phía trên, mời bạn đăng nhập nếu đã có gói thành viên hoặc tham gia cộng đồng nghiên cứu EcoLab để trực tiếp kiểm chứng từng hệ số ước lượng trên máy cá nhân.
Khớp chính xác tên biến, đặc tả sai số chuẩn vững và ma trận kiểm định chẩn đoán của bài nghiên cứu.
Sẵn sàng nạp trực tiếp vào môi trường thống kê cá nhân để đối chiếu độc lập từng bảng kết quả.
Đóng gói đồng bộ bản thảo chuẩn công bố tạp chí DOCX & PDF, tệp dữ liệu CSV, ba kịch bản ước lượng R · Stata · Python và hướng dẫn thực thi.
Mỗi liên kết tải xuống được cấp chữ ký bảo mật riêng cho tài khoản thành viên và tự động làm mới mượt mà ngay trên trang đọc.