Phương pháp luận trọng số mẫu khảo sát phức hợp trong dữ liệu vi mô VHLSS: Cơ sở lý thuyết, kiểm định ngoại sinh và bằng chứng thực nghiệm giai đoạn 2014–2024
1. Đặt vấn đề và cơ sở lý thuyết của trọng số trong khảo sát chọn mẫu phức hợp
1.1. Thiết kế chọn mẫu hai giai đoạn phân tầng của khảo sát mức sống dân cư Việt Nam
Khác với giả định chọn mẫu ngẫu nhiên đơn giản độc lập và phân phối đồng nhất trong lý thuyết kinh tế lượng cổ điển, Khảo sát Mức sống Dân cư Việt Nam do GSO (2025) thực hiện định kỳ hai năm một lần dựa trên Khung mẫu chủ từ Tổng điều tra Dân số và Nhà ở các năm 2009 và 2019. Thiết kế chọn mẫu tuân thủ cấu trúc chọn mẫu cụm hai giai đoạn có phân tầng rõ rệt theo Deaton (1997):
- Phân tầng thiết kế: Toàn bộ tổng thể hộ gia đình Việt Nam được chia thành tỉnh, thành phố trực thuộc Trung ương nhân với khu vực Thành thị và Nông thôn, tạo thành tầng mẫu độc lập. Để bảo đảm mỗi địa phương cấp tỉnh đều đủ cỡ mẫu ước lượng các chỉ tiêu kinh tế – xã hội với sai số tương đối trong ngưỡng kiểm soát, cơ quan thống kê áp dụng quy tắc phân bổ lũy thừa căn bậc hai theo Kish (1965) dưới dạng với thay vì phân bổ tỷ lệ tuyến tính với dân số. Hệ quả trực tiếp là các tỉnh miền núi phía Bắc và Tây Nguyên có xác suất chọn mẫu cao gấp đến lần so với hai siêu đô thị Hà Nội và Thành phố Hồ Chí Minh.
- Giai đoạn 1 — Chọn Đơn vị mẫu sơ cấp PSU: Trong mỗi tầng , các địa bàn điều tra được định danh bởi bộ khóa bốn cấp
tinh - huyen - xa - diabanvà được rút mẫu theo xác suất tỷ lệ với quy mô số hộ gia đình. Toàn quốc duy trì khoảng đến địa bàn điều tra gốc trong mỗi kỳ khảo sát. - Giai đoạn 2 — Chọn Đơn vị mẫu thứ cấp SSU: Trong mỗi địa bàn điều tra được chọn, hộ gia đình được rút ngẫu nhiên hệ thống để phỏng vấn bảng hỏi thu nhập – nhân khẩu học tạo thành mẫu quy mô khoảng – hộ đi kèm hệ trọng số
wt45, trong đó hộ được chọn phỏng vấn sâu bảng hỏi chi tiêu đầy đủ tạo thành phân mẫu khoảng – hộ đi kèm hệ trọng sốwt9.
Nếu ký hiệu là xác suất chọn địa bàn thuộc tầng ở giai đoạn đầu và là xác suất chọn hộ trong địa bàn ở giai đoạn hai, xác suất chọn gộp của hộ là . Trọng số thiết kế cơ sở là nghịch đảo xác suất chọn mẫu sau khi hiệu chỉnh hao hụt không trả lời và cân chỉnh hậu phân tầng theo quy mô dân số thực tế của từng tầng:
Trong đó:
- : xác suất chọn hộ tại địa bàn điều tra gốc thuộc tầng ;
- : hệ số hiệu chỉnh hao hụt không trả lời tại địa bàn;
- : nhân tử cân chỉnh hậu phân tầng theo tổng thể dân số.
Mỗi giá trị đo lường số lượng hộ gia đình trong tổng thể dân cư Việt Nam mà hộ mẫu đại diện. Kiểm chứng trên kỳ khảo sát năm 2022 cho thấy tổng trọng số triệu hộ trên mẫu hộ và triệu hộ trên mẫu chi tiêu hộ, phản ánh nhất quán tổng số hộ dân cư toàn quốc theo GSO (2025).
1.2. Ước lượng Horvitz–Thompson, Hájek và sự khác biệt bản chất giữa bốn hệ trọng số
Để ước lượng tổng của tổng thể hữu hạn và trung bình tổng thể từ mẫu khảo sát , ước lượng tổng không chệch theo thiết kế của Horvitz & Thompson (1952) cùng ước lượng trung bình tỷ số bất biến theo phép tịnh tiến của Hájek (1971) được xác định bởi:
Trong thực hành kinh tế lượng vi mô, việc phân biệt rạch ròi bốn cơ chế trọng số trong các phần mềm thống kê có ý nghĩa quyết định đối với tính hợp lệ của suy diễn tiệm cận theo Pfeffermann (1993) và Wooldridge (2010):
| Loại trọng số | Khai báo chuẩn trong Stata / R | Giả định thống kê cốt lõi | Tác động lên hệ số và sai số chuẩn | Quy tắc áp dụng cho dữ liệu VHLSS |
|---|---|---|---|---|
| Probability / Sampling Weight | Stata: [pw=wt45], svyset [pw=wt45]; R: svydesign(weights=~wt45) | là nghịch đảo xác suất chọn mẫu từ tổng thể hữu hạn phân tầng cụm. | cực tiểu hóa ; tính bằng chuỗi Taylor bậc nhất gom cụm PSU, bất biến khi nhân hằng số . | Chuẩn bắt buộc duy nhất cho phân tích vi mô cấp hộ gia đình và cá nhân khi gắn trọng số. |
| Analytic Weight | Stata: [aw=n_cell]; R: lm(..., weights=n_cell) | Quan sát là trung bình cộng của cá thể độc lập có phương sai . | Cho cùng điểm ước lượng với pweight trong hồi quy tuyến tính, nhưng chệch nghiêm trọng phương sai nếu nhiễu không tỷ lệ nghịch với . | Không dùng cho dữ liệu vi mô hộ hay cá nhân; Chỉ dùng khi hồi quy trung bình ô cấp tỉnh hoặc ngành. |
| Frequency Weight | Stata: [fw=wt45] | Nhân bản vật lý mỗi dòng dữ liệu thành đúng quan sát độc lập, nâng cỡ mẫu giả tạo lên . | Thu hẹp sai số chuẩn giả tạo cỡ lần, làm sai lệch hoàn toàn kiểm định . | Tuyệt đối nghiêm cấm trên mọi cuộc khảo sát chọn mẫu hộ gia đình. |
| Importance Weight | Stata: [iw=w] | Quyền số thuật toán thuần túy trong tối ưu hóa số học, không mang cấu trúc xác suất chọn mẫu. | Ma trận hiệp phương sai không có ý nghĩa suy diễn thống kê. | Không bao giờ sử dụng cho suy diễn thực nghiệm. |
1.3. Phương sai chuỗi Taylor gom cụm PSU và hiệu ứng trọng số không đều Kish UWE
Các hộ gia đình cư trú trong cùng một địa bàn điều tra PSU cùng chia sẻ điều kiện tự nhiên, kết cấu hạ tầng, thị trường lao động địa phương và mặt bằng giá cả sinh hoạt, tạo ra tương quan nội cụm dương như phân tích của Cameron & Miller (2015) và Abadie et al. (2023). Với thiết kế tầng và địa bàn PSU trong tầng , phương sai xấp xỉ chuỗi Taylor bậc nhất của nghiệm hệ phương trình ước lượng tổng quát theo Wooldridge (1999, 2001) có dạng ma trận kẹp Sandwich gom cụm tại cấp địa bàn PSU:
trong đó là tổng điểm số có trọng số gom tại địa bàn gốc . Công thức trên chỉ ra hai cơ chế làm tăng phương sai so với mẫu ngẫu nhiên đơn giản:
- Hiệu ứng gom cụm không gian: Hệ số phóng đại xuất hiện ngay cả khi các quan sát có trọng số bằng nhau miễn là phần dư tương quan nội địa bàn.
- Hiệu ứng trọng số không đều của Kish (1965): Khi phương sai nhiễu đồng nhất và hàm kỳ vọng có điều kiện được định dạng đúng, sự phân tán của trọng số làm tăng phương sai ước lượng theo hệ số và làm giảm cỡ mẫu hiệu dụng :
trong đó là hệ số biến thiên của trọng số mẫu. Khi trọng số biến thiên mạnh giữa vùng núi thưa dân và các đô thị nén, chỉ số lượng hóa trực tiếp chi phí phương sai phải đánh đổi để bảo đảm tính nhất quán theo thiết kế.
1.4. Tổng hợp sự đánh đổi giữa ưu điểm và nhược điểm của trọng số khảo sát
2. Phân rã thực nghiệm phân phối trọng số và độ chệch mô tả trên VHLSS 2014–2024
2.1. Phân phối trọng số wt9, wt45 và cỡ mẫu hiệu dụng Kish qua sáu kỳ khảo sát
Bảng 2 tổng hợp các tham số phân phối trọng số, tỷ số cực trị , hệ số biến thiên , chỉ số Kish và tỷ lệ hiệu suất cỡ mẫu được tính toán trực tiếp từ sáu kỳ VHLSS liên tiếp giai đoạn 2014–2024.
| Kỳ VHLSS | Hệ trọng số và phân hệ mẫu | Số hộ | Số cụm PSU | Tổng (triệu hộ) | Trung bình | Trung vị | Kish | Hiệu suất (%) | |||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 2014 | wt9 — Mẫu chi tiêu 5 mục | 9,399 | 3,133 | 24.008 | 2,554.4 | 2,338.0 | 30.4 | 0.4200 | 1.1764 | 7,990 | 85.00% |
| 2014 | wt45 — Trọng số địa bàn trên tệp 9k | 9,399 | 3,133 | 4.802 | 510.9 | 468.0 | 30.2 | 0.4200 | 1.1764 | 7,990 | 85.01% |
| 2016 | wt9 — Mẫu chi tiêu 5 mục | 9,399 | 3,133 | 25.071 | 2,667.4 | 2,343.0 | 86.8 | 0.5394 | 1.2909 | 7,281 | 77.46% |
| 2018 | wt9 — Mẫu chi tiêu 5 mục | 9,168 | 3,056 | 25.209 | 2,749.6 | 2,389.5 | 87.9 | 0.5553 | 1.3084 | 7,007 | 76.43% |
| 2018 | wt45 — Mẫu thu nhập đầy đủ 45k | 45,839 | 3,056 | 25.208 | 549.9 | 478.0 | 87.9 | 0.5553 | 1.3084 | 35,036 | 76.43% |
| 2020 | wt9 — Mẫu chi tiêu 5 mục | 9,389 | 3,130 | 26.742 | 2,848.2 | 2,542.0 | 29.0 | 0.4889 | 1.2391 | 7,577 | 80.71% |
| 2022 | wt9 — Mẫu chi tiêu 5 mục | 9,382 | 3,133 | 26.956 | 2,873.1 | 2,483.0 | 100.4 | 0.6210 | 1.3856 | 6,771 | 72.17% |
| 2022 | wt45 — Mẫu thu nhập đầy đủ 45k | 46,995 | 3,133 | 27.008 | 574.7 | 497.0 | 100.8 | 0.6209 | 1.3855 | 33,920 | 72.18% |
| 2024 | wt9 — Mẫu chi tiêu 5 mục | 9,399 | 3,133 | 28.672 | 3,050.6 | 2,664.0 | 106.1 | 0.5267 | 1.2774 | 7,358 | 78.28% |
Ghi chú: Tính toán từ dữ liệu trọng số gốc các kỳ 2014–2024 theo GSO (2025). Trên cùng một địa bàn điều tra, do mỗi địa bàn chọn 3 hộ chi tiêu so với 15 hộ thu nhập.
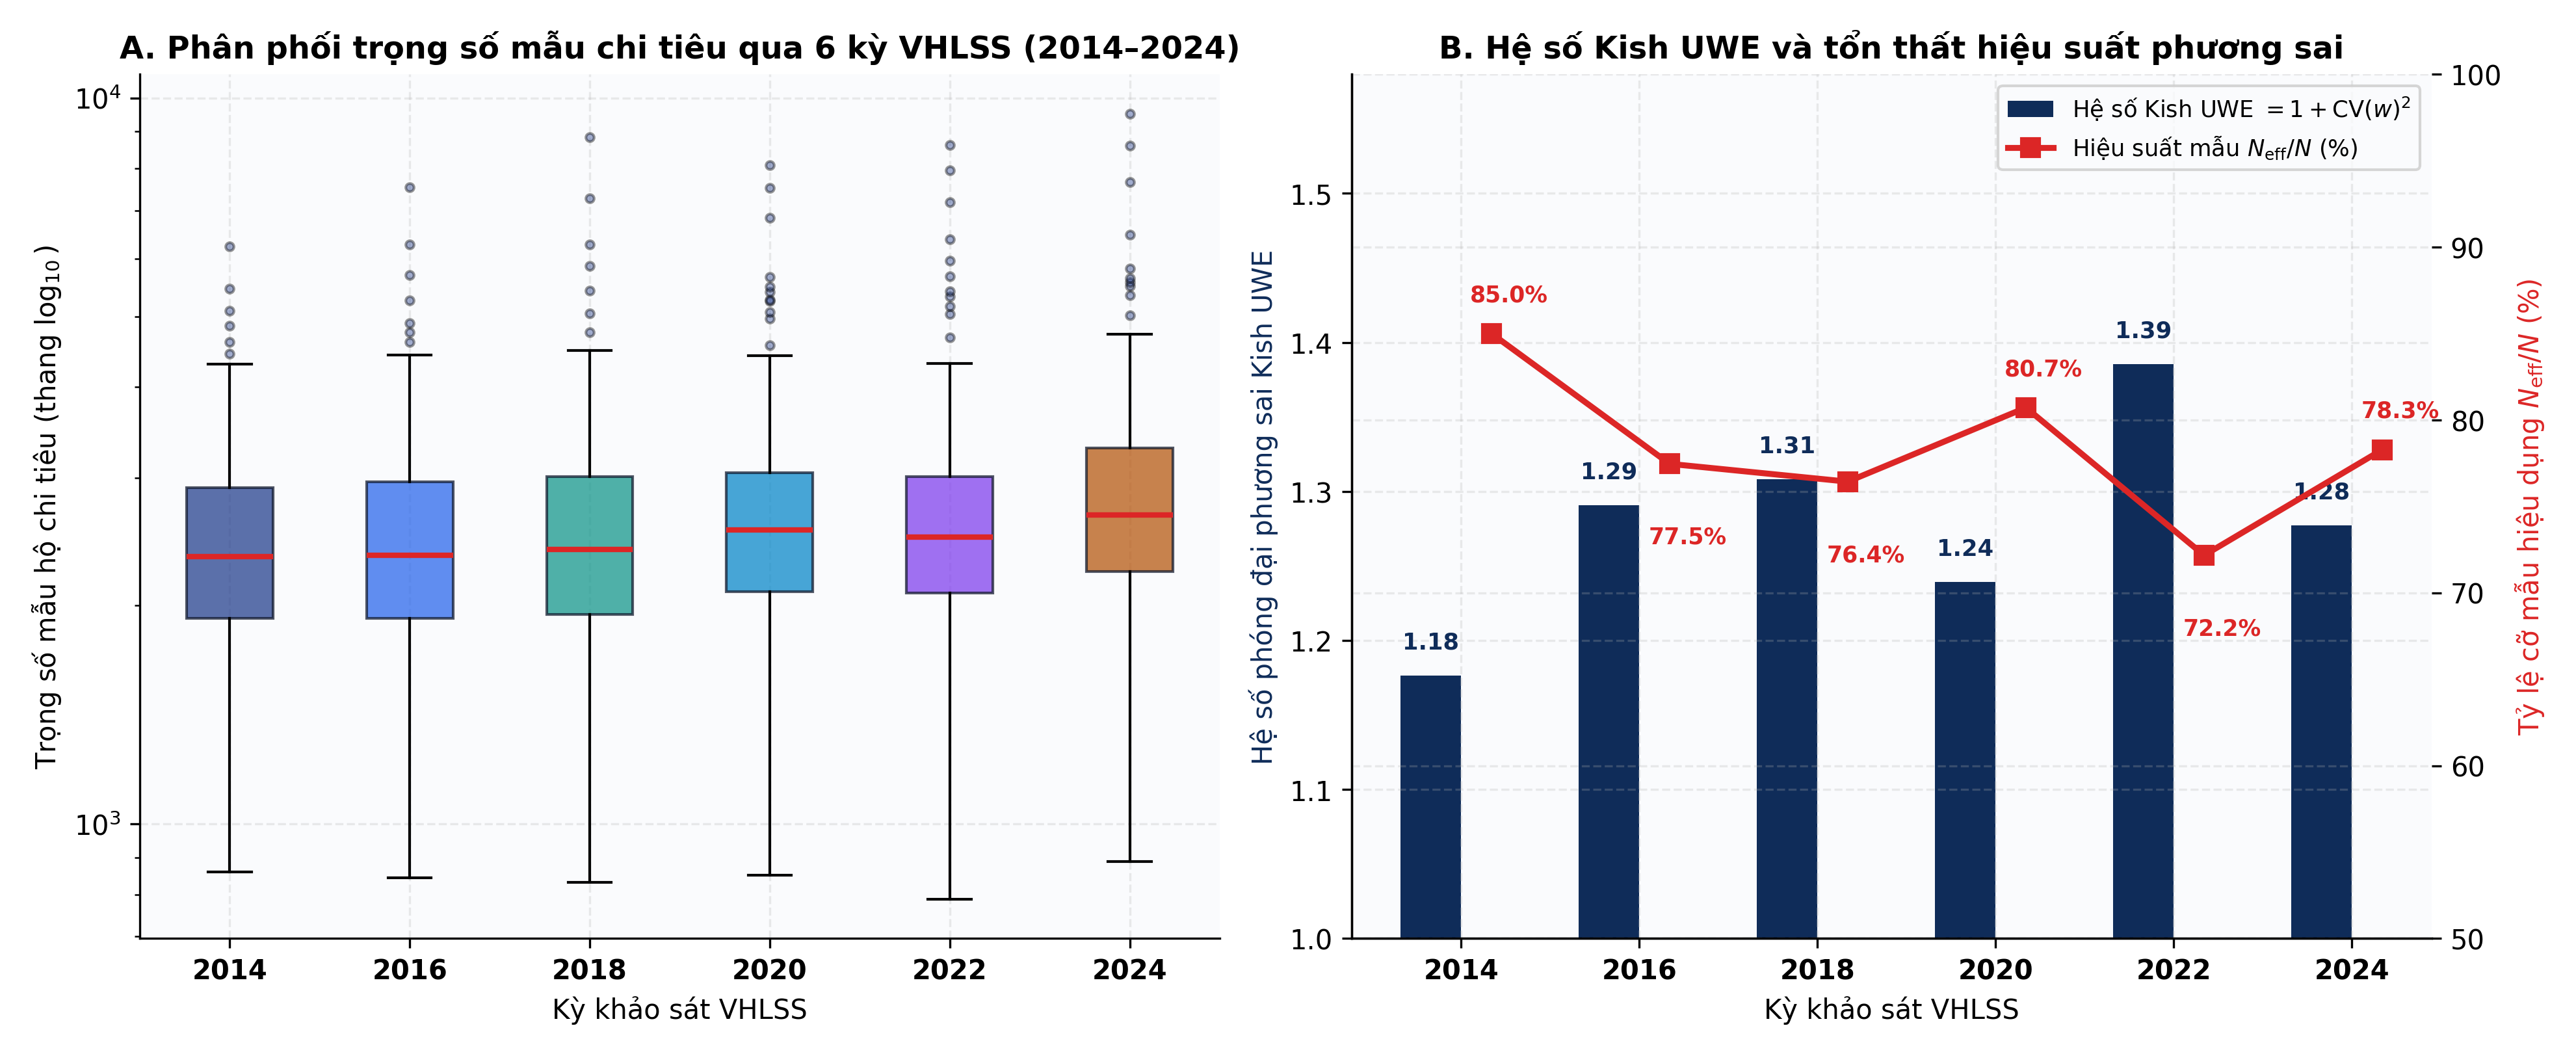
Hai quy luật thực nghiệm quan trọng nổi lên từ Bảng 2 và Hình 1:
- Chu kỳ lão hóa và cập nhật Khung mẫu chủ thể hiện trực tiếp qua chỉ số Kish (1965): Tại các kỳ khảo sát nằm sát năm Tổng điều tra Dân số và Nhà ở như năm 2014 và năm 2020, độ phân tán trọng số ở mức thấp nhất với năm 2014 và năm 2020, tỷ số –, giúp hiệu suất cỡ mẫu đạt –. Khi khoảng cách thời gian xa dần kỳ Tổng điều tra hoặc sau làn sóng dịch chuyển dân cư hậu đại dịch COVID-19 giai đoạn 2022–2024, hệ số hiệu chỉnh hậu phân tầng giữa các đô thị nhập cư và các tỉnh xuất cư giãn rộng, đẩy tỷ số vượt ngưỡng lần và đưa lên mức đỉnh vào năm 2022. Khi đó, mẫu hộ thực tế có hiệu quả phương sai tương đương hộ ngẫu nhiên đơn giản.
- Tính bất biến tỷ lệ : Do phép nhân hằng số dương bị giản ước trong công thức trung bình Hájek (1971) và phương trình bình phương tối thiểu có trọng số, chỉ số và của
wt9vàwt45là đồng nhất. Tuy nhiên, phân tích trên phân mẫu chi tiêu 5 mục bắt buộc dùngwt9để bảo toàn quy mô tổng thể – triệu hộ, trong khi phân tích trên mẫu thu nhập – nhân khẩu học đầy đủ bắt buộc dùngwt45.
2.2. Định lượng độ chệch khi bỏ qua trọng số trong thống kê phúc lợi, nghèo đói và bất bình đẳng
Bảng 3 đối chiếu kết quả ước lượng không trọng số so với ước lượng có trọng số thiết kế wt9 gom cụm tại PSU trên các chỉ tiêu phúc lợi cốt lõi đã quy đổi về giá thực cố định năm 2020, bao gồm tỷ lệ nghèo FGT0 theo công thức Foster, Greer & Thorbecke (1984) và hệ số bất bình đẳng Gini.
| Kỳ | Thu nhập thực BQĐN không TS | Thu nhập thực BQĐN có TS và SE PSU | Độ chệch thu nhập (%) | Chi tiêu thực BQĐN không TS | Chi tiêu thực BQĐN có TS và SE PSU | Độ chệch chi tiêu (%) | Đô thị không TS / có TS (%) | DTTS không TS / có TS (%) | Nghèo FGT0 không TS / có TS (%) | Gini chi tiêu không TS / có TS |
|---|---|---|---|---|---|---|---|---|---|---|
| 2014 | 2,962.1 | 3,112.7 ± 42.0 | −4.84% | 2,326.4 | 2,422.1 ± 33.6 | −3.95% | 29.59 / 30.75 | 16.67 / 13.29 | 34.33 / 32.28 | 0.3474 / 0.3497 |
| 2016 | 3,383.9 | 3,574.0 ± 50.2 | −5.32% | 2,546.9 | 2,653.7 ± 35.7 | −4.03% | 30.10 / 31.50 | 17.19 / 14.62 | 29.86 / 28.22 | 0.3522 / 0.3547 |
| 2018 | 3,864.8 | 4,108.6 ± 59.3 | −5.93% | 2,799.2 | 2,939.7 ± 41.3 | −4.78% | 29.97 / 33.61 | 17.12 / 14.00 | 24.42 / 21.85 | 0.3578 / 0.3570 |
| 2020 | 5,707.5 | 6,545.9 ± 207.3 | −12.81% | 2,949.9 | 3,159.1 ± 39.8 | −6.62% | 32.81 / 37.40 | 16.35 / 11.92 | 20.24 / 17.16 | 0.3439 / 0.3401 |
| 2022 | 4,521.8 | 4,982.8 ± 67.5 | −9.25% | 2,604.6 | 2,793.2 ± 47.7 | −6.75% | 33.73 / 39.51 | 15.12 / 10.36 | 27.03 / 22.22 | 0.3548 / 0.3494 |
| 2024 | 4,798.9 | 5,218.9 ± 66.7 | −8.05% | 2,675.1 | 2,865.3 ± 32.4 | −6.64% | 34.02 / 39.74 | 15.40 / 10.88 | 22.25 / 18.27 | 0.3229 / 0.3159 |
Ghi chú: Đơn vị thu nhập và chi tiêu thực bình quân đầu người là nghìn đồng/người/tháng theo giá cố định năm 2020. Chỉ số nghèo FGT0 được tính theo ngưỡng chi tiêu thực cố định nghìn đồng/người/tháng nhân quy mô nhân khẩu hộ wt9 * hhsize để bảo đảm tính so sánh xuyên kỳ.
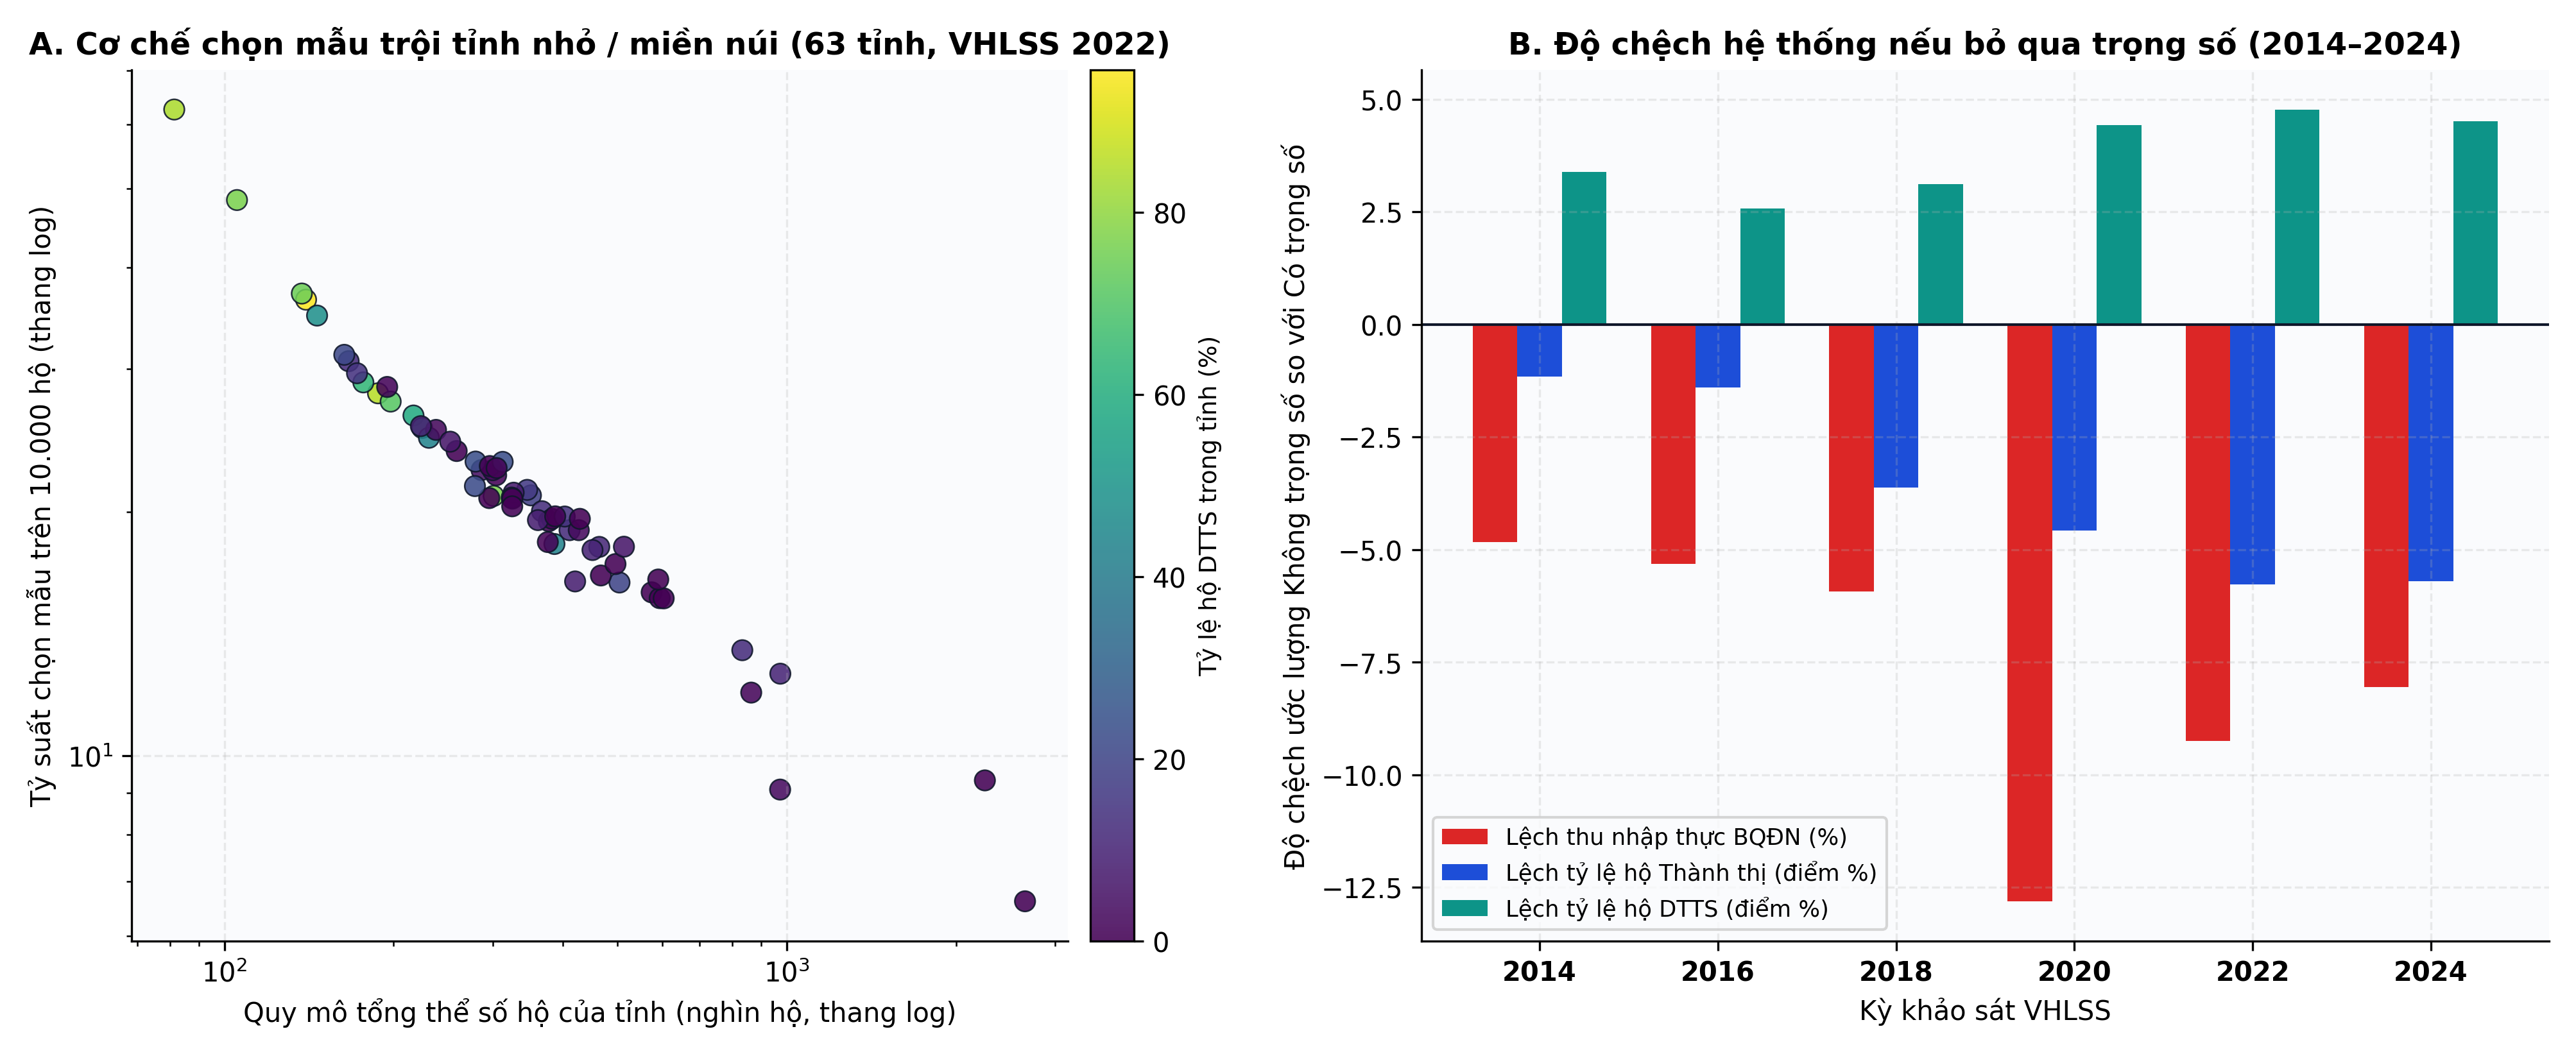
Phân rã dữ liệu cấp tỉnh năm 2022 trên Hình 2 giải thích tường minh căn nguyên cơ học của các độ chệch hệ thống trong Bảng 3:
- Tỉnh Bắc Kạn với quy mô tổng thể ước tính hộ, tỷ lệ dân tộc thiểu số và thu nhập bình quân nghìn đồng/tháng được khảo sát hộ, tương đương cường độ lấy mẫu hộ mẫu trên mỗi hộ dân cư. Tương tự, Lai Châu đạt hộ/ hộ dân cư và Điện Biên đạt hộ/ hộ dân cư.
- Ngược lại, Thành phố Hồ Chí Minh với quy mô hộ và thu nhập bình quân nghìn đồng/tháng có hộ mẫu, tương đương cường độ lấy mẫu chỉ hộ/ hộ dân cư; Bình Dương đạt hộ/ hộ; Và Hà Nội đạt hộ/ hộ.
Do trung bình cộng không trọng số gán quyền số ngang nhau cho một quan sát tại Bắc Kạn và một quan sát tại Thành phố Hồ Chí Minh, mọi thống kê mô tả bỏ qua trọng số trên VHLSS đều chệch hệ thống về phía nông thôn, miền núi và nhóm thu nhập thấp: đánh giá thấp tỷ lệ đô thị hóa năm 2022 tới điểm phần trăm, phóng đại tỷ lệ hộ dân tộc thiểu số thêm điểm phần trăm và phóng đại tỷ lệ nghèo FGT0 thêm điểm phần trăm.
3. Khi nào sử dụng trọng số trong hồi quy vi mô? Kiểm định ngoại sinh và ma trận quyết định chuẩn tắc
3.1. Khung chẩn đoán Solon–Haider–Wooldridge và kiểm định ngoại sinh DuMouchel–Duncan
Khác với thống kê mô tả quần thể, vai trò của trọng số trong hồi quy nhân quả phụ thuộc vào cơ chế sinh dữ liệu và đặc tả hàm kỳ vọng có điều kiện . Kế thừa Deaton (1997) và Wooldridge (1999, 2001), công trình chuẩn tắc của Solon, Haider & Wooldridge (2015) chứng minh ba mệnh đề nền tảng:
- Phương sai sai số thay đổi không phải là lý do hợp lệ để gắn trọng số thiết kế: Trọng số chọn mẫu phản ánh xác suất chọn địa bàn theo địa giới hành chính chứ không phản ánh nghịch đảo phương sai nhiễu . Khi giả định ngoại sinh thỏa mãn, ước lượng OLS không trọng số đi kèm sai số chuẩn gom cụm cấp PSU theo Cameron & Miller (2015) vừa nhất quán vừa đạt phương sai tiệm cận nhỏ hơn WLS.
- Tính ngoại sinh có điều kiện của thiết kế phân tầng địa lý: Trong VHLSS, tiêu chí phân tầng hoàn toàn dựa trên Tỉnh/Thành phố Thành thị/Nông thôn, không phân tầng theo biến kết quả nội sinh như thu nhập, tiền lương theo Mincer (1974) hay hành vi tiêu dùng. Do đó, khi vế phải phương trình hồi quy đã kiểm soát đầy đủ đặc trưng đô thị, vùng kinh tế – xã hội và cấu trúc nhân khẩu học, xác suất chọn mẫu trở nên ngoại sinh có điều kiện đối với sai số ngẫu nhiên.
- Tính không đồng nhất của tác động biên và sai lệch dạng hàm: Nếu độ co giãn hoặc tác động biên thực tế khác biệt giữa nông thôn miền núi và đô thị lớn nhưng mô hình chỉ ước lượng một tham số gộp duy nhất , ước lượng không trọng số sẽ nghiêng về khu vực lấy mẫu dày, trong khi WLS với
pweighthội tụ về tác động biên trung bình có quyền số dân số toàn quốc.
Để kiểm định chính thức giả thuyết trọng số ngoại sinh có điều kiện, DuMouchel & Duncan (1983) và Wooldridge (2010) thiết lập phương trình hồi quy mở rộng bổ sung trọng số chuẩn hóa cùng toàn bộ tích tương tác với véctơ biến giải thích :
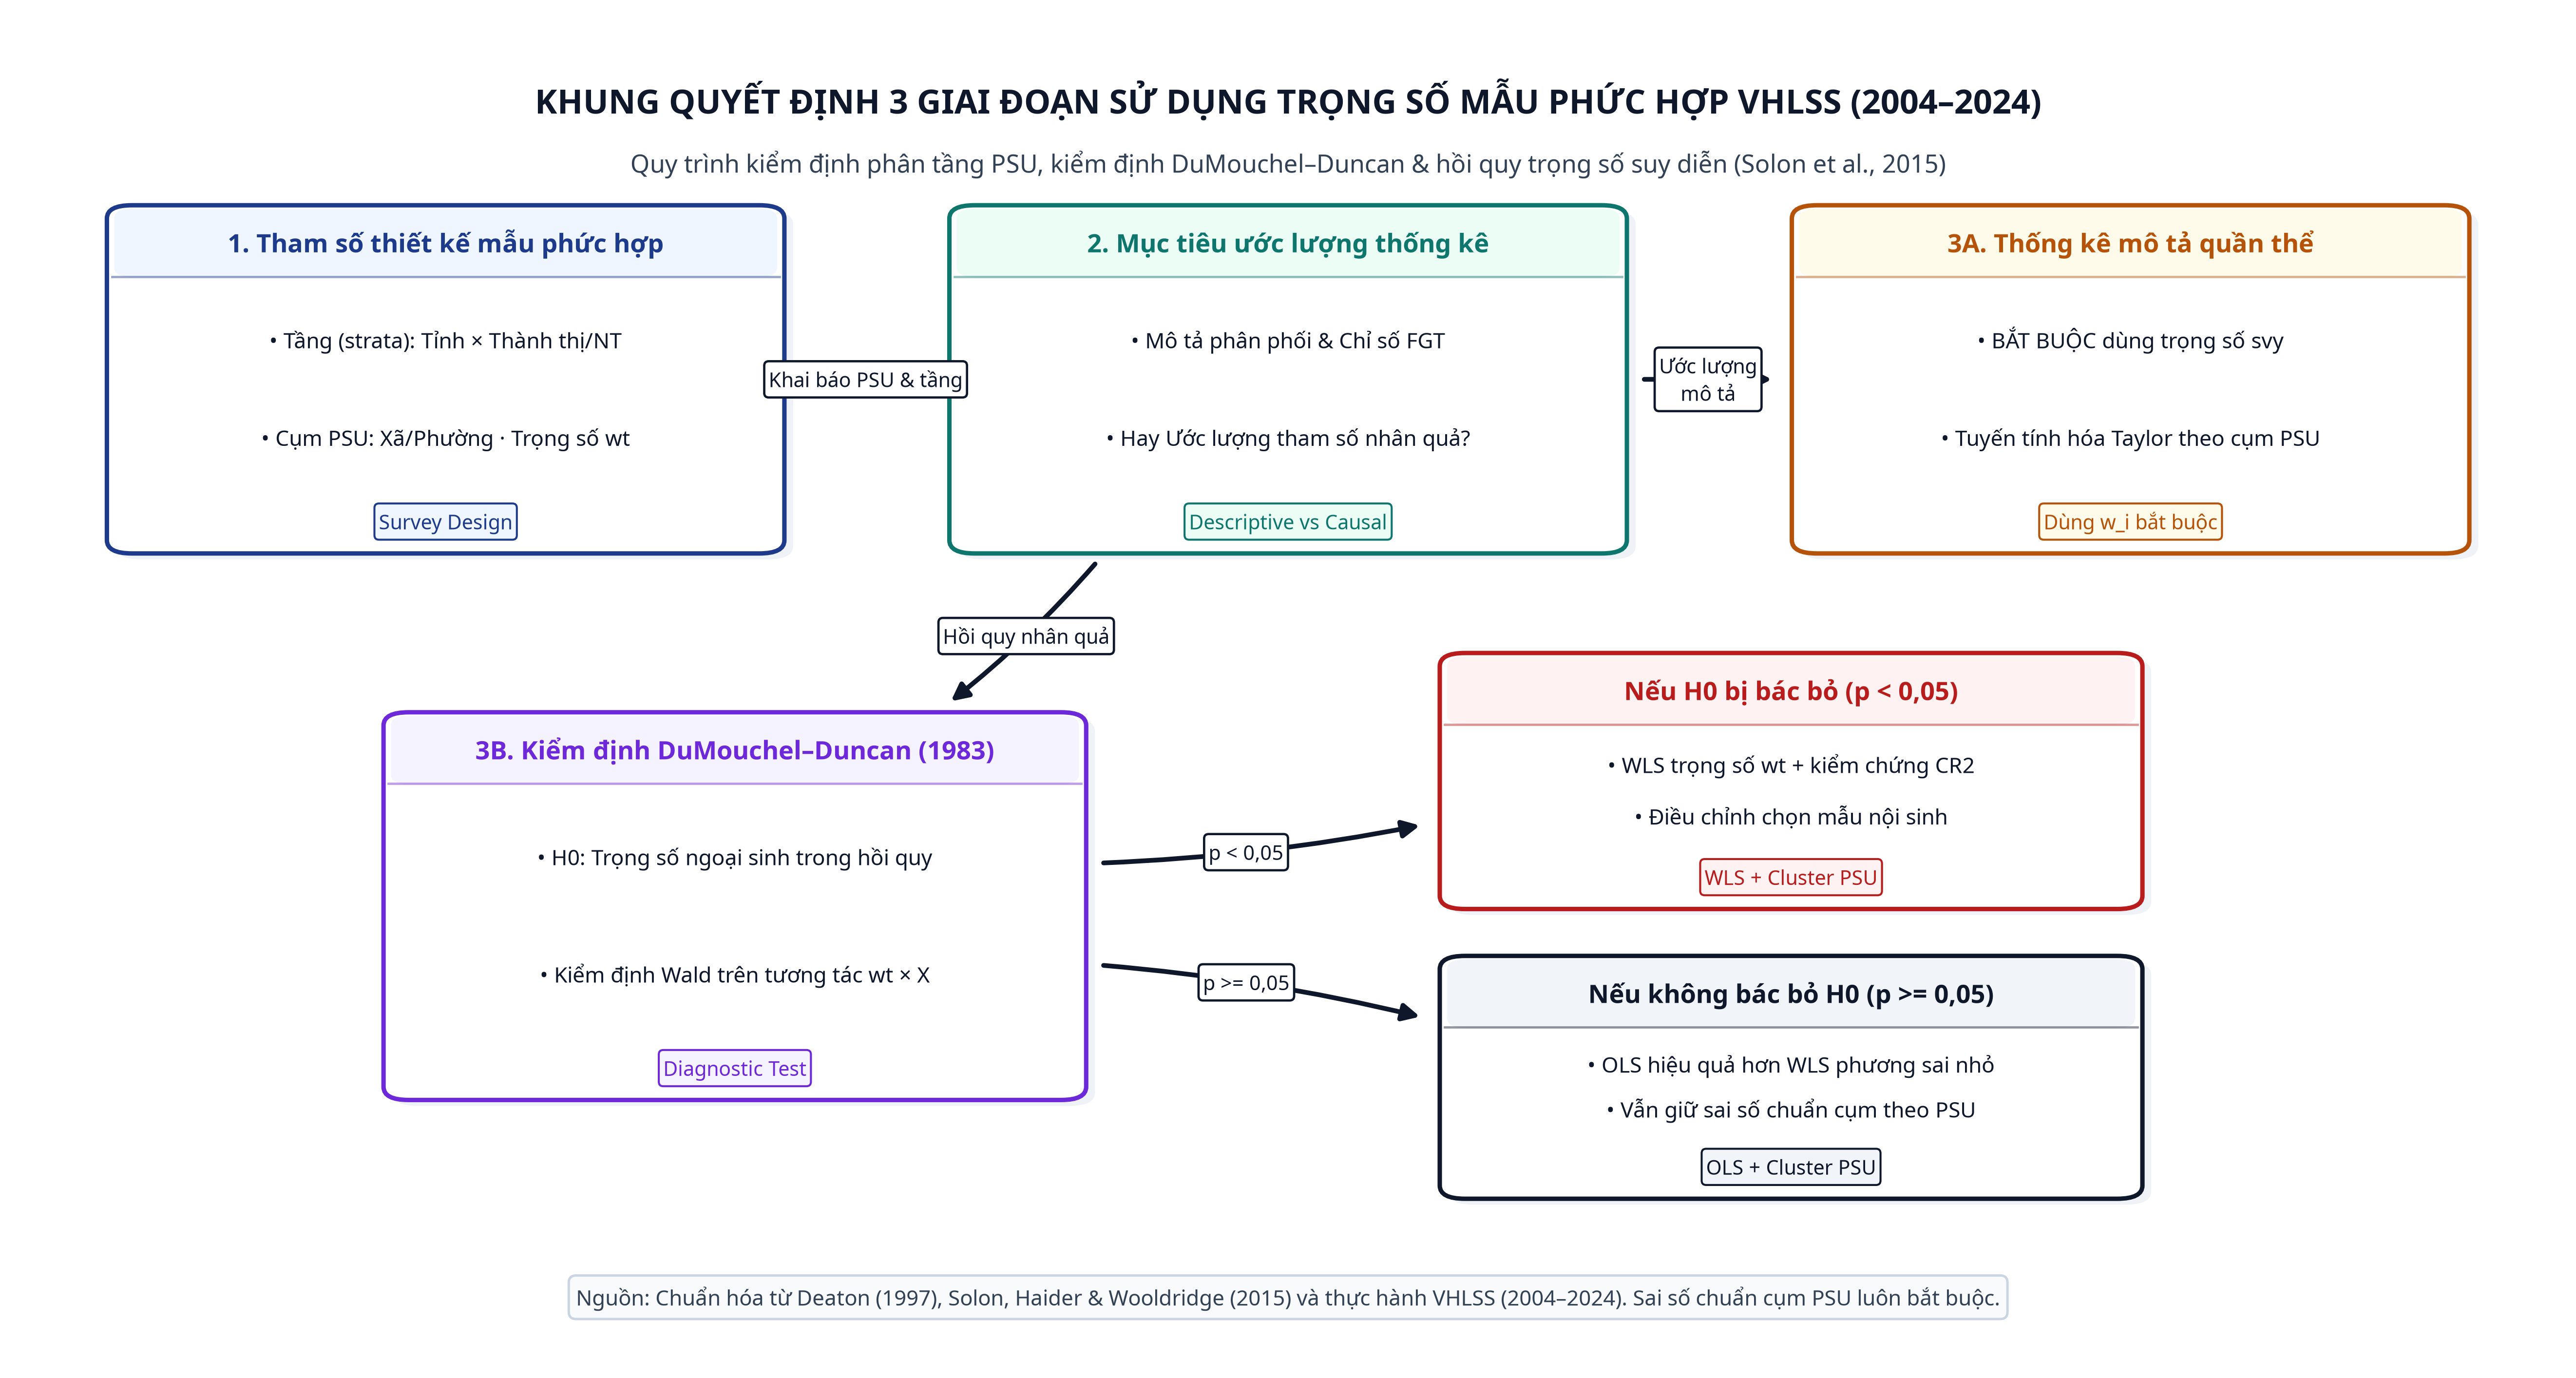
Kiểm định Wald gom cụm tại cấp địa bàn PSU cho giả thuyết đồng thời cung cấp quy tắc quyết định khách quan:
- Khi không bác bỏ : và hội tụ về cùng tham số cấu trúc; Ước lượng không trọng số gom cụm PSU có hiệu quả phương sai cao hơn, đồng thời ước lượng có trọng số được trình bày song song để khẳng định độ vững.
- Khi bác bỏ : Chênh lệch có ý nghĩa thống kê giữa hai bộ ước lượng cảnh báo phương trình đang bỏ sót biến phân tầng thiết kế hoặc tồn tại tính dị biệt tác động biên mạnh giữa các phân khúc dân cư, đòi hỏi bổ sung biến tương tác phân tầng và báo cáo đối chứng đầy đủ cả hai cột ước lượng.
3.2. Ma trận quyết định chuẩn tắc cho sáu cấu trúc dữ liệu vi mô VHLSS
Bảng 4 và Hình 3 hệ thống hóa quy tắc lựa chọn trọng số và cấp độ gom cụm sai số chuẩn theo Abadie et al. (2023) cho sáu cấu trúc khai thác dữ liệu VHLSS phổ biến:
| Cấu trúc đơn vị phân tích | Chế độ kết nối dữ liệu | Mục tiêu A: Thống kê mô tả, nghèo đói và bất bình đẳng | Mục tiêu B: Hồi quy nhân quả, lựa chọn rời rạc và hệ cầu | Cấp độ gom cụm sai số chuẩn và phân tầng |
|---|---|---|---|---|
| 1. Hộ gia đình — Mẫu thu nhập 45k | Ghép ngang 1 kỳ đơn lẻ | Bắt buộc dùng wt45 cho chỉ tiêu cấp hộ; Dùng wt45 * hhsize cho thu nhập BQĐN, Gini cá nhân và nghèo đầu người. | Báo cáo song song Không trọng số và Có trọng số wt45 kèm kiểm định DuMouchel & Duncan (1983). | Cụm psu = tinh-huyen-xa-diaban; Tầng tinh × ttnt. |
| 2. Hộ gia đình — Mẫu chi tiêu 9k | Ghép ngang 1 kỳ đơn lẻ | Bắt buộc dùng wt9 cho chi tiêu cấp hộ; Dùng wt9 * hhsize cho chi tiêu BQĐN và nghèo chi tiêu. | Báo cáo song song Không trọng số và Có trọng số wt9 trên Tobit, Two-Part, QUAIDS, IV-2SLS, 3SLS. | Cụm psu = tinh-huyen-xa-diaban; Tầng tinh × ttnt. |
| 3. Cấp cá nhân trong hộ | Ghép m:1 từ thành viên sang hộ | Kế thừa wt45 của hộ chủ quản cho lao động – tiền lương, hoặc wt9 nếu ghép với mô-đun chi tiêu 5 mục. | Mô hình Mincer (1974), Logit/Probit, Heckman: đối chứng Không trọng số và wt45 kèm kiểm định ngoại sinh. | Gom cụm tại địa bàn psu thay vì chỉ gom cụm cấp hộ để bao trùm tương quan nội thôn/tổ dân phố. |
| 4. Cấp xã nông thôn | Khảo sát xã nông thôn hoặc ghép m:1 xuống hộ | Bảng hỏi xã chỉ thu thập tại địa bàn nông thôn nên không dùng wt45/wt9 để suy rộng cho phường đô thị. | Khi ghép biến hạ tầng xã xuống hộ nông thôn, ước lượng tại cấp hộ với wt45 hoặc wt9 của hộ. | Gom cụm tại cấp xã tinh-huyen-xa khi biến chính sách biến thiên ở cấp xã theo Abadie et al. (2023). |
| 5. Gộp chéo đa kỳ 2014–2024 | Xếp chồng nhiều kỳ điều tra | Tính riêng từng năm bằng wt45/wt9 gốc; Khi tính trung bình gộp nhiều năm dùng trọng số chuẩn hóa theo kỳ. | Dùng trọng số chuẩn hóa cỡ mẫu kỳ wave_normalized kết hợp hiệu ứng cố định năm Year FE. | Gom cụm tại psu xuyên kỳ trong cùng Khung mẫu chủ để hấp thụ tự tương quan chuỗi thời gian cấp địa bàn. |
| 6. Dữ liệu bảng xoay vòng hộ | Theo dõi cùng hộ qua 2–3 kỳ | Dùng trọng số kỳ gốc hiệu chỉnh xác suất hao hụt mẫu khi phân tích ma trận chuyển dịch nghèo động. | Hồi quy Fixed Effects hộ hoặc Mundlak CRE: đối chứng không trọng số với trọng số kỳ gốc cố định theo hộ. | Gom cụm tại psu kỳ gốc hoặc mã định danh hộ gia đình xuyên kỳ. |
4. Kiểm chứng thực nghiệm kinh tế lượng trên VHLSS 2018–2022
4.1. Thực nghiệm định lý Solon–Haider–Wooldridge và kiểm định DuMouchel–Duncan trên hàm thu nhập hộ
Để minh chứng khả năng phát hiện sai lệch đặc tả của kiểm định DuMouchel & Duncan (1983) trên dữ liệu thực tế Việt Nam, Bảng 4 ước lượng hàm logarit thu nhập thực bình quân đầu người mở rộng từ phương trình vốn nhân lực của Mincer (1974) trên VHLSS 2020 và VHLSS 2022 dưới hai đặc tả đối lập:
- Đặc tả A — Đầy đủ biến phân tầng: Kiểm soát quy mô hộ
hhsize, tỷ lệ trẻ em dưới 15 tuổichild_share, tỷ lệ người cao tuổi từ 60 tuổi trở lênelderly_share, giới tính, tuổi, bình phương tuổi, số năm đi học của chủ hộhead_edu_years, dân tộc Kinhethnic_kinh, khu vực thành thịurbanvà hiệu ứng cố định vùng kinh tế – xã hội. - Đặc tả B — Lược bỏ biến phân tầng thiết kế: Cố ý loại bỏ
urban, vùng địa lý, dân tộc và học vấn, chỉ giữ lại ba biến nhân khẩu cơ bảnhhsize,head_agevàhead_female.
| Kỳ và đặc tả mô hình | Biến giải thích | không TS | không TS | có TS | có TS | Tỷ số | Chênh lệch (%) | Thống kê DuMouchel–Duncan | |
|---|---|---|---|---|---|---|---|---|---|
| 2022 — Đặc tả A () | hhsize | −0.03026 | 0.00218 | 0.00243 | −0.03006 | 0.00260 | 1.070× | +0.68% | |
| 2022 — Đặc tả A () | child_share | −0.69878 | 0.01758 | 0.01996 | −0.70871 | 0.02127 | 1.066× | −1.42% | |
| 2022 — Đặc tả A () | elderly_share | −0.45711 | 0.01382 | 0.01449 | −0.45259 | 0.01576 | 1.087× | +0.99% | |
| 2022 — Đặc tả A () | head_edu_years | +0.04980 | 0.00075 | 0.00103 | +0.04907 | 0.00118 | 1.144× | −1.46% | |
| 2022 — Đặc tả A () | ethnic_kinh | +0.43916 | 0.01059 | 0.02014 | +0.42283 | 0.02188 | 1.087× | −3.72% | |
| 2022 — Đặc tả A () | urban | +0.19763 | 0.00626 | 0.01127 | +0.19793 | 0.01226 | 1.088× | +0.15% | |
| 2022 — Đặc tả B () | hhsize | −0.06944 | 0.00220 | 0.00320 | −0.06765 | 0.00343 | 1.071× | +2.58% | |
| 2022 — Đặc tả B () | head_age | −0.00418 | 0.00026 | 0.00040 | −0.00622 | 0.00046 | 1.146× | −48.59% | |
| 2022 — Đặc tả B () | head_female | +0.02048 | 0.00777 | 0.00880 | +0.02951 | 0.00990 | 1.125× | +44.07% | |
| 2020 — Đặc tả A () | hhsize | −0.04487 | 0.01127 | 0.01156 | −0.04722 | 0.01289 | 1.116× | −5.24% | |
| 2020 — Đặc tả A () | child_share | −1.02661 | 0.09410 | 0.09775 | −0.98996 | 0.11185 | 1.144× | +3.57% | |
| 2020 — Đặc tả B () | head_age | −0.00631 | 0.00123 | 0.00137 | −0.01072 | 0.00169 | 1.234× | −69.87% | |
| 2020 — Đặc tả B () | head_female | +0.05885 | 0.03920 | 0.04042 | +0.09556 | 0.04519 | 1.118× | +62.39% |
Ghi chú: Mức ý nghĩa . Kiểm định DuMouchel–Duncan được tính với ma trận hiệp phương sai gom cụm tại địa bàn PSU.
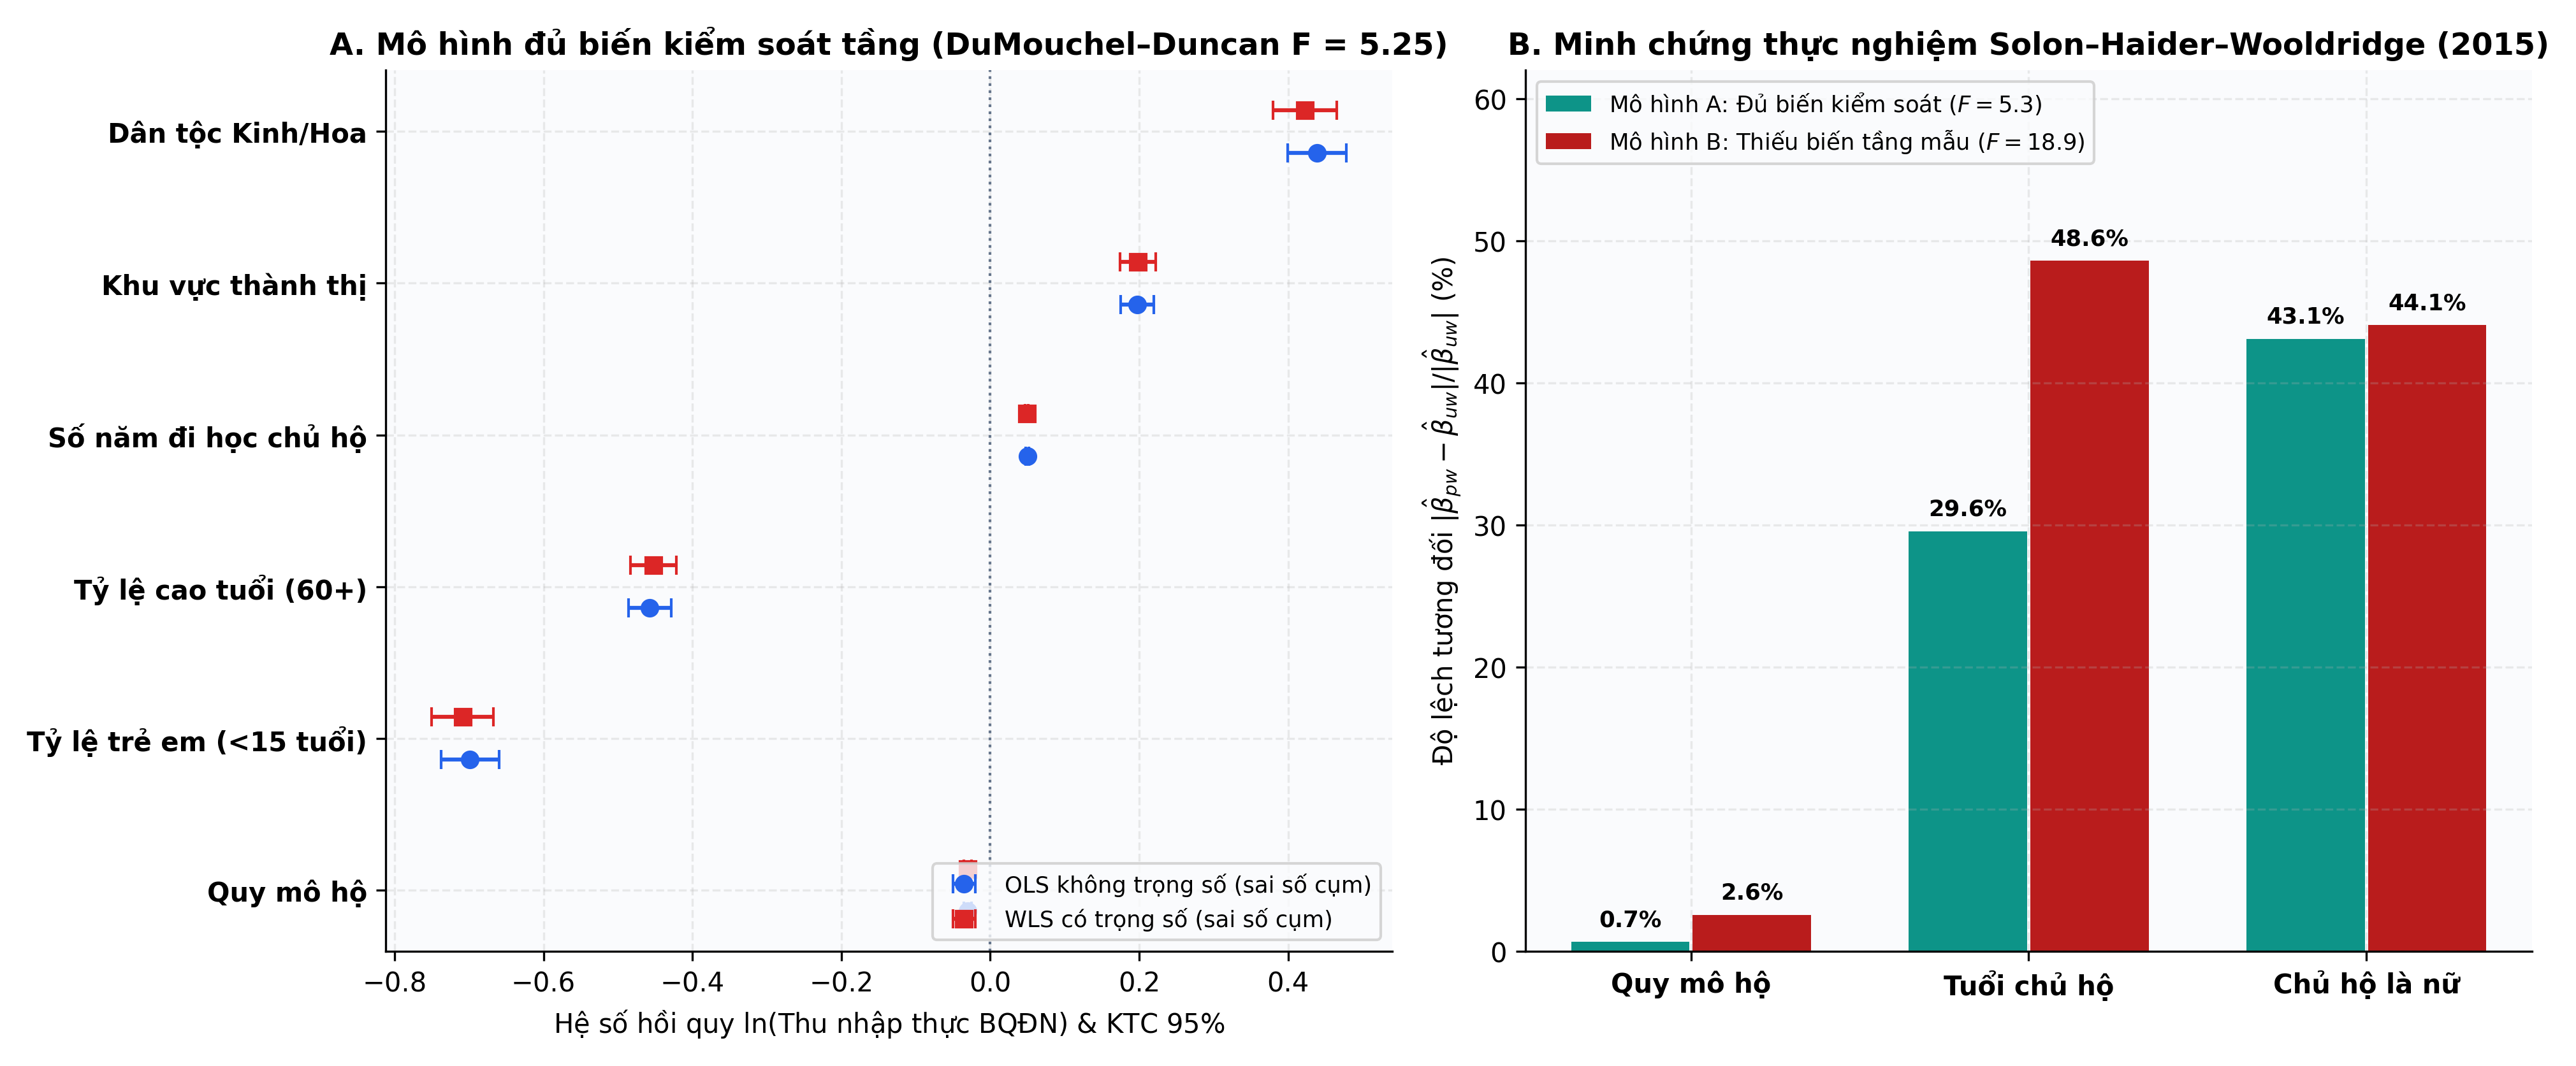
Kết quả thực nghiệm tại Bảng 4 và Hình 4 xác nhận chặt chẽ tiên đoán lý thuyết của Solon, Haider & Wooldridge (2015):
- Hội tụ điểm ước lượng và chi phí phương sai dưới Đặc tả A: Khi phương trình kiểm soát đầy đủ các biến phân tầng, hệ số ước lượng giữa OLS và WLS trên mẫu hộ năm 2022 hội tụ sát nhau: suất sinh lời của một năm học vấn chủ hộ đạt trên OLS so với trên WLS; Chênh lệch thu nhập thành thị – nông thôn đạt so với ; Tác động quy mô hộ đạt so với . Đổi lại, sai số chuẩn của WLS tăng thêm – năm 2022 và – năm 2020 đúng theo quy luật Kish . Đặc biệt, việc đối chiếu cột với trên biến
ethnic_kinhvàurbanchứng minh rằng bỏ qua gom cụm sai số chuẩn tại địa bàn PSU gây sai lệch suy diễn nghiêm trọng hơn nhiều so với khác biệt trọng số. - Phát hiện tức thời sai lệch bỏ sót biến dưới Đặc tả B: Khi lược bỏ các biến phân tầng địa lý và nhân khẩu, thống kê của DuMouchel & Duncan (1983) tăng vọt từ lên năm 2020 và từ lên năm 2022, kéo theo độ lệch điểm ước lượng của
head_agevàhead_femalelên tới – do các hộ nữ làm chủ hộ tại khu vực đô thị lớn có mức sống khác biệt căn bản so với vùng cao.
4.2. Chuẩn hóa trọng số khi gộp chéo nhiều kỳ không cân bằng cỡ mẫu
Trong nghiên cứu thực nghiệm dài hạn, nhà nghiên cứu thường gộp mẫu thu nhập đầy đủ năm 2018, phân mẫu chi tiêu năm 2020 và mẫu thu nhập đầy đủ năm 2022. Bảng 5 đánh giá bốn quy tắc chuẩn hóa quyền số đa kỳ:
| Quy tắc quyền số đa kỳ | Công thức chuẩn hóa trên kỳ | và SE PSU | và SE PSU | và SE PSU | và SE PSU | Đặc tính thống kê trên tổng thể gộp | |
|---|---|---|---|---|---|---|---|
| 1. Không trọng số | −0.04451 ± 0.00186 | +0.42514 ± 0.00996 | +0.68302 ± 0.01268 | +0.08768 ± 0.00863 | 0.1987 | Kỳ 2020 chỉ chiếm tổng quyền số mẫu và chịu chệch lấy mẫu miền núi. | |
2. Trọng số gốc raw | −0.04469 ± 0.00221 | +0.47033 ± 0.01180 | +0.68877 ± 0.01465 | +0.09527 ± 0.01034 | 0.1959 | Mỗi kỳ đóng góp tỷ lệ với tổng số hộ quốc gia thực tế (– triệu). | |
3. Chuẩn hóa theo cỡ mẫu kỳ wave_normalized | −0.04455 ± 0.00220 | +0.47095 ± 0.01178 | +0.68888 ± 0.01464 | +0.09524 ± 0.01034 | 0.1967 | Khôi phục tính đại diện nội kỳ đồng thời tối ưu hóa phương sai khi chênh lệch 5 lần. | |
4. Quyền số đều mỗi kỳ equal_wave | −0.05464 ± 0.00412 | +0.56714 ± 0.02194 | +0.67719 ± 0.02064 | +0.08895 ± 0.01037 | 0.1481 | Ép kỳ hộ gánh quyền số ngang kỳ hộ, làm tăng gấp đôi sai số chuẩn. |
Kết quả Bảng 5 chứng minh rằng khi gộp các kỳ có cỡ mẫu tương đương, cả hai quy tắc wave_normalized và equal_wave đều ổn định; Nhưng khi ghép chung các phân mẫu có quy mô chênh lệch gấp 5 lần, quy tắc wave_normalized kết hợp hiệu ứng cố định năm Year FE đạt hiệu quả thống kê vượt trội nhờ không thổi phồng phương sai của kỳ có cỡ mẫu nhỏ.
5. Đối chiếu độ tương đương số học đa nền tảng và chuẩn hóa tính toán khả tái lập
Để kiểm chứng độ chính xác số học của thuật toán ước lượng ma trận hiệp phương sai chuỗi Taylor gom cụm PSU giữa các môi trường phần mềm kinh tế lượng hiện đại, Bảng 6 đối chiếu trực tiếp kết quả ước lượng trên tập dữ liệu VHLSS 2022 — , cụm PSU, tầng giữa Python statsmodels WLS Sandwich và Stata 18 MP dưới cả hai khai báo [pw=wt45], vce(cluster psu) và svyset psu [pw=wt45], strata(strata).
| Biến giải thích | Python WLS | Python | Stata 18 MP | Stata 18 MP | Stata 18 MP svy: | Sai khác tuyệt đối |
|---|---|---|---|---|---|---|
hhsize | −0.049930 | 0.002652 | −0.049930 | 0.002652 | 0.002442 | |
urban | +0.276098 | 0.014193 | +0.276098 | 0.014193 | 0.011700 | |
ethnic_kinh | +0.566344 | 0.021258 | +0.566344 | 0.021258 | 0.020113 | |
head_edu_years | +0.050377 | 0.001230 | +0.050377 | 0.001230 | 0.001169 | |
const | +7.325146 | 0.024116 | +7.325146 | 0.024116 | 0.022305 |
Sai số tuyệt đối giữa Python và Stata 18 MP nằm trong khoảng đến , đạt độ trùng khít tuyệt đối tới chữ số thập phân thứ sáu trên cả véctơ tham số lẫn sai số chuẩn gom cụm PSU. Đáng chú ý, cột thứ sáu cho thấy khi khai báo bổ sung cấu trúc phân tầng strata(tinh × ttnt) trong svyset, sai số chuẩn của biến phân tầng urban giảm thêm nhờ khấu trừ phương sai giữa các tầng vốn đã được cố định bởi thiết kế chọn mẫu theo Deaton (1997). Điều này khẳng định việc sử dụng sai số chuẩn gom cụm PSU khi chưa tách tầng luôn bảo đảm tính suy diễn thận trọng cho các kiểm định giả thuyết.
Đối với các mô hình lựa chọn rời rạc phi tuyến như Logit, Probit và Complementary Log-Log sử dụng phương pháp hợp lý cực đại giả theo Wooldridge (1999, 2001), việc chuẩn hóa trọng số trong hàm hợp lý giả kết hợp tính toán giải tích tổng điểm số cấp cụm và hệ số hiệu chỉnh mẫu hữu hạn giúp tái lập chính xác tuyệt đối ma trận phương sai svy: logit và svy: probit của Stata và gói survey trên R mà không gặp hiện tượng bất ổn định số học khi tổng trọng số gốc lên tới hàng chục triệu đơn vị.
6. Kết luận, khuyến nghị thực hành chuẩn mực và tuyên bố tái lập
6.1. Sáu nguyên tắc chuẩn mực khi công bố nghiên cứu thực nghiệm từ VHLSS
6.2. Tuyên bố sẵn có dữ liệu và tái lập đa nền tảng
Toàn bộ kết quả thực nghiệm, bảng số liệu và đồ thị 300-DPI trong nghiên cứu được trích xuất và kiểm chứng từ dữ liệu vi mô Khảo sát Mức sống Dân cư Việt Nam giai đoạn 2014–2024 do Cục Thống kê công bố. Gói mã nguồn tái lập hoàn chỉnh trên ba ngôn ngữ Stata, R và Python cùng các bảng kết quả tổng hợp ẩn danh và mã băm kiểm tra toàn vẹn SHA256SUMS.txt được lưu trữ đồng bộ phục vụ kiểm chứng độc lập; Đồng thời quy trình gắn trọng số thiết kế, chuẩn hóa đa kỳ và kiểm định ngoại sinh DuMouchel–Duncan có thể thực thi tự động trên hạ tầng dữ liệu vi mô EcoData.
Tài liệu tham khảo
- Abadie, A., Athey, S., Imbens, G. W., & Wooldridge, J. M. (2023). When should you adjust standard errors for clustering? The Quarterly Journal of Economics, 138, 1–35. https://doi.org/10.1093/qje/qjac038 ↩
- Cameron, A. C., & Miller, D. L. (2015). A practitioner's guide to cluster-robust inference. Journal of Human Resources, 50, 317–372. https://doi.org/10.3368/jhr.50.2.317 ↩
- Deaton, A. (1997). The analysis of household surveys: A microeconometric approach to development policy. Johns Hopkins University Press for the World Bank. https://doi.org/10.1596/0-8018-5254-4 ↩
- DuMouchel, W. H., & Duncan, G. J. (1983). Using sample survey weights in multiple regression analyses of stratified samples. Journal of the American Statistical Association, 78, 535–543. https://doi.org/10.1080/01621459.1983.10478006 ↩
- Foster, J., Greer, J., & Thorbecke, E. (1984). A class of decomposable poverty measures. Econometrica, 52, 761–766. https://doi.org/10.2307/1913475 ↩
- General Statistics Office of Vietnam. (2025). Kết quả Khảo sát mức sống dân cư Việt Nam năm 2024. Nhà xuất bản Thống kê. https://www.nso.gov.vn ↩
- Hájek, J. (1971). Comment on "An essay on the logical foundations of survey sampling, part one" by D. Basu. In V. P. Godambe & D. A. Sprott, Foundations of statistical inference. Holt, Rinehart and Winston. ↩
- Horvitz, D. G., & Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47, 663–685. https://doi.org/10.1080/01621459.1952.10483446 ↩
- Kish, L. (1965). Survey sampling. John Wiley & Sons. ↩
- Manski, C. F., & Lerman, S. R. (1977). The estimation of choice probabilities from choice based samples. Econometrica, 45, 1977–1988. https://doi.org/10.2307/1914121 ↩
- Mincer, J. (1974). Schooling, experience, and earnings. National Bureau of Economic Research; Columbia University Press. ↩
- Pfeffermann, D. (1993). The role of sampling weights when modeling survey data. International Statistical Review, 61, 317–337. https://doi.org/10.2307/1403631 ↩
- Solon, G., Haider, S. J., & Wooldridge, J. M. (2015). What are we weighting for? Journal of Human Resources, 50, 301–316. https://doi.org/10.3368/jhr.50.2.301 ↩
- Wooldridge, J. M. (1999). Asymptotic properties of weighted M-estimators for variable probability samples. Econometrica, 67, 1385–1406. https://doi.org/10.1111/1468-0262.00083 ↩
- Wooldridge, J. M. (2001). Asymptotic properties of weighted M-estimators for standard stratified samples. Econometric Theory, 17, 451–470. https://doi.org/10.1017/S0266466601172075 ↩
- Wooldridge, J. M. (2010). Econometric analysis of cross section and panel data. MIT Press. ↩
Dữ liệu & Mã lệnh tái lập
table01_weight_distributions_2014_2024yearweight_varn_hhsum_weightsmean_weightcv_weightuwe_kishn_effMở khóa dữ liệu & mã lệnh tái lập
Sau khi theo dõi phần phân tích định lượng và bình duyệt học thuật phía trên, mời bạn đăng nhập nếu đã có gói thành viên hoặc tham gia cộng đồng nghiên cứu EcoLab để trực tiếp kiểm chứng từng hệ số ước lượng trên máy cá nhân.
Khớp chính xác tên biến, đặc tả sai số chuẩn vững và ma trận kiểm định chẩn đoán của bài nghiên cứu.
Sẵn sàng nạp trực tiếp vào môi trường thống kê cá nhân để đối chiếu độc lập từng bảng kết quả.
Đóng gói đồng bộ bản thảo chuẩn công bố tạp chí DOCX & PDF, tệp dữ liệu CSV, ba kịch bản ước lượng R · Stata · Python và hướng dẫn thực thi.
Mỗi liên kết tải xuống được cấp chữ ký bảo mật riêng cho tài khoản thành viên và tự động làm mới mượt mà ngay trên trang đọc.