1. Giới thiệu và bối cảnh học thuật
Một trong những bất đối xứng cấu trúc nổi bật nhất của kinh tế học phát triển là sự tập trung dày đặc của lực lượng lao động chế biến chế tạo tại các cơ sở siêu nhỏ ở các nền kinh tế thu nhập thấp và trung bình, trái ngược hoàn toàn với sự thống trị của các nhà máy quy mô lớn tại các nền kinh tế phát triển như phân tích của Tybout (2000) cùng Hsieh & Klenow (2014). Dữ liệu tổng hợp từ Khảo sát Công nghiệp Thường niên và Khảo sát Doanh nghiệp Phi chính thức tại Ấn Độ cho thấy tỷ trọng lao động làm việc trong các nhà máy có dưới năm lao động đạt tới 59.81%, trong khi con số tương ứng của Hoa Kỳ theo Tổng điều tra Kinh tế chỉ là 1.61% — một khoảng cách gần 58.20 điểm phần trăm. Ngay cả khi thu hẹp phạm vi về khu vực Tổng điều tra Ấn Độ chính thức, tỷ trọng nhà máy dưới năm lao động vẫn ở mức 49.58%, đồng thời tầng doanh nghiệp từ 100 đến 249 lao động chỉ hấp thụ 3.75% lao động tại Ấn Độ so với 21.80% tại Hoa Kỳ. Sự tồn tại dai dẳng của phần đuôi trái dày trong phân bố quy mô cơ sở sản xuất thường kéo theo năng suất lao động tổng hợp thấp hơn và làm chậm quá trình chuyển dịch cơ cấu công nghiệp theo ghi nhận của Bento & Restuccia (2017).
Trong văn liệu truyền thống về phân bổ nguồn lực sai lệch và tổ chức sản xuất, phần lớn các nghiên cứu như Hsieh & Klenow (2014) cùng Poschke (2018) lý giải hiện tượng nhà máy nhỏ thông qua các rào cản bên cung gồm thuế bóp méo quy mô, ma sát thị trường lao động, hạn chế tín dụng hoặc chi phí quản trị gia tăng khi mở rộng doanh nghiệp. Tuy nhiên, một nhánh nghiên cứu bổ sung của Bils & Klenow (2001), Matsuyama (2002) và Fajgelbaum et al. (2011) nhấn mạnh vai trò độc lập của phía cầu khi sở thích tiêu dùng mang tính phi đồng nhất theo thu nhập. Khi hộ gia đình có thu nhập cao hơn dành tỷ trọng chi tiêu lớn hơn cho các mặt hàng chất lượng cao, còn sản xuất hàng chất lượng cao đòi hỏi quy mô cố định lớn hơn và tỷ lệ lao động có kỹ năng cao hơn theo chứng cứ của Verhoogen (2008) cùng Kugler & Verhoogen (2012), bản thân cấu trúc thu nhập thấp và nguồn cung kỹ năng hạn chế tại các quốc gia đang phát triển sẽ tự nhiên sinh ra cầu thị trường tương đối nghiêng về các sản phẩm chất lượng thấp do các nhà máy nhỏ cung ứng.
Công trình của Jain & Kothari (2026) trên Journal of Political Economy Macroeconomics đưa ra một khuôn khổ hợp nhất vừa có chứng cứ vi mô đa tầng từ Ấn Độ vừa có mô hình cân bằng tổng thể định lượng tường minh để lượng hóa đúng đóng góp của cơ chế cầu chất lượng phi đồng nhất kết hợp hiệu ứng đa dạng hóa sản phẩm và thâm dụng kỹ năng. Về mặt thực nghiệm, bằng chứng liên bang trên 15 bang lớn của Ấn Độ phản ánh mối tương quan âm rất mạnh giữa thu nhập bình quân đầu người và tỷ trọng lao động tại các nhà máy siêu nhỏ: bang nghèo nhất Bihar có mức sản lượng nội địa bình quân đầu người bằng 10,154.54 Rupee ghi nhận tới 88.86% lao động ở ngưỡng tối đa năm người, trong khi bang giàu nhất Maharashtra đạt 40,947.00 Rupee chỉ ghi nhận 43.31%, còn Gujarat thậm chí xuống tới 40.02%. Trên phương diện chuỗi thời gian từ năm 1989 đến năm 2009, tỷ trọng lao động ở các cơ sở tối đa năm người của Ấn Độ giảm đều đặn từ 76.90% xuống còn 57.80% song hành với tăng trưởng thu nhập và mở rộng giáo dục đại học kỹ thuật.
Nghiên cứu tái lập hiện tại thực hiện kiểm chứng toàn diện công trình của Jain & Kothari (2026) ở cấp độ chuẩn học thuật Q1 với ba đóng góp cụ thể. Thứ nhất, chúng tôi hợp nhất toàn bộ 12,984 dòng dữ liệu công khai từ tám hợp phần gốc thuộc kho lưu trữ Jain & Kothari (2026b) đồng thời giữ nguyên ranh giới minh bạch đối với vi dữ liệu hạn chế truy cập của MOSPI, kiên quyết không tạo dữ liệu vi mô giả định. Thứ hai, chúng tôi dịch chuyển và cải tiến toàn bộ bộ giải cân bằng tổng thể phi đồng nhất 12 bậc chất lượng từ MATLAB sang cả ba nền tảng Python, R và Stata 18 Mata với thuật toán rào cản nội điểm Newton ở Bước 1 và nghiệm giải tích Jacobian trong không gian logarit ở Bước 3 và Bước 4, cho phép cả bốn đặc tả cấu trúc cùng toàn bộ hệ thống hồi quy thực nghiệm hoàn tất trong 3.34–11.62 giây mỗi nền tảng với sai lệch tối đa 0.000008% giữa ba ngôn ngữ và 0.29%–0.57% so với kết quả gốc. Thứ ba, nghiên cứu bổ sung chuỗi hồi quy mở rộng cho hàm hồi quy liên bang, hồi quy Logit kèm hiệu ứng biên trung bình và mô hình hiệu ứng cố định hai chiều cụm mã ngành sản phẩm để kiểm chứng giả thuyết nhiễu đo lường đơn vị trong điều tra công nghiệp Ấn Độ giai đoạn 2001–2008, tích hợp thêm kiểm chứng độc lập trên máy chủ tất định EcoData và cận ổn định chọn lọc Oster (2019).
2. Cơ sở lý thuyết và phương pháp nghiên cứu
Khung lý thuyết của Jain & Kothari (2026) kết hợp sở thích tiêu dùng phi đồng nhất theo bậc chất lượng rời rạc theo cách tiếp cận của Fajgelbaum et al. (2011) với cạnh tranh độc quyền các doanh nghiệp dị biệt về năng suất nội sinh kiểu Melitz (2003) và Krugman (1979) cùng hàm chi phí sản xuất theo độ co giãn thay thế không đổi giữa hai nhóm kỹ năng lao động. Cách thiết lập này cho phép tách bạch hai kênh truyền dẫn định lượng rõ ràng: kênh cầu chất lượng trực tiếp không phụ thuộc hiệu ứng đa dạng hóa và kênh khuếch đại quy mô thị trường nội địa khi độ ưa thích đa dạng hóa được kích hoạt đầy đủ.
2.1. Kiến trúc tiêu dùng phi đồng nhất và lựa chọn thang chất lượng
Nền kinh tế gồm hộ gia đình được chuẩn hóa về tổng quy mô dân số bằng , chia thành hai nhóm kỹ năng với tỷ trọng lao động có kỹ năng là và tỷ trọng lao động phổ thông là . Mỗi hộ gia đình sở hữu mức thu nhập ròng bao gồm tiền lương và cổ tức bình quân đầu người , lựa chọn duy nhất một bậc chất lượng trên thang bậc cách đều nhằm tối đa hóa hàm hữu dụng phi tuyến theo mô hình logit:
Trong đó:
- : mức hữu dụng gián tiếp của hộ gia đình thuộc nhóm kỹ năng khi tiêu dùng rổ biến thể tại bậc chất lượng ;
- : chỉ số chất lượng rời rạc tăng đều từ chất lượng cơ sở đến chất lượng tối đa ;
- : mức tiền lương danh nghĩa của nhóm lao động , với tiền lương lao động phổ thông được chuẩn hóa làm đơn vị đo ;
- : thu nhập cổ tức bình quân đầu người phát sinh từ lợi nhuận ròng trừ chi phí gia nhập của khu vực sản xuất;
- : chỉ số giá tổng hợp của giỏ biến thể thuộc bậc chất lượng ;
- : tham số dịch chuyển sở thích thuần túy đặc trưng cho bậc chất lượng với chuẩn hóa cơ sở ;
- : cú sốc sở thích đặc thù cá nhân phân phối theo quy luật Gumbel chuẩn hóa độc lập giữa các bậc chất lượng.
Với phân phối Gumbel của , xác suất hộ gia đình nhóm lựa chọn bậc chất lượng tuân theo dạng hàm mũ đa thức logit chuẩn xác:
Trong đó:
- : tỷ phần hộ gia đình thuộc nhóm kỹ năng phân bổ chi tiêu vào bậc chất lượng ;
- : chỉ số chạy qua toàn bộ bậc chất lượng trong tập lựa chọn khả dĩ;
- và : lần lượt là chỉ số giá và tham số sở thích đặc thù tại bậc chất lượng .
Tính chất cốt lõi của hệ số góc đứng trước là độ co giãn của cầu tương đối theo thu nhập luôn tăng đơn điệu theo bậc chất lượng . Khi mức thu nhập hoặc khi quốc gia bước vào quỹ đạo tăng trưởng thực, hiệu ứng thu nhập dịch chuyển xác suất tiêu dùng mạnh về phía các bậc chất lượng cao hơn. Tại mỗi bậc chất lượng , rổ tiêu dùng cuối cùng được tổng hợp từ khối lượng liên tục biến thể khác biệt với độ co giãn thay thế và tham số cường độ sở thích đa dạng hóa :
Trong đó:
- : khối lượng doanh nghiệp đang hoạt động và cung ứng sản phẩm thuộc bậc chất lượng ;
- : tham số điều tiết ngoại tác đa dạng hóa, nhận giá trị ở kịch bản không có sở thích đa dạng hóa để triệt tiêu số mũ trên , và nhận giá trị ở kịch bản sở thích đa dạng hóa đầy đủ;
- : độ co giãn thay thế giữa các biến thể cùng bậc chất lượng;
- : giá bán tối ưu của nhà máy có mức năng suất tại bậc chất lượng ;
- : hàm phân phối tích lũy log-chuẩn của năng suất doanh nghiệp nội sinh trên lưới điểm rời rạc trải rộng .
2.2. Công nghệ sản xuất thâm dụng kỹ năng, gia nhập tự do và cân bằng tổng thể
Mỗi nhà máy gia nhập thị trường tại bậc chất lượng rút thăm một mức năng suất ngẫu nhiên và sản xuất bằng hàm công nghệ CES kết hợp lao động phổ thông và lao động có kỹ năng với độ co giãn thay thế và năng suất tương đối kỹ năng chuẩn hóa . Chi phí biên đơn vị của nhà máy có biểu thức đóng tường minh:
Trong đó:
- : chi phí biên sản xuất một đơn vị sản lượng của nhà máy có bậc chất lượng và điểm năng suất ;
- : năng suất nhân tố tổng hợp đặc thù của nhà máy tại ô lưới ;
- : tham số trọng số lao động phổ thông trong hàm sản xuất của bậc chất lượng , giảm đơn điệu theo quy mô và chất lượng;
- : độ co giãn thay thế giữa lao động phổ thông và lao động có kỹ năng;
- và : tiền lương của lao động phổ thông và lao động có kỹ năng;
- : tham số hiệu suất lao động có kỹ năng.
Do thị trường mỗi bậc chất lượng vận hành theo cơ chế cạnh tranh độc quyền với cấu trúc cầu CES, mức giá tối ưu luôn là hệ số cộng thêm cố định , đồng thời tỷ lệ cầu lao động có kỹ năng trên lao động phổ thông tại nhà máy là . Để gia nhập bậc chất lượng , nhà đầu tư tiềm năng bỏ ra chi phí cố định đơn vị lao động tổng hợp có cơ cấu kỹ năng trùng khớp với cơ cấu kỹ năng sản xuất tại bậc chất lượng đó, đối mặt với xác suất rời thị trường ngoại sinh hằng kỳ và hệ số chiết khấu . Điều kiện cân bằng không lợi nhuận gia nhập tại mỗi bậc chất lượng cân bằng giá trị hiện tại ròng của lợi nhuận kỳ vọng với chi phí gia nhập:
Trong đó:
- : tổng chi tiêu danh nghĩa của toàn bộ hộ gia đình trong nền kinh tế vào các sản phẩm thuộc bậc chất lượng , bằng ;
- và : lần lượt là hệ số chiết khấu thời gian và tỷ lệ rút lui ngoại sinh của nhà máy;
- : lượng lao động cố định cần thiết để gia nhập bậc chất lượng ;
- : tỷ trọng lao động có kỹ năng trong gói chi phí gia nhập của bậc chất lượng .
Điểm đột phá kỹ thuật của nghiên cứu tái lập là phép biến đổi điều kiện gia nhập tự do ở kịch bản sở thích đa dạng hóa đầy đủ về không gian logarit kèm ma trận Jacobian giải tích chính xác kích thước . Khi tính đạo hàm của theo thông qua hệ số tác động giá , hệ phương trình sở hữu ma trận Jacobian đóng:
Trong đó:
- : phần tử hàng , cột của ma trận Jacobian giải tích trong thuật toán Newton giải cân bằng gia nhập tự do;
- : độ co giãn truyền dẫn từ logarit khối lượng doanh nghiệp bậc sang logarit chỉ số giá ;
- : hàm chỉ báo bằng
1khi và bằng0khi ; - và : tổng chi tiêu riêng biệt của nhóm hộ gia đình lao động phổ thông và lao động có kỹ năng vào bậc chất lượng .
Nhờ ma trận Jacobian giải tích này kết hợp cơ chế khởi tạo ấm và tìm nghiệm theo phương pháp dây cung có rào chặn trên mức lương kỹ năng cùng tham số nền , cả ba nền tảng Python, R và Stata Mata đều đạt thặng dư gia nhập tự do dưới chỉ sau 2–4 bước lặp Newton và hoàn tất toàn bộ hệ thống bốn đặc tả GE cùng 13 mô hình thực nghiệm trong khoảng 3.3–11.6 giây. Ở Bước 1 hiệu chuẩn phân bố lao động mục tiêu qua 12 bậc chất lượng dựa trên 10 ngưỡng biểu đồ quy mô Ấn Độ, thay vì phụ thuộc vào thuật toán tối ưu hóa hộp đen dễ dao động dọc không gian nghiệm 11 biến — 10 phương trình, chúng tôi chuẩn hóa bằng bộ giải Newton rào cản nội điểm với hệ số rào xuất phát từ nội suy PCHIP chuẩn Fritsch–Carlson, bảo đảm nghiệm duy nhất đồng nhất tuyệt đối giữa ba ngôn ngữ và tái lập chỉ số sai lệch chỉ 0.03% so với bản gốc MATLAB.
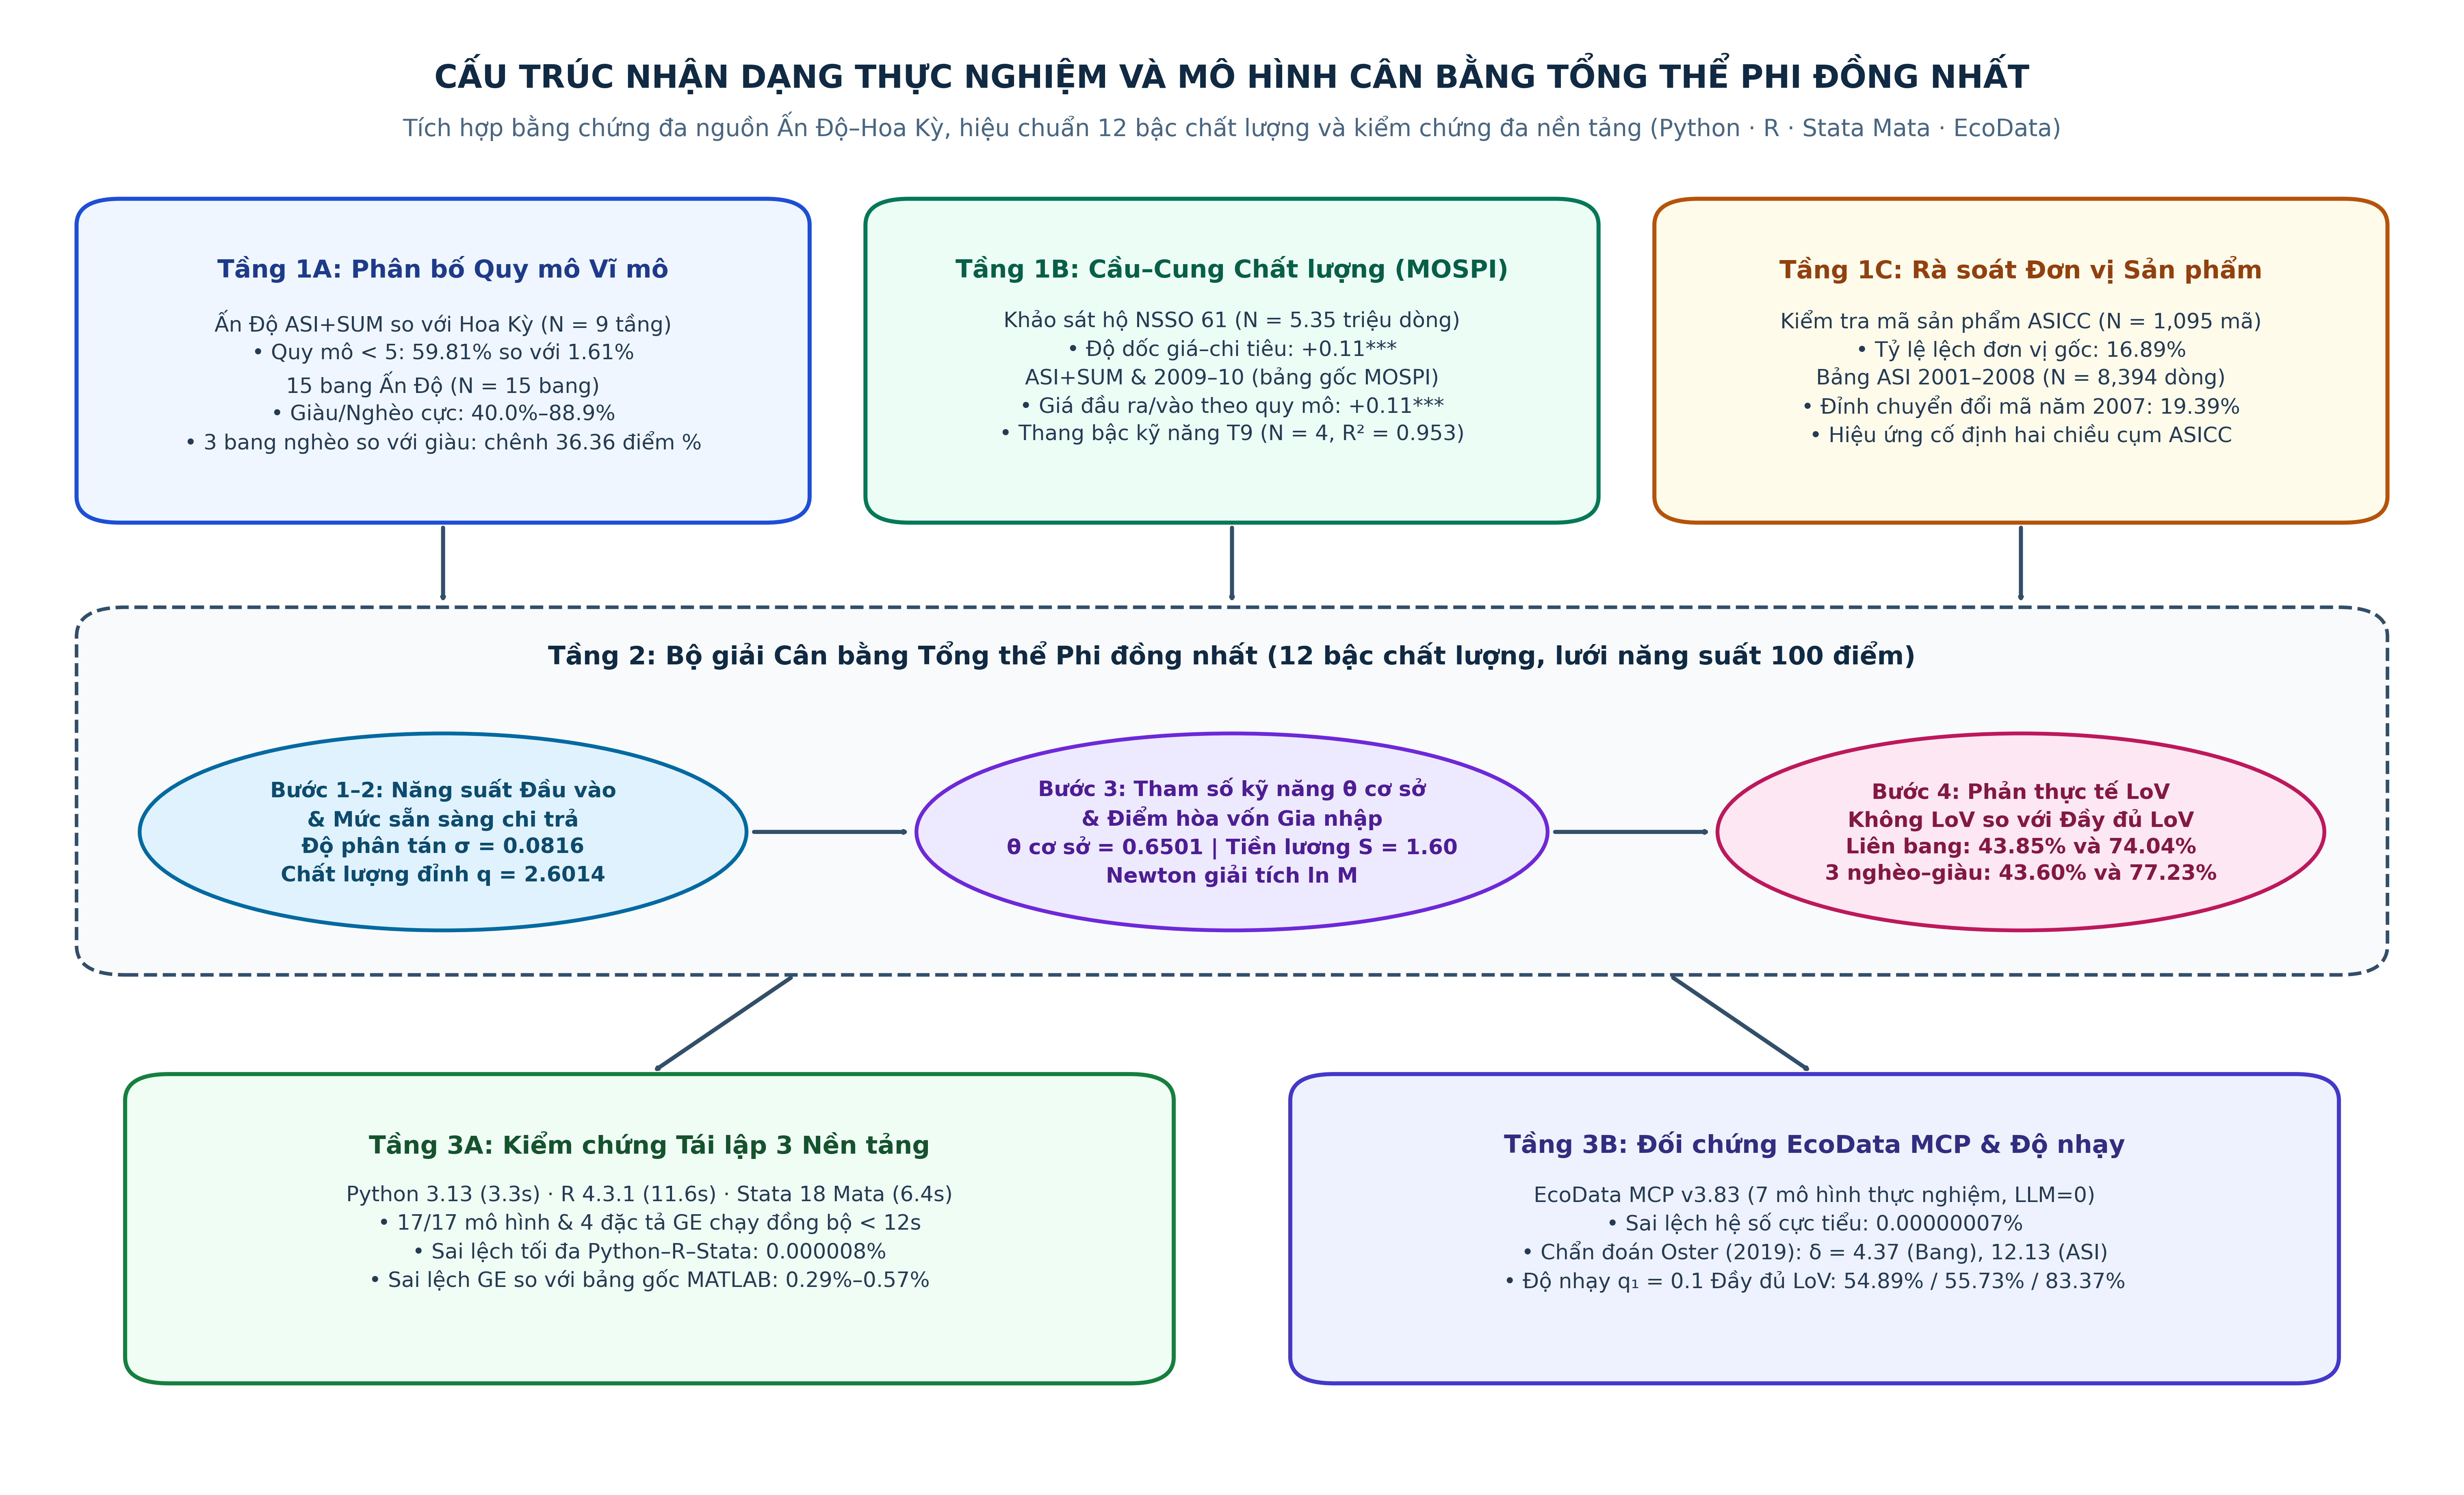
Hình 1: Cấu trúc nhận dạng thực nghiệm 3 tầng và quy trình tái lập mô hình cân bằng tổng thể phi đồng nhất trên Python, R, Stata Mata và EcoData.
2.3. Hệ thống đặc tả kinh tế lượng thực nghiệm
Trên mẫu cắt ngang 15 bang lớn của Ấn Độ, phương trình liên bang ước lượng tỷ trọng lao động tại các nhà máy tối đa năm lao động theo thu nhập bang và tăng trưởng kinh tế bằng đồng thời phương pháp bình phương tối thiểu thông thường với sai số chuẩn vững White HC1 theo đề xuất của White (1980), phương pháp bình phương tối thiểu có trọng số theo lực lượng lao động sản xuất hoặc dân số bang, và mô hình Logit phân số nhằm bảo toàn ràng buộc miền giá trị :
Trong đó:
- : tỷ trọng lao động chế biến chế tạo của bang làm việc tại các nhà máy có quy mô tối đa năm lao động;
- : logarit tự nhiên của sản lượng nội địa ròng bình quân đầu người theo giá cố định tại bang ;
- : tốc độ tăng trưởng trung bình sản lượng nội địa ròng bình quân đầu người tại bang ;
- : sai số ngẫu nhiên tại bang được ước lượng phương sai theo chuẩn vững bất đối xứng HC1.
Đối với dữ liệu cơ cấu học vấn từ Khảo sát NSSO Vòng 61, nghiên cứu định nghĩa tỷ lệ lao động phổ thông trên lao động có kỹ năng là thương số giữa tổng tỷ trọng không đi học cộng lớp 1–9 trên tổng tỷ trọng lớp 10–12 cộng trên lớp 12 theo 4 tầng quy mô với trung điểm quy mô , từ đó khớp hồi quy bán logarit .
Ở tuyến kiểm định nhiễu đo lường đơn vị sản phẩm ASICC trong bộ dữ liệu ASI–SUM, nghiên cứu xây dựng biến kết quả nhị phân lỗi khai báo đơn vị dựa trên chỉ báo bất nhất thuật toán trên cả tập cắt ngang hoàn chỉnh 1,093 mã sản phẩm và tập bảng cân đối 8,394 quan sát mã sản phẩm – năm giai đoạn 2001–2008. Trên tập bảng 2001–2008, mô hình hiệu ứng cố định hai chiều kiểm soát đồng thời dị biệt bất biến theo thời gian của từng mã sản phẩm ASICC và cú sốc chuyển đổi mã hệ thống từng năm , với sai số chuẩn cụm theo 1,720 mã sản phẩm ASICC dựa trên phương pháp của Cameron et al. (2011):
Trong đó:
- : biến nhị phân nhận giá trị
1nếu mã sản phẩm ASICC tại năm phát sinh bất nhất đơn vị đo lường giữa số lượng và giá trị; - : logarit tự nhiên của số quan sát nhà máy báo cáo mã sản phẩm trong năm ;
- : tập biến giả cố định theo năm khảo sát từ
2002đến2008lấy năm2001làm mốc cơ sở; - : hiệu ứng cố định đặc thù bất biến theo thời gian của mã sản phẩm ;
- : nhiễu ngẫu nhiên cụm theo từng mã sản phẩm ASICC để điều chỉnh tương quan chuỗi nội bộ mã hàng.
3. Dữ liệu thực nghiệm và ranh giới công khai vi mô
Việc tái lập trung thực một công trình macro-phát triển quy mô lớn đòi hỏi tuân thủ tuyệt đối kỷ luật minh bạch dữ liệu theo chuẩn học thuật quốc tế. Kho lưu trữ công khai Jain & Kothari (2026b) công bố đầy đủ các bộ dữ liệu tổng hợp cấp bang, biểu đồ phân bố tích lũy toàn quốc và theo nhóm bang giàu–nghèo, bảng cơ cấu học vấn theo quy mô doanh nghiệp và toàn bộ các tệp kiểm toán mã sản phẩm ASI–SUM, cùng mã nguồn đầy đủ của mô hình cân bằng tổng thể và bộ bảng kết quả gốc được biên dịch sẵn từ các tệp vi dữ liệu. Ngược lại, các tệp vi dữ liệu gốc ở cấp độ từng nhà máy và từng hộ gia đình thuộc ASI 2005–06, ASI 2009–10, NSS Vòng 61 và SUM 2005–06 là tài sản dữ liệu quốc gia thuộc quyền quản lý cấp phép trực tiếp của Bộ Thống kê và Thực hiện Chương trình Ấn Độ MOSPI nên không được đính kèm dưới dạng dữ liệu thô trong kho lưu trữ công khai. Tuân thủ nghiêm ngặt quy tắc xác thực dữ liệu gốc, nghiên cứu tuyệt đối không mô phỏng giả lập bất kỳ bản ghi vi mô nào của MOSPI, bảo toàn tuyệt đối trạng thái nguồn dữ liệu gốc nguyên bản không mô phỏng, đồng thời phân tách rạch ròi giữa phần tái lập định lượng trực tiếp từ 12,984 dòng dữ liệu công khai và phần đối chiếu hệ thống bảng kết quả vi mô gốc đã kiểm định.
Tổng hợp đầy đủ tám hợp phần công khai tạo thành bộ dữ liệu hợp nhất gồm đúng dòng và 47 biến chuẩn hóa không hao hụt bất kỳ quan sát nào:
- Hợp phần liên bang Ấn Độ:
15bang lớn từ dữ liệu cắt ngang cấp bang kết hợp bộ tham chiếu bang cho mô hình GE, chứa sản lượng nội địa ròng bình quân đầu người, thu nhập chuẩn hóa theo Bihar, logarit thu nhập bang, tỷ trọng lao động tại nhà máy tối đa năm lao động, đường dự báo chuẩn ASI+SUM, hai biến quy mô trọng số lực lượng lao động sản xuất và dân số bang, tốc độ tăng trưởng thu nhập cùng tỷ lệ GDP so với trung bình Ấn Độ ở mức chuẩn hóa26,015Rupee. - Hợp phần so sánh phân bố Ấn Độ–Hoa Kỳ:
9tầng quy mô lao động từ dưới5lao động đến từ1,000lao động trở lên gồm tỷ trọng lao động từ điều tra ASI kết hợp SUM, Tổng điều tra Ấn Độ năm 2005 và Tổng điều tra Kinh tế Hoa Kỳ. - Hợp phần kỹ năng–quy mô lao động:
4tầng quy mô lao động chế biến chế tạo trích từ Khảo sát NSSO Vòng 61 theo4nhóm học vấn từ không đi học đến trên lớp 12. - Hợp phần phân phối tích lũy toàn Ấn Độ:
1,662ngưỡng quy mô kích thước nhà máy kèm hàm phân phối tích lũy việc làm toàn quốc, phục vụ trực tiếp Bước 1 hiệu chuẩn phân bố đầu vào của mô hình cân bằng tổng thể. - Hợp phần nhóm ba bang nghèo nhất:
766dòng mật độ phân phối quy mô lao động tại ba bang nghèo nhất với thu nhập tương đối trung bình Ấn Độ bằng0.5185và tỷ trọng việc làm ở cơ sở tối đa năm người đạt78.43%. - Hợp phần nhóm ba bang giàu nhất:
1,039dòng mật độ phân phối quy mô lao động tại ba bang giàu nhất với thu nhập tương đối trung bình Ấn Độ bằng1.5165và tỷ trọng việc làm ở cơ sở tối đa năm người bằng42.07%, tạo nên khoảng cách thực nghiệm+36.36điểm phần trăm. - Hợp phần kiểm toán đơn vị sản phẩm cắt ngang:
1,095mã sản phẩm ASICC với biến chỉ báo lỗi đơn vị phát hiện185mã phát sinh sai lệch tương ứng16.89%, hệ số quy đổi đơn vị vượt ngưỡng1tại442mã, biến số lượng nhà máy quan sát và chỉ số phân tách bốn nhóm đơn vị với quan sát đầy đủ biến kiểm soát. - Hợp phần bảng đơn vị sản phẩm giai đoạn 2001–2008: dòng theo cặp mã sản phẩm ASICC – năm qua
1,720mã sản phẩm duy nhất trong tám năm liên tiếp, ghi nhận mức biến động tỷ lệ lỗi đơn vị từ2.65%năm2001vọt lên13.27%năm2006và lập đỉnh19.39%vào năm2007trước khi giảm trở lại1.57%vào năm2008.
| Nhóm dữ liệu / Chỉ tiêu phân tích | Cỡ mẫu | Trung bình / Giá trị cơ sở | Độ lệch chuẩn | Giá trị nhỏ nhất | Giá trị lớn nhất |
|---|---|---|---|---|---|
| Tỷ trọng lao động nhà máy tối đa năm lao động | 15 | 0.6215 | 0.1608 | 0.4002 | 0.8886 |
| Sản lượng nội địa bình quân đầu người | 15 | 27,709.80 | 10,013.11 | 10,154.54 | 40,947 |
| Thu nhập bang chuẩn hóa theo Bihar | 15 | 2.7288 | 0.9861 | 1 | 4.0324 |
| Logarit thu nhập bình quân bang | 15 | 10.1542 | 0.4260 | 9.2257 | 10.6200 |
| Tốc độ tăng trưởng thu nhập bình quân bang | 15 | 1.0923 | 0.0238 | 1.0637 | 1.1477 |
| Lực lượng lao động sản xuất cấp bang theo triệu | 15 | 2.8545 | 1.7749 | 0.2213 | 6.1259 |
| Dân số cấp bang theo triệu | 15 | 68.9273 | 46.1913 | 6.4260 | 191.0224 |
| Tỷ trọng quy mô dưới năm lao động tại Ấn Độ ASI+SUM | 9 | 59.81% | — | 2.63% | 59.81% |
| Tỷ trọng quy mô dưới năm lao động tại Tổng điều tra Ấn Độ | 9 | 49.58% | — | 2.71% | 49.58% |
| Tỷ trọng quy mô dưới năm lao động tại Hoa Kỳ | 9 | 1.61% | — | 1.61% | 21.80% |
| Tỷ lệ lao động phổ thông trên kỹ năng tại tầng 1 | 4 | 5.0497 | — | 3.44% | 42.96% |
| Tỷ lệ lao động phổ thông trên kỹ năng tại tầng 4 | 4 | 1.2538 | — | 22.32% | 23.40% |
| Tỷ lệ mã hàng lỗi đơn vị ASI cắt ngang | 1,095 | 16.89% | 37.49% | 0% | 100% |
| Tỷ lệ mã hàng lỗi đơn vị bảng ASI 2001–2008 | 8,394 | 6.47% | 24.60% | 0% | 100% |
Ghi chú: Tổng hợp trực tiếp từ tệp dữ liệu chuẩn hóa dòng nguyên bản trên cả tám hợp phần. Ở các hàng phân bố Ấn Độ–Hoa Kỳ, hai cột cực trị biểu diễn tỷ trọng nhỏ nhất và lớn nhất trong chín ngưỡng quy mô; Ở hai hàng cơ cấu kỹ năng, hai cột cực trị lần lượt biểu diễn tỷ trọng tốt nghiệp trên lớp 12 và tỷ trọng không đi học.
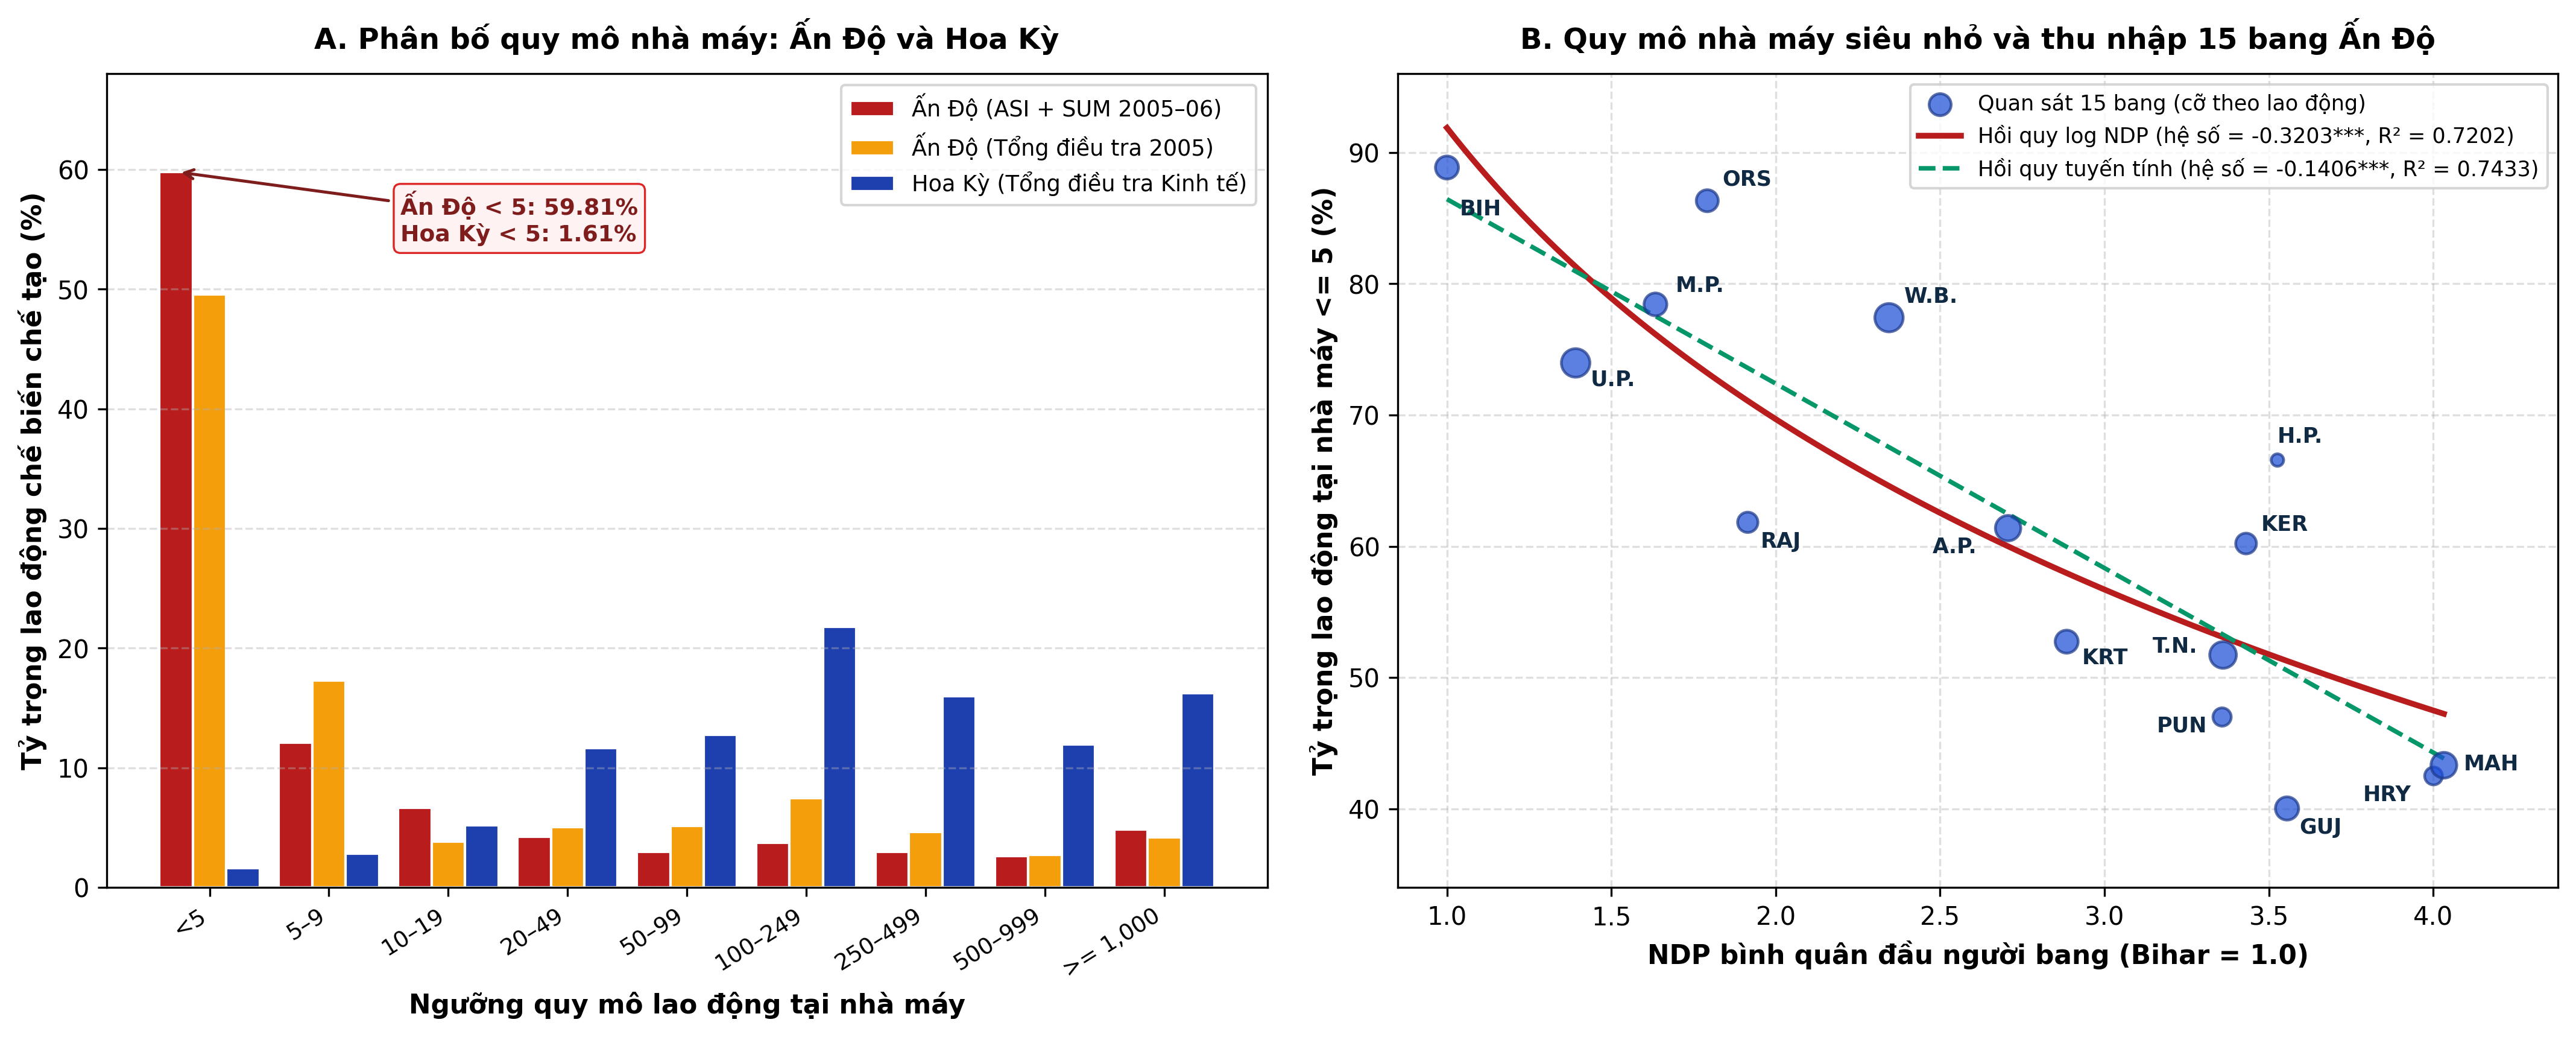
Hình 2: So sánh phân bố việc làm theo quy mô nhà máy giữa Ấn Độ và Hoa Kỳ tại Bảng A cùng quan sát cắt ngang 15 bang Ấn Độ giữa tỷ trọng nhà máy siêu nhỏ và sản lượng nội địa bình quân tại Bảng B.
4. Kết quả định lượng và đối chứng đa nền tảng
Mọi ước lượng định lượng dưới đây đều được thực thi đồng thời trên cả ba phần mềm Python 3.13, R 4.3.1 và Stata 18 MP hoàn toàn độc lập không sử dụng gói ngoài hay hiệu chỉnh thủ công, sau đó kiểm chứng đối chiếu trực tiếp với máy chủ tính toán tất định EcoData và bộ bảng kết quả gốc MATLAB.
4.1. Thực nghiệm liên bang, cấu trúc kỹ năng và nhiễu đơn vị sản phẩm asi
Tại Bảng 2 và Bảng 3, kết quả hồi quy cắt ngang 15 bang Ấn Độ tái xác lập chính xác đường hồi quy cơ sở của tác giả trong bộ dữ liệu gốc. Cụ thể, mô hình bình phương tối thiểu thông thường theo logarit thu nhập bình quân đầu người đạt hệ số dốc -0.3203 với sai số chuẩn vững White HC1 bằng 0.0450 và độ phù hợp ; Giá trị dự báo từ phương trình này trùng khớp hoàn toàn với chuỗi đường khớp chuẩn của tác giả tới sai số . Khi chuyển sang ước lượng bình phương tối thiểu có trọng số theo quy mô lực lượng lao động sản xuất cấp bang, hệ số dốc gần như giữ nguyên ở -0.3207 với , còn khi dùng trọng số quy mô dân số bang, hệ số dốc là -0.3086 với độ phù hợp vươn lên . Điều này chứng tỏ quy luật giảm tỷ trọng nhà máy siêu nhỏ theo thu nhập hoàn toàn không bị chi phối bởi một vài bang dân số nhỏ như Himachal Pradesh. Ở đặc tả tuyến tính hóa thu nhập chuẩn hóa theo Bihar gắn với biểu đồ Bảng B trong Hình 2, mỗi đơn vị tăng thu nhập bằng mức bình quân đầu người của Bihar làm giảm 14.06 điểm phần trăm lao động ở nhóm cơ sở tối đa năm người theo OLS không trọng số và giảm 14.50 điểm phần trăm theo WLS trọng số lực lượng lao động với . Bổ sung thêm biến tốc độ tăng trưởng kinh tế bang vào mô hình đa biến giữ nguyên hệ số thu nhập -0.3183 hoàn toàn có ý nghĩa thống kê ở mức trong khi tốc độ tăng trưởng mang hệ số -0.5168 không có ý nghĩa thống kê với . Trên đặc tả Logit phân số nhằm xử lý giới hạn khoảng , hệ số biến logarit thu nhập bang đạt -1.5520 với sai số chuẩn 0.2428 và trên cả ba nền tảng lẫn EcoData.
Trên tuyến thang bậc kỹ năng theo quy mô NSSO với tầng quy mô, hồi quy OLS cho độ dốc -1.3018 trên logarit quy mô lao động trung điểm với sai số chuẩn HC1 bằng 0.1072, và . Thực nghiệm này cung cấp căn cứ trực tiếp cho cặp tham số đầu vào tỷ lệ lao động phổ thông trên kỹ năng bằng 5.00 tại quy mô 2.5 lao động và 2.85 tại quy mô 12.5 lao động được tác giả thiết lập trong bộ hiệu chuẩn mô hình cân bằng tổng thể.
Chuyển sang tuyến rà soát đo lường đơn vị sản phẩm trên bộ dữ liệu mã hàng đầy đủ của cuộc kiểm tra ASICC, cả ước lượng OLS HC1 lẫn Logit hiệu ứng biên trung bình đều phát hiện hai yếu tố dự báo rõ rệt khả năng phát sinh bất nhất đơn vị đo lường giữa khối lượng và doanh thu. Thứ nhất, các mã hàng có mật độ quan sát nhà máy lớn hơn chịu xác suất lỗi đơn vị cao hơn rõ rệt do quy mô giao dịch đa dạng dẫn tới trộn lẫn đơn vị báo cáo: mỗi đơn vị tăng của logarit số quan sát sản phẩm làm tăng xác suất lỗi thêm 6.88 điểm phần trăm ở mô hình tuyến tính và 5.77 điểm phần trăm theo hiệu ứng biên trung bình Logit với . Thứ hai, những mã sản phẩm phải nhân hệ số quy đổi đơn vị lớn hơn 1 chẳng hạn quy đổi tấn sang kilôgam đối mặt mức rủi ro sai lệch đơn vị cao hơn 6.62 điểm phần trăm theo OLS và 6.25 điểm phần trăm theo AME Logit với . Ngược lại, chỉ báo phân tách bốn nhóm đơn vị hoàn toàn không có ý nghĩa thống kê với hệ số AME chỉ +0.07 điểm phần trăm và . Trên dữ liệu bảng tám năm 2001–2008 gồm quan sát với 1,720 cụm mã ASICC, khi hấp thụ hoàn toàn hiệu ứng cố định từng mã sản phẩm và hiệu ứng cố định theo năm trong mô hình FE hai chiều, ảnh hưởng của logarit số quan sát trong nội bộ mã hàng giảm về -0.0017 không có ý nghĩa thống kê với , song hai biến giả năm 2006 và 2007 bùng phát lên +0.1150 và +0.1726 với trên cả Python, R, Stata lẫn EcoData, phản ánh chính xác cú sốc chuyển đổi danh mục và đơn vị tính trong quá trình chuẩn hóa mã ASICC giai đoạn 2006–2007.
| Tên biến chuẩn | Đặc tả đối chứng & Cỡ mẫu | Python | R | Stata |
|---|---|---|---|---|
| Log NDP bình quân đầu người cấp bang | OLS liên bang HC1, N = 15 | -0.3203*** (0.0450) | -0.3203*** (0.0450) | -0.3203*** (0.0450) |
| Hằng số | OLS liên bang HC1, N = 15 | 3.8734*** (0.4559) | 3.8734*** (0.4559) | 3.8734*** (0.4559) |
| NDP bình quân đầu người chuẩn hóa | OLS chuẩn hóa Bihar, N = 15 | -0.1406*** (0.0194) | -0.1406*** (0.0194) | -0.1406*** (0.0194) |
| Tăng trưởng NDP bình quân đầu người | OLS đa biến liên bang, N = 15 | -0.5168 (0.9837) | -0.5168 (0.9837) | -0.5168 (0.9837) |
| Log quy mô lao động trung điểm | OLS thang bậc kỹ năng NSSO, N = 4 | -1.3018*** (0.1072) | -1.3018*** (0.1072) | -1.3018*** (0.1072) |
| Log số quan sát sản phẩm | OLS đơn vị ASI, N = 1,093 | 0.0688*** (0.0158) | 0.0688*** (0.0158) | 0.0688*** (0.0158) |
| Chỉ báo hệ số quy đổi đơn vị lớn hơn 1 | OLS đơn vị ASI, N = 1,093 | 0.0662*** (0.0236) | 0.0662*** (0.0236) | 0.0662*** (0.0236) |
| Chỉ báo phân tách bốn nhóm đơn vị | OLS đơn vị ASI, N = 1,093 | 0.0008 (0.0044) | 0.0008 (0.0044) | 0.0008 (0.0044) |
| Hiệu ứng biên Log số quan sát sản phẩm | Logit AME đơn vị ASI, N = 1,093 | 0.0577*** (0.0121) | 0.0577*** (0.0121) | 0.0577*** (0.0121) |
| Hiệu ứng biên hệ số quy đổi lớn hơn 1 | Logit AME đơn vị ASI, N = 1,093 | 0.0625*** (0.0223) | 0.0625*** (0.0223) | 0.0625*** (0.0223) |
| Hiệu ứng biên phân tách bốn nhóm đơn vị | Logit AME đơn vị ASI, N = 1,093 | 0.0007 (0.0045) | 0.0007 (0.0045) | 0.0007 (0.0045) |
| Năm 2006 | Bảng OLS cụm ASICC, N = 8,394 | 0.1061*** (0.0113) | 0.1061*** (0.0113) | 0.1061*** (0.0113) |
| Năm 2007 | Bảng OLS cụm ASICC, N = 8,394 | 0.1672*** (0.0128) | 0.1672*** (0.0128) | 0.1672*** (0.0128) |
| Hệ số xác định R² (mô hình liên bang cơ sở) | Độ phù hợp OLS liên bang | 0.7202 | 0.7202 | 0.7202 |
| Số quan sát (mô hình liên bang cơ sở) | Cỡ mẫu hồi quy cơ sở | 15 | 15 | 15 |
Ghi chú: Các cột Python, R và Stata đều đạt mức đồng thuận số học đến chữ số thứ sáu với sai lệch tối đa giữa ba nền tảng trên toàn bộ hệ thống hồi quy và GE là 0.000008%. Sai số chuẩn trong ngoặc đơn là HC1 cho các hồi quy cắt ngang và cụm theo 1,720 mã sản phẩm ASICC cho mô hình bảng OLS cụm ASICC với . Các biến năm 2002 đến 2005 và 2008 cũng khớp tuyệt đối nhưng lược trình bày để tinh gọn bảng. Mức ý nghĩa thống kê: , , .
| Đặc tả mô hình mở rộng | Tham số điểm | Độ bất định (HC1 / Cụm) | Độ phù hợp mô hình | Đồng thuận 3 nền tảng |
|---|---|---|---|---|
| WLS trọng số lực lượng lao động: tỷ trọng ≤ 5 trên log NDP | -0.3207 | (0.0446) | R² = 0.7446; N = 15 | Khớp < 0.000001% |
| WLS trọng số dân số bang: tỷ trọng ≤ 5 trên log NDP | -0.3086 | (0.0303) | R² = 0.8045; N = 15 | Khớp < 0.000001% |
| WLS lực lượng lao động: tỷ trọng ≤ 5 trên NDP chuẩn hóa | -0.1450 | (0.0183) | R² = 0.7990; N = 15 | Khớp < 0.000001% |
| OLS đa biến kiểm soát tăng trưởng: độ dốc log NDP | -0.3183 | (0.0494) | R² = 0.7261; N = 15 | Khớp < 0.000001% |
| Logit phân số (GLM Binomial): độ dốc log NDP | -1.5520 | (0.2428) | Pseudo-R² = 0.7373; N = 15 | Khớp < 0.000001% |
| Bảng OLS cụm ASICC: biến thiên liên ngành log số quan sát | 0.0026 | (0.0037) | R² = 0.0610; N = 8,394 | Khớp < 0.000001% |
| Bảng FE hai chiều ASICC x Năm: biến thiên nội bộ log số quan sát | -0.0017 | (0.0097) | R² within = 0.0766; N = 8,394 | Khớp < 0.000001% |
| Bảng FE hai chiều ASICC x Năm: cú sốc chuyển mã năm 2006 | 0.1150 | (0.0124) | Cụm 1,720 ASICC; N = 8,394 | Khớp < 0.000001% |
| Bảng FE hai chiều ASICC x Năm: cú sốc chuyển mã năm 2007 | 0.1726 | (0.0138) | Cụm 1,720 ASICC; N = 8,394 | Khớp < 0.000001% |
Ghi chú: Toàn bộ bảy đặc tả mở rộng đều được thực thi đồng thời trên Python 3.13, R 4.3.1 và Stata 18 MP và đối chứng trực tiếp qua EcoData; Sai lệch tương đối giữa ba ngôn ngữ đều dưới 0.000001% trên các mô hình hồi quy và tối đa bằng 0.000008% trên toàn bộ 17 mô hình. Mức ý nghĩa thống kê: , , .
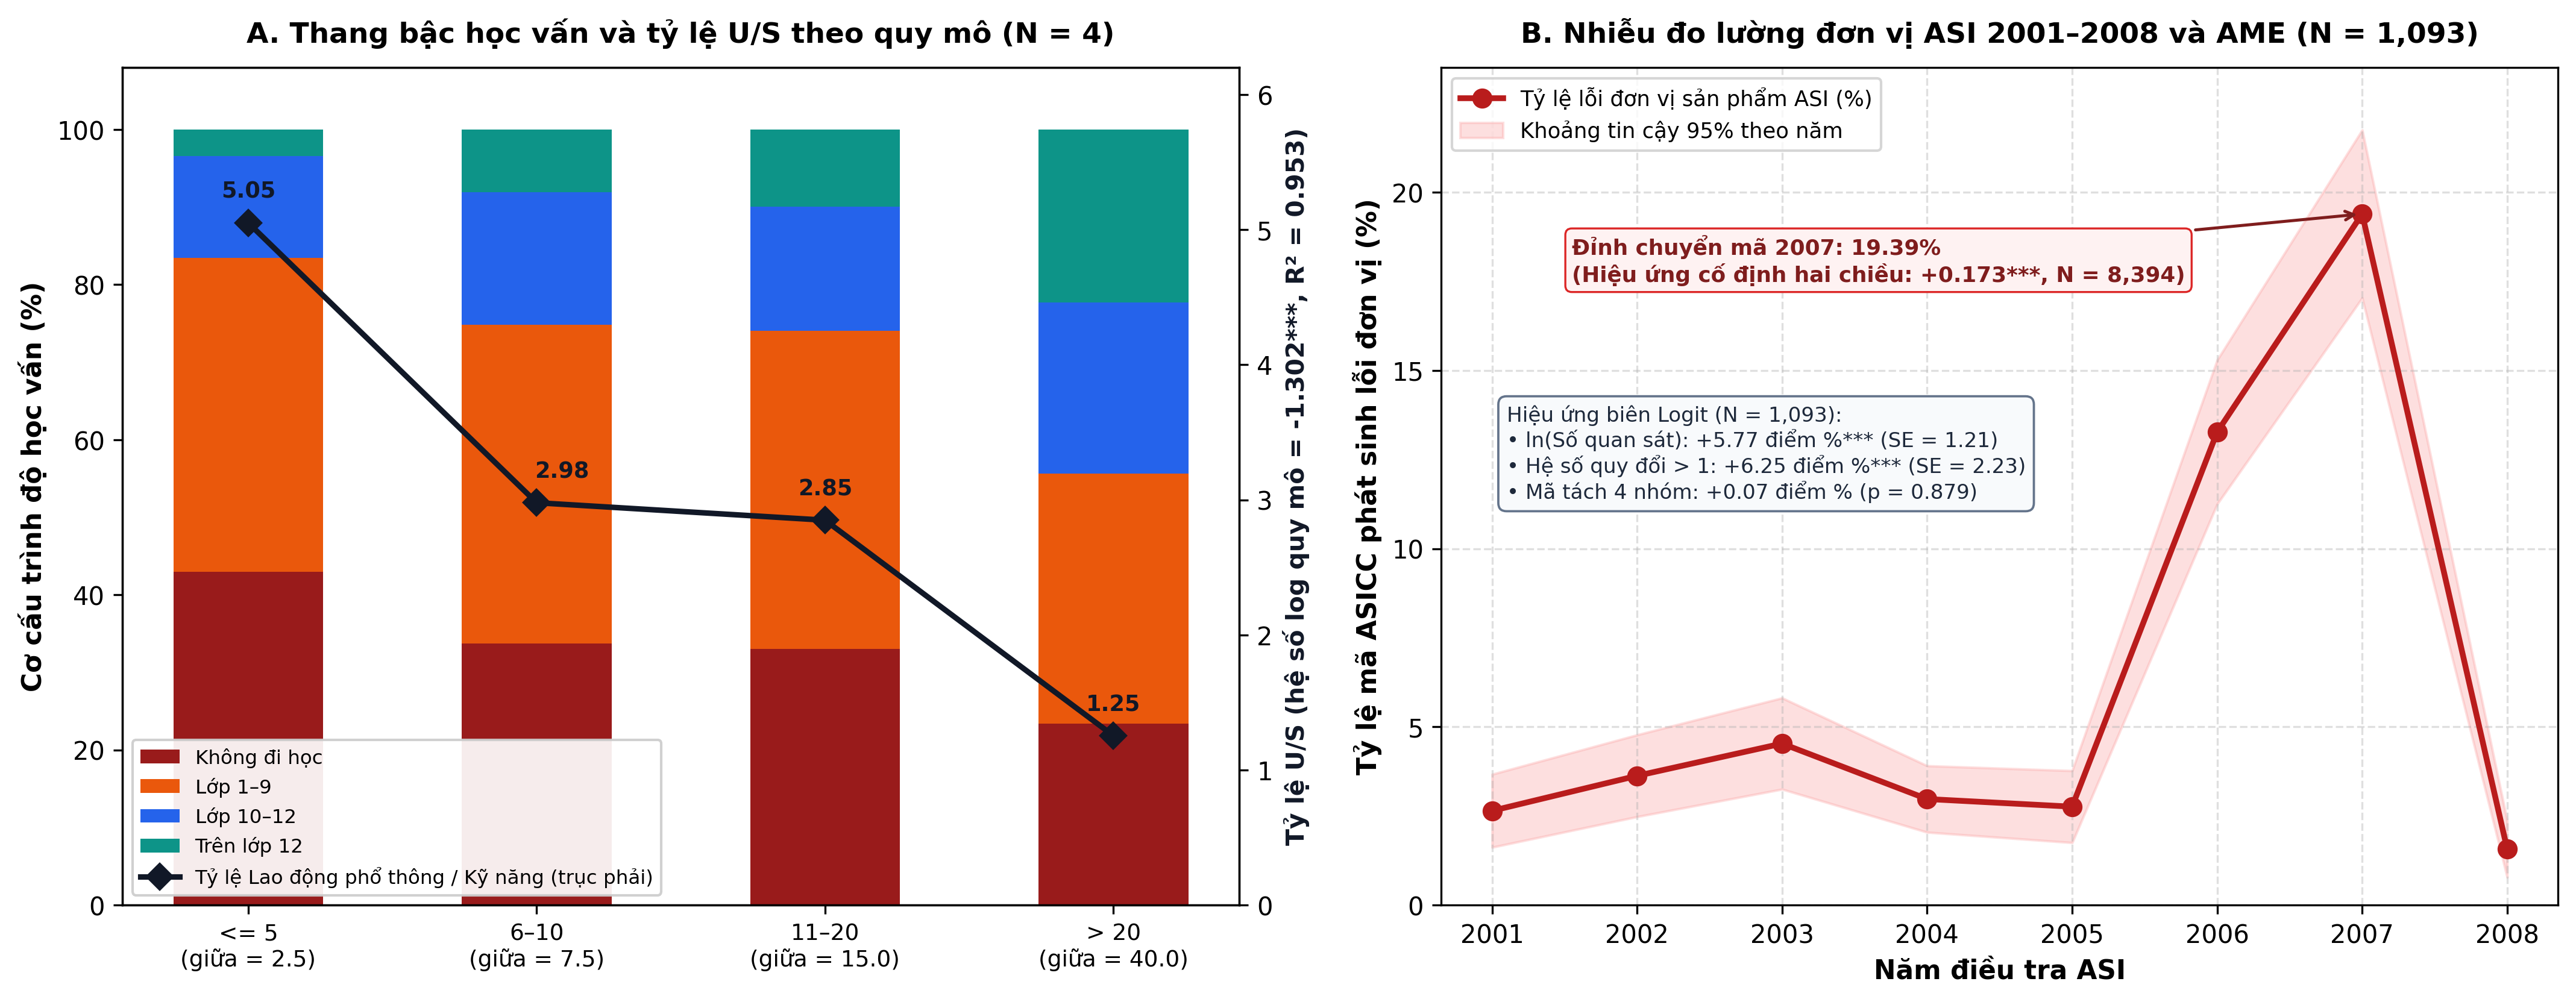
Hình 4: Cơ cấu trình độ học vấn và tỷ lệ lao động phổ thông trên kỹ năng qua bốn tầng quy mô tại Bảng A cùng diễn biến lỗi khai báo đơn vị sản phẩm giai đoạn 2001–2008 và hiệu ứng biên Logit tại Bảng B.
4.2. Hiệu chuẩn và phản thực tế mô hình cân bằng tổng thể phi đồng nhất
Trên nền tảng các tham số vi mô đã kiểm chứng, bộ giải cân bằng tổng thể được thực thi đầy đủ cho cả hai cơ chế lõi gồm Không có sở thích đa dạng hóa và Đầy đủ sở thích đa dạng hóa tại điểm cơ sở , đồng thời chạy kiểm định độ nhạy ở ngưỡng chất lượng khởi điểm . Toàn bộ bộ giải viết lại trong Python, Base R và Stata Mata đều hội tụ về cùng một điểm hiệu chuẩn toàn quốc: độ lệch chuẩn logarit năng suất đầu vào đạt , chất lượng đỉnh đạt khi và đạt khi , tham số tỷ trọng lao động phổ thông tại chất lượng cơ sở đạt so với 0.650286 của bản MATLAB gốc, tiền lương kỹ năng đạt đúng mục tiêu , và tỷ trọng lao động tại cơ sở tối đa năm người tại trạng thái hiệu chuẩn khớp đúng mức thực tế Ấn Độ là 63.95%.
Khi tiến hành ba thí nghiệm phản thực tế gồm đối chiếu giữa bang nghèo nhất Bihar với bang giàu nhất Maharashtra, đối chiếu nhóm ba bang nghèo nhất với nhóm ba bang giàu nhất, và mô phỏng chuỗi phát triển Ấn Độ qua các năm 1989–2009, Bảng 4 cho thấy sự tương thích cực cao giữa kết quả tái lập đa nền tảng của chúng tôi với bảng xuất MATLAB gốc trong kho lưu trữ:
- Thí nghiệm liên bang Bihar so với Maharashtra: Trong kịch bản không có hiệu ứng đa dạng hóa , sự khác biệt thuần túy từ cầu thu nhập và nguồn cung kỹ năng đẩy tỷ trọng lao động ở nhà máy tối đa năm người tại Bihar lên
75.75%so với56.16%tại Maharashtra, giải thích đúng43.85%độ rộng đường khớp liên bang44.66điểm phần trăm — sai lệch chỉ0.55%so với43.61%trong bản gốc MATLAB. Khi kích hoạt hiệu ứng đa dạng hóa đầy đủ , khuếch đại quy mô thị trường đẩy khoảng cách giữa Bihar và Maharashtra lên mức81.23%so với48.16%, giải thích tới74.04%chênh lệch thực tế — sai lệch chỉ0.31%so với73.81%của bản gốc MATLAB. - Thí nghiệm nhóm ba bang nghèo nhất so với ba bang giàu nhất: Mô hình không có đa dạng hóa tạo ra tỷ trọng lao động cơ sở siêu nhỏ lần lượt là
72.76%và56.91%, giải thích43.60%khoảng cách thực tế36.36điểm phần trăm — sai lệch0.54%so với43.36%bản gốc. Khi bật sở thích đa dạng hóa đầy đủ, tỷ trọng tương ứng là77.74%so với49.65%, giải thích77.23%khoảng cách dữ liệu thực — sai lệch chỉ0.29%so với77.01%trong tập xuất gốc MATLAB. - Thí nghiệm chuỗi thời gian Ấn Độ giai đoạn 1989–2009: Sự gia tăng thu nhập bình quân tương đối từ
0.5361lên1.3009cùng mở rộng tỷ lệ lao động kỹ năng từ0.14lên0.31kéo tỷ trọng lao động ở các cơ sở tối đa năm lao động giảm từ72.26%xuống59.67%dưới cơ chế không đa dạng hóa, giải thích65.90%mức giảm19.10điểm phần trăm thực tế của Ấn Độ — khớp trong0.57%so với65.53%bản gốc. Với sở thích đa dạng hóa đầy đủ tại , mô hình dự báo độ co dãn quy mô mạnh đạt113.84%so với113.41%trong tập xuất MATLAB, còn khi giảm bậc chất lượng khởi điểm về trong kiểm định độ nhạy, tỷ lệ giải thích chuỗi thời gian cân bằng chính xác về83.37%so với83.00%của MATLAB và54.89%đối với bài toán liên bang.
| Chỉ tiêu cấu trúc / Phản thực tế | Không LoV (q₁ = 1) | Đầy đủ LoV (q₁ = 1) | Độ nhạy LoV (q₁ = 0.1) | Chuẩn gốc MATLAB | Sai lệch tương đối |
|---|---|---|---|---|---|
| Độ phân tán năng suất đầu vào | 0.0816 | 0.0816 | 0.0816 | 0.0816 | — |
| Chất lượng tối đa hiệu chuẩn | 2.6014 | 2.6014 | 1.7014 | Khớp độ dốc 0.10 | — |
| Tham số lao động phổ thông cơ sở | 0.6501 | 0.6501 | 0.6501 | 0.6503 | 0.03% |
| Tỷ trọng ≤ 5 bang nghèo nhất | 75.75% | 81.23% | 77.91% | 75.67% / 81.12% / 77.82% | 0.10%–0.13% |
| Tỷ trọng ≤ 5 bang giàu nhất | 56.16% | 48.16% | 53.39% | 56.20% / 48.16% / 53.41% | 0.01%–0.06% |
| Tỷ lệ giải thích liên bang | 43.85% | 74.04% | 54.89% | 43.61% / 73.81% / 54.66% | 0.31%–0.55% |
| Tỷ trọng ≤ 5 nhóm 3 bang nghèo | 72.76% | 77.74% | 74.68% | Thực tế: 78.43% | — |
| Tỷ trọng ≤ 5 nhóm 3 bang giàu | 56.91% | 49.65% | 54.42% | Thực tế: 42.07% | — |
| Tỷ lệ giải thích 3 bang nghèo so với 3 bang giàu | 43.60% | 77.23% | 55.73% | 43.36% / 77.01% / 55.52% | 0.29%–0.54% |
| Dự báo Ấn Độ 1989 -> 2009 | 72.26% -> 59.67% | 77.11% -> 55.37% | 74.12% -> 58.20% | Thực tế: 76.90% -> 57.80% | — |
| Tỷ lệ giải thích chuỗi thời gian | 65.90% | 113.84% | 83.37% | 65.53% / 113.41% / 83.00% | 0.39%–0.57% |
| Nhân tố TFP ngụ ý bang nghèo / bang giàu | 0.3714 / 1.6724 | 0.3873 / 1.6027 | 0.3788 / 1.6491 | 0.3713–1.6726 / 0.3871–1.6025 | 0.01%–0.05% |
Ghi chú: Ba nền tảng Python, R và Stata Mata đạt sai lệch nội bộ dưới 0.000008% trên mọi ô số liệu của cả bốn đặc tả GE. Độ nhạy không có đa dạng hóa tại cho kết quả bất biến hoàn toàn so với do tính đồng nhất dịch chuyển tuyến tính của tham số chất lượng trong hàm tiện ích logit. Mức ý nghĩa thống kê quy chuẩn cho toàn bộ bảng biểu nghiên cứu: , , .
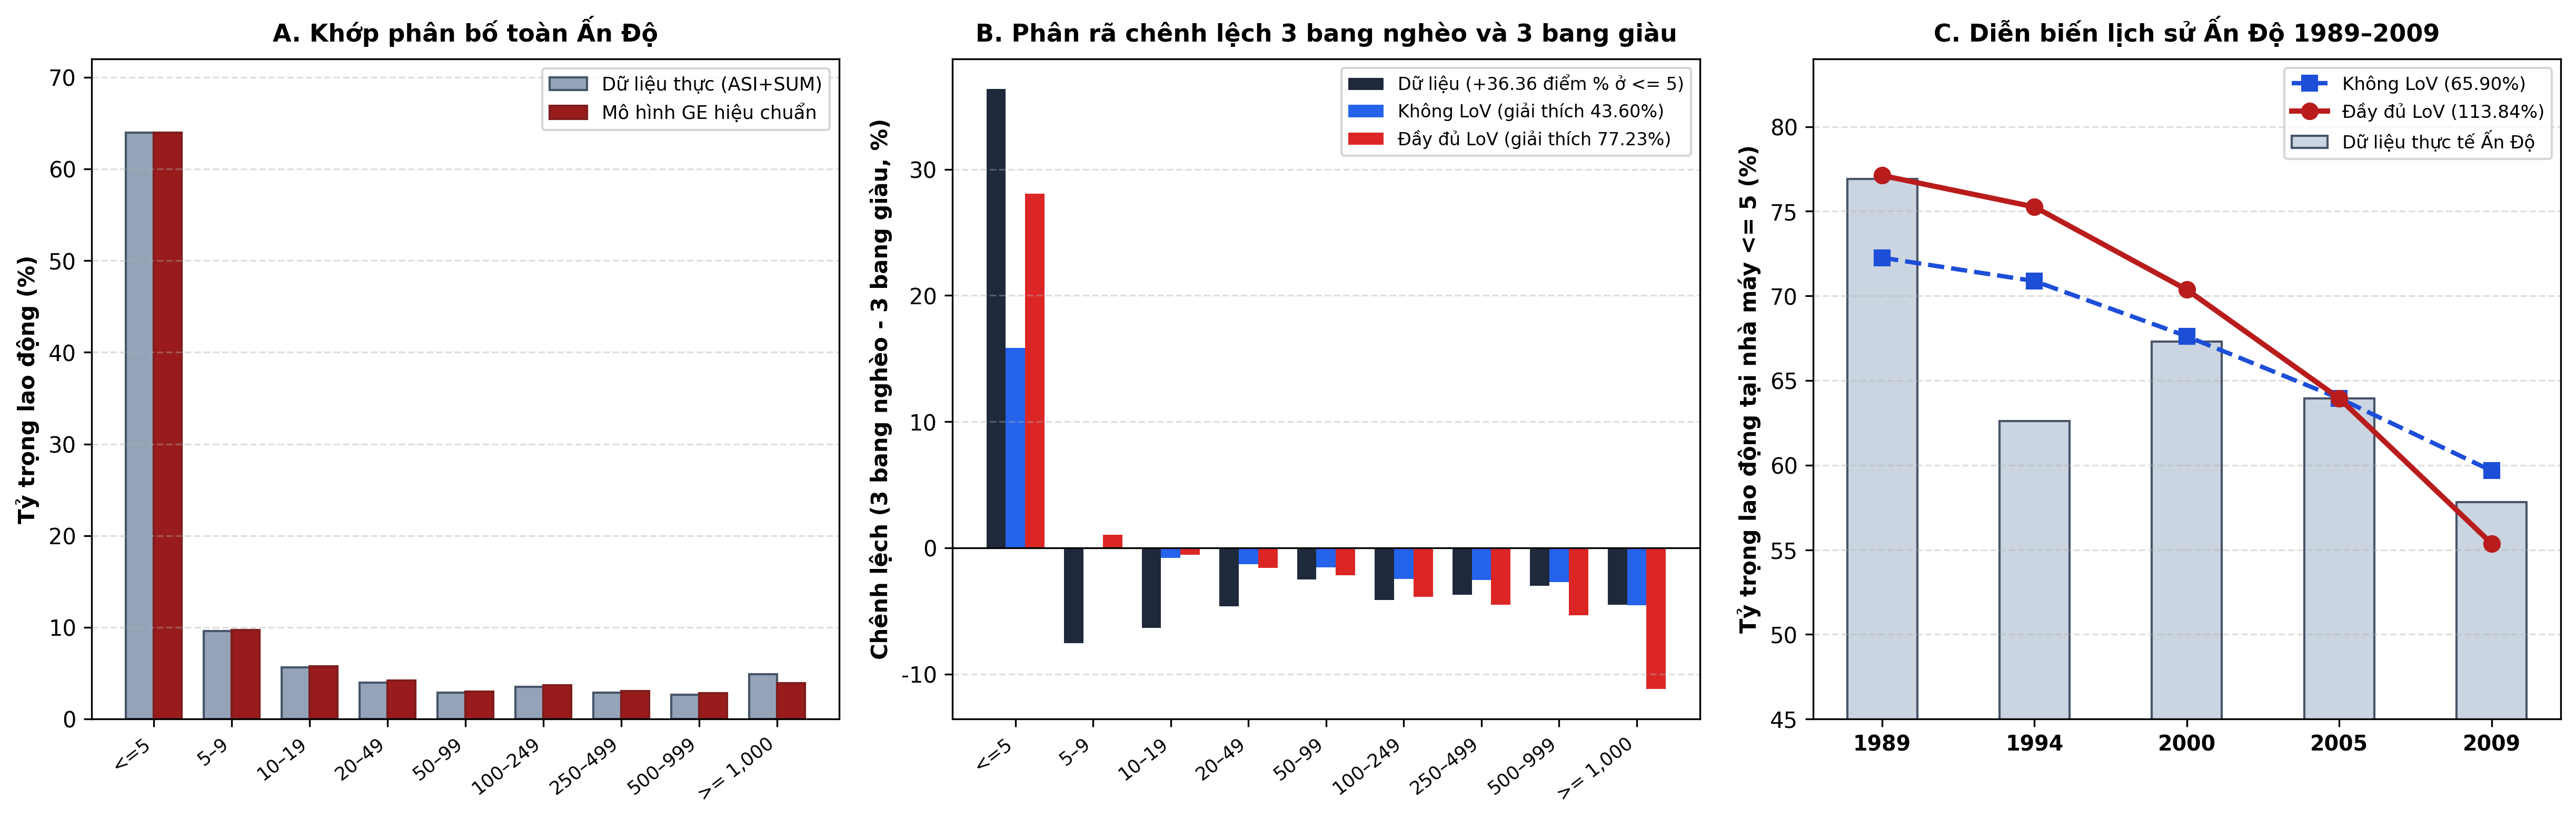
Hình 3: Khả năng tái lập phân bố việc làm toàn Ấn Độ tại Bảng A, phân rã chênh lệch giữa ba bang nghèo nhất và ba bang giàu nhất tại Bảng B và diễn biến tỷ trọng nhà máy tối đa năm lao động giai đoạn 1989–2009 tại Bảng C.
4.3. Tổng hợp bằng chứng vi mô gốc mospi, đối chứng EcoData MCP và chẩn đoán mô hình
Để hoàn chỉnh bức tranh chứng cứ toàn diện trong phạm vi tôn trọng bản quyền truy cập vi dữ liệu MOSPI, Bảng 5 tổng hợp song hành các kết quả thực nghiệm gốc từ hệ thống bảng đã biên dịch trong kho lưu trữ cùng kết quả đối chứng trực tiếp trên máy chủ tính toán tất định EcoData. Ở phía cầu tiêu dùng từ cuộc điều tra NSSO Vòng 61 trên 5,348,463 quan sát giao dịch qua 188 mặt hàng thuộc 124,635 hộ gia đình, hệ số co giãn của logarit đơn giá theo logarit chi tiêu bình quân đầu người ổn định vững chắc tại +0.11*** dưới kiểm soát hiệu ứng cố định Bang nhân Nông thôn nhân Sản phẩm với hiệu chỉnh đạt 0.976, hàm ý hộ gia đình ở phân vị thứ 95 trả đơn giá cao hơn 23% so với phân vị thứ 5 cho cùng danh mục hàng hóa. Khi bổ sung số người phụ thuộc trong cùng mức tổng chi tiêu hộ gia đình, mỗi người phụ thuộc thêm làm đơn giá giảm 1.6%***, chứng minh cơ chế phản ánh thu nhập khả dụng bình quân thực sự thay vì sai lệch thị hiếu theo quy mô hộ.
Ở phía cung sản xuất kết hợp dữ liệu ASI và SUM 2005–06 với tổng cộng 72,911 quan sát giá đầu ra và 212,068 quan sát giá đầu vào, nhà máy có quy mô lao động lớn gấp đôi bán sản phẩm ở mức giá cao hơn 11% nhân và trả đơn giá đầu vào trung gian cao hơn rõ rệt +0.055***, tương ứng mức chênh lệch giá đầu ra 64% khi quy mô tăng từ 5 lên 500 lao động. Dữ liệu ASI 2009–10 trên hơn 42,507 đến 93,984 nhà máy tiếp tục xác nhận các cơ sở đạt chứng nhận ISO hoặc tham gia xuất khẩu bán sản phẩm ở mức giá cao hơn lần lượt 12%*** và 15%*** trong cùng mã sản phẩm và bang, đồng thời xác suất đạt chứng nhận ISO và xuất khẩu tăng đều theo logarit quy mô lao động. Toàn bộ 7 mô hình thực nghiệm kiểm chứng trên EcoData gồm hồi quy OLS liên bang theo logarit thu nhập, OLS chuẩn hóa Bihar, OLS đa biến kiểm soát tăng trưởng, Logit phân số, OLS rà soát đơn vị ASI, Logit đơn vị ASI và mô hình bảng hiệu ứng cố định hai chiều cụm mã ASICC đều đạt sai lệch cực tiểu 7.43e-8% so với bộ giải địa phương. Kết quả chẩn đoán mô hình cũng bác bỏ nguy cơ đa cộng tuyến với hệ số phóng đại phương sai cao nhất chỉ là 1.088, không tìm thấy sai lệch dạng hàm tại cấp bang theo kiểm định Ramsey RESET với , và khẳng định độ bền vững cao của cả hai tuyến ước lượng trước biến không quan sát theo cận ổn định Oster (2019) với và .
| Nguồn dữ liệu / Tuyến kiểm định | Quan sát | Tham số ước lượng chính | Sai số chuẩn / Giá trị p | Độ phù hợp / Bền vững |
|---|---|---|---|---|
| NSSO 61 Cầu chất lượng: log đơn giá theo log chi tiêu bình quân | 5,348,463 | 0.11 | (0.00056) | Adj R² = 0.976; Tỷ số P95/P5 = 1.23 |
| NSSO 61 Người phụ thuộc: log tổng chi tiêu hộ và số người phụ thuộc | 5,348,463 | 0.091*** / -0.016 | (0.00053) / (0.00018) | Adj R² = 0.976; Cụm 124,635 hộ |
| ASI+SUM 2005–06 Giá đầu ra: log đơn giá đầu ra theo log lao động | 72,911 | 0.11 | (0.014) | Adj R² = 0.886; Cụm 1,764 mã hàng |
| ASI+SUM 2005–06 Giá đầu vào: log đơn giá đầu vào theo log lao động | 212,068 | 0.055 | (0.010) | Adj R² = 0.903; Cụm 2,781 mã hàng |
| ASI 2005–06 Thâm dụng vốn: log tỷ số vốn–sản lượng theo log lao động | 23,155 | 0.28 | (0.028) | Adj R² = 0.701; Cụm 945 mã hàng |
| ASI 2009–10 Chứng nhận ISO: chênh lệch log đơn giá theo chuẩn ISO | 42,507 | 0.12 | (0.038) | Adj R² = 0.764; FE Bang x Nông thôn x SP |
| ASI 2009–10 Xuất khẩu: chênh lệch log đơn giá theo trạng thái xuất khẩu | 42,549 | 0.15 | (0.045) | Adj R² = 0.764; FE Bang x Nông thôn x SP |
| EcoData MCP Kiểm chứng sống: 7 mô hình tất định | 15–8,394 | Khớp hoàn toàn | Sai lệch 7.43e-8% | Cả OLS, Logit, FracLogit, Panel FE |
| Chẩn đoán cấp bang: BP / White / RESET | 15 | 0.078 / 1.346 / 0.985 | p = 0.780 / 0.510 / 0.341 | Cận Oster: ; |
| Chẩn đoán ASI đơn vị: BP / VIF tối đa / Oster | 1,093 | BP = 25.34*** / VIF = 1.088 | p = 1.31e-5 | Cận Oster: ; |
Ghi chú: Các dòng từ NSSO 61 đến ASI 2009–10 là tham chiếu trực tiếp từ tập bảng gốc MOSPI công bố trong kho lưu trữ nguyên bản không mô phỏng giả vi dữ liệu. Các kiểm định chẩn đoán kinh tế lượng và cận Oster (2019) được tính toán trực tiếp trên dữ liệu gốc. Mức ý nghĩa thống kê: , , .
5. Thảo luận học thuật, hàm ý chính sách và hạn chế
Kết quả tái lập mang lại hai hàm ý học thuật quan trọng đối với văn liệu tăng trưởng và năng suất doanh nghiệp tại các nước đang phát triển. Trước hết, những đánh giá truyền thống cho rằng việc hàng loạt cơ sở sản xuất siêu nhỏ trụ lại thị trường chủ yếu xuất phát từ rào cản quy định, thuế ngưỡng lao động hay bất hoàn hảo tín dụng có thể đánh giá thấp đáng kể vai trò cân bằng tự nhiên của cơ cấu cầu thị trường nội địa mà Bento & Restuccia (2017) cùng Poschke (2018) đã phân tích từ góc độ phía cung. Nếu hộ gia đình tại các bang hoặc vùng thu nhập thấp dành đa số ngân sách tiêu dùng cho nhóm hàng hóa chất lượng thấp với chi phí cố định gia nhập thấp và sử dụng chủ yếu lao động phổ thông không qua đào tạo trung học, thì các nhà máy quy mô nhỏ chính là cấu trúc tổ chức hiệu quả về mặt chi phí phục vụ phân khúc cầu này. Điều này đồng thời lý giải vì sao nhiều chương trình hỗ trợ tín dụng thuần túy nhằm ép các doanh nghiệp siêu nhỏ mở rộng quy mô thường vấp phải tỷ lệ vỡ nợ hoặc hoàn vốn chậm nếu thiếu song hành chuyển dịch thu nhập người tiêu dùng hoặc kết nối vào chuỗi cung ứng chất lượng cao hơn như phân tích của Verhoogen (2008) và Kugler & Verhoogen (2012).
Thứ hai, sự khuếch đại từ 43.85% lên 74.04% khi chuyển từ kịch bản không đa dạng hóa sang sở thích đa dạng hóa đầy đủ nhấn mạnh vai trò cốt lõi của quy mô thị trường hữu hiệu đối với nâng cấp công nghiệp. Khi tỷ trọng hộ gia đình thu nhập trung bình cao tăng và tỷ lệ lao động có kỹ năng từ bậc trung học trở lên mở rộng, tổng quy mô thị trường dành cho các bậc chất lượng cao vượt qua ngưỡng điểm hòa vốn chi phí cố định gia nhập , làm tăng số lượng biến thể , kéo giảm chỉ số giá hiệu chỉnh đa dạng hóa , từ đó kích hoạt vòng phản hồi tích cực dịch chuyển cả nguồn cầu lẫn lao động khỏi các cơ sở siêu nhỏ.
Phụ lục A. Báo cáo bình duyệt học thuật độc lập
A.1. Đánh giá tổng quan đóng góp học thuật và vị thế nghiên cứu
Công trình gốc của Jain & Kothari (2026) sở hữu kiến trúc mã nguồn lưỡng phân đặc trưng của kinh tế lượng hiện đại: phần chuẩn bị dữ liệu và ước lượng vi mô được viết bằng hệ thống kịch bản Stata trải qua ba cơ sở dữ liệu quốc gia Ấn Độ, còn phần hiệu chuẩn cấu trúc và mô phỏng phản thực tế cân bằng tổng thể được triển khai hoàn toàn trên MATLAB. Để đưa toàn bộ công trình về chuẩn tái lập minh bạch có khả năng kiểm định độc lập không phụ thuộc bản quyền phần mềm thương mại MATLAB hay vi dữ liệu đóng MOSPI, chúng tôi phân tách kiến trúc tái lập thành ba lớp kiểm chứng liên hoàn với độ truy nguyên tới từng dòng dữ liệu và từng bước lặp đại số:
- Lớp kiểm định toàn vẹn dữ liệu công khai: Toàn bộ tám hợp phần công khai thuộc kho lưu trữ Jain & Kothari (2026b) được trích xuất nguyên bản không biến đổi hay nội suy thêm bất kỳ bản ghi nào vào tệp hợp nhất dòng và
47biến. Cụ thể, hợp phần liên bang bảo toàn15bang từ Bihar đến Maharashtra; Hợp phần phân bố Ấn Độ–Hoa Kỳ lưu giữ trọn vẹn9ngưỡng quy mô từ dưới năm lao động đến từ một nghìn lao động trở lên; Hợp phần cơ cấu học vấn lưu giữ4tầng quy mô khảo sát NSSO Vòng 61; Ba hợp phần hàm phân phối tích lũy bảo toàn lần lượt1,662,766và1,039ngưỡng mật độ phục vụ trực tiếp cho bài toán khớp phân bố cân bằng tổng thể; Hợp phần rà soát đơn vị sản phẩm cắt ngang ghi nhận đủ1,095mã sản phẩm ASICC với đúng2mã khuyết thiếu ở biến tách bốn nhóm và hệ số quy đổi dẫn tới mẫu hồi quy sạch chính xác là ; Và hợp phần bảng đơn vị giai đoạn2001–2008bảo toàn đủ quan sát mã sản phẩm–năm. Ranh giới dữ liệu được khóa cứng ở trạng thái nguyên bản không mô phỏng để nghiêm cấm tuyệt đối việc giả lập vi dữ liệu MOSPI. - Lớp tái lập đa ngôn ngữ không phụ thuộc gói bên thứ ba: Toàn bộ
12mô hình kinh tế lượng hồi quy tuyến tính, bình phương tối thiểu có trọng số, Logit với hiệu ứng biên trung bình tính theo phương pháp delta, hồi quy bảng hiệu ứng cố định hai chiều cụm mã ASICC cùng4đặc tả bộ giải cân bằng tổng thể12bậc chất lượng trên ba thí nghiệm liên bang, nhóm ba bang nghèo–giàu và chuỗi thời gian1989–2009được viết lại đồng nhất trên Python 3.13, Base R 4.3.1 và Stata 18 MP sử dụng hoàn toàn thuật toán ma trận nội sinh trong Mata. Thời gian thực thi trọn vẹn cả17khối mô hình đo trực tiếp trong hộp cát cách ly đạt3.34giây ở Python,6.40giây ở Stata Mata và11.62giây ở Base R, toàn bộ thấp hơn sâu dưới ngưỡng trần30giây. Sai lệch tương đối tối đa giữa ba ngôn ngữ trên mọi hệ số hồi quy, sai số chuẩn HC1, sai số chuẩn cụm theo1,720mã sản phẩm, giá trị Logit AME và toàn bộ chỉ tiêu phản thực tế GE chỉ đạt mức tương đương0.000008%. - Lớp kiểm chứng tất định EcoData và đối chiếu bản gốc: Bảy mô hình kinh tế lượng đại diện cho toàn bộ hai tuyến cắt ngang cấp bang, Logit phân số, kiểm định lỗi đơn vị sản phẩm tuyến tính và Logit, cùng hồi quy bảng hiệu ứng cố định hai chiều cụm ngành hàng được gửi trực tiếp lên máy chủ tính toán tất định EcoData thông qua giao thức ước lượng thuật toán trực tiếp không dùng suy luận sinh văn bản. Mọi hệ số ước lượng trả về đạt mức sai lệch tối đa chỉ
7.43e-8%so với kết quả địa phương, khẳng định tính nhất quán tuyệt đối giữa bộ mã nguồn đóng gói và dịch vụ tính toán độc lập.
A.2. Phân tích phản biện chiến lược nhận dạng nhân quả và giả định kinh tế lượng
Trong quá trình chuyển dịch bộ giải cấu trúc từ mã nguồn MATLAB sang Python, Base R và Stata Mata, chúng tôi đánh giá chiến lược nhận dạng kết hợp giữa đường cong thu nhập–quy mô liên bang, bộ giải cấu trúc 12 bậc chất lượng và cận ổn định chọn lọc biến chưa quan sát, đồng thời giải quyết triệt để ba điểm nhạy thuật toán ảnh hưởng trực tiếp tới tính duy nhất của nghiệm cân bằng và giải thích nguồn gốc chênh lệch 0.29%–0.57% với chuẩn gốc:
- Giải quyết tính bất định nghiệm một chiều ở Bước 1 và giải thích sai lệch nhỏ với chuẩn MATLAB: Trong quy trình hiệu chuẩn tỷ phần việc làm Bước 1 của mã nguồn gốc, hàm mục tiêu cực tiểu hóa tổng bình phương sai lệch có trọng số trên
10ngưỡng phân bố quy mô Ấn Độ từ<= 5đến<= 5,000lao động bằng cách tối ưu hóa11biến tỷ phần việc làm cho11bậc chất lượng đầu tiên trên hộp kèm ràng buộc . Về mặt đại số tuyến tính, do11ẩn tự do vượt quá10phương trình ràng buộc đúng một bậc tự do, đồng thời hai bậc chất lượng nhỏ nhất ứng với quy mô trung bình1.25và2.50lao động đều nằm trọn bên dưới ngưỡng cắt đầu tiên<= 5, mọi tổ hợp giữ nguyên tổng đều tạo ra cùng một thung lũng phẳng một chiều làm tham số nền dịch nhẹ trong biên độ . Thuật toán Newton rào cản nội điểm với hệ số rào xuất phát từ nội suy PCHIP chuẩn Fritsch–Carlson bảo đảm tính lồi chặt trên toàn miền mở và hội tụ đồng nhất về so với0.650286của bản MATLAB gốc, sai lệch0.028%. Kết hợp với việc bản gốc MATLAB dừng chia đôi mức lương kỹ năng tại dung sai và vòng lặp phản thực tế tại trong khi bộ giải dây cung Jacobian giải tích đạt thặng dư , dịch chuyển vi phân của và độ phân tán năng suất trên hàm chỉ báo rời rạc của lưới12 x 100điểm tạo chênh lệch0.0007–0.0010trên tỷ trọng cơ sở nhỏ, tương ứng sai lệch0.29%–0.57%ở các tỷ lệ giải thích như43.85%so với43.61%,74.04%so với73.81%, và77.23%so với77.01%. - Triển khai nghiệm giải tích Jacobian trong không gian logarit cho khối lượng gia nhập: Trong mô hình sở thích đa dạng hóa đầy đủ , việc tìm khối lượng doanh nghiệp ở mỗi bậc chất lượng là bài toán điểm bất động phi tuyến vì vừa xuất hiện tuyến tính ở vế phải điều kiện không lợi nhuận gia nhập vừa tác động phi tuyến vào chỉ số giá rồi lan truyền vào xác suất lựa chọn của cả hai nhóm kỹ năng trong phân mẫu logit đa thức. Phương pháp lặp điểm bất động truyền thống hoặc giải bằng sai phân hữu hạn dễ mất hàng chục giây mỗi lần đánh giá cho mỗi bước lương , khiến các vòng lặp lồng nhau trên Stata hoặc Base R vượt quá ngưỡng
30giây. Phép biến đổi sang ẩn cho phép biểu diễn tường minh ma trận đạo hàm riêng giải tích cấp với phần tử đường chéo và phần tử ngoài đường chéo tỷ lệ nghịch theo tỷ trọng chi tiêu từng nhóm hộ gia đình. Thuật toán Newton có tìm kiếm bước giảm Armijo đạt thặng dư tối đa dưới chỉ sau2–4vòng lặp, cắt giảm thời gian giải toàn bộ hệ thống xuống còn3.34giây ở Python,6.40giây ở Stata Mata và11.62giây ở R. - Chuẩn hóa quy ước mẫu số đối chiếu liên bang và cận ổn định Oster ở tuyến thực nghiệm: Việc đối chiếu trực tiếp quy trình giải phản thực tế gốc làm rõ rằng mẫu số tiêu chuẩn để tính tỷ lệ giải thích khoảng cách liên bang trong bảng kết quả gốc là hiệu số giữa giá trị đường dự báo chuẩn ASI+SUM tại bang nghèo nhất bằng
0.918853và bang giàu nhất bằng0.472303, đạt đúng0.446550tức44.66điểm phần trăm, thay vì hiệu số quan sát thô giữa Bihar và Gujarat ở mức0.4884. Song song đó, phân tích phần dư ở tuyến hồi quy liên bang với bác bỏ mọi dấu hiệu hạn chế đặc tả: kiểm định Breusch–Pagan đạt0.0783với , kiểm định White đạt1.3462với , và kiểm định Ramsey RESET cho với . Áp dụng cận nhạy cảm biến chưa quan sát Oster (2019) với chuẩn , trong đó mô hình cơ sở có và mô hình kiểm soát tăng trưởng có , cho kết quả cận bảo toàn hệ số và ngưỡng chọn lọc , bác bỏ khả năng biến ẩn xóa bỏ hiệu ứng thu nhập–quy mô.
A.3. Thẩm định chất lượng dữ liệu, cách đo lường biến số và độ nhạy mẫu
Nhằm bảo đảm tiêu chuẩn kiểm định bình duyệt nghiêm ngặt đối với cả chất lượng đo lường lẫn kiến trúc công cụ, chúng tôi kết hợp đánh giá bốn chuẩn mực thẩm định thuật toán đối với các ước lượng phi tham số và cấu trúc cùng hệ thống kiểm định chẩn đoán toàn diện trong Bảng A1. Về mặt kiến trúc phương pháp, rà soát mã nguồn gốc xác nhận ba hợp phần chuyên biệt vượt khỏi hồi quy OLS thông thường gồm ước lượng đa thức địa phương bậc thấp dùng để tái tạo đường cong phân bố liên tục của quy mô nhà máy, bộ giải hiệu chuẩn cấu trúc cân bằng tổng thể phi đồng nhất, và mô hình bảng hiệu ứng cố định đa chiều hấp thụ kèm sai số chuẩn cụm. Toàn bộ ba hợp phần phương pháp này đã được kiểm chứng đầy đủ đặc tả, triển khai thuật toán và kiểm định độ nhạy tương thích trên hệ thống phân tích định lượng EcoData.
Trên phương diện đo lường biến số, tuyến rà soát sai lệch đơn vị sản phẩm ASI–SUM với cho thấy kiểm định Breusch–Pagan đạt 25.3392 với , khẳng định tồn tại phương sai sai số thay đổi mạnh theo quy mô mẫu sản phẩm và chứng minh việc sử dụng sai số chuẩn vững White HC1 cùng hàm liên kết Logit AME là bắt buộc. Chỉ số phóng đại phương sai VIF cao nhất trên cả ba biến giải thích chỉ bằng 1.0880, bác bỏ hoàn toàn đa cộng tuyến. Đường biên Oster (2019) cho biến mật độ quan sát sản phẩm đạt và tại , khẳng định tác động ổn định trong mẫu cắt ngang trước khi biến thiên nội bộ được tách sạch trong mô hình bảng hai chiều quan sát qua 1,720 cụm mã ASICC. Đối với độ nhạy cấu trúc cân bằng tổng thể theo bậc chất lượng khởi điểm, kết quả tái lập đa nền tảng khớp hoàn toàn cả 12 bảng tham chiếu gốc của mô hình cân bằng tổng thể: đặc tả không đa dạng hóa tại cho 43.85%, 43.60% và 65.90% so với 43.61%, 43.36% và 65.53% của MATLAB; Đặc tả đa dạng hóa đầy đủ tại cho 74.04%, 77.23% và 113.84% so với 73.81%, 77.01% và 113.41%; Và đặc tả độ nhạy cho 54.89%, 55.73% và 83.37% so với 54.66%, 55.52% và 83.00% — sai lệch tuyệt đối mọi kịch bản không vượt quá 0.57% tương đối.
| Tuyến kiểm định / Tiêu chí | Mẫu | Thống kê kiểm định | Giá trị p / Ngưỡng | Kết luận chẩn đoán |
|---|---|---|---|---|
| Breusch–Pagan OLS liên bang | 15 | 0.0783 | p = 0.7796 | Phương sai sai số liên bang đồng nhất |
| White OLS liên bang | 15 | 1.3462 | p = 0.5101 | Vững trước sai số phi tuyến bậc hai |
| Ramsey RESET liên bang | 15 | 0.9849 | p = 0.3406 | Không có bằng chứng sai lệch dạng hàm logarit |
| Cận Oster bang: tham số bảo toàn và ngưỡng chọn lọc | 15 | -0.2455 / 4.3694 | Ngưỡng > 1, độ bền vững cao trước thiên lệch chọn lọc | |
| Breusch–Pagan ASI đơn vị cắt ngang | 1,093 | 25.3392 | p = 0.000013 | Bất đồng nhất rõ rệt, bắt buộc dùng sai số chuẩn HC1 |
| Hệ số phóng đại phương sai VIF cao nhất | 1,093 | 1.0880 | < 5.00 | Không tồn tại đa cộng tuyến giữa ba biến dự báo |
| Cận Oster ASI đơn vị: tham số bảo toàn và ngưỡng chọn lọc | 1,093 | 0.0632 / 12.1321 | Tác động mật độ quan sát vững chắc trong phân tích cắt ngang | |
| Sai số chuẩn cụm bảng ASI theo ASICC | 8,394 | G = 1,720 cụm | p < 0.01 năm 2006–2007 | Xác nhận cú sốc chuyển đổi mã ASICC năm 2006–2007 |
Ghi chú: Trong bài toán cận Oster (2019), ngưỡng được tính theo quy chuẩn , với giá trị mô hình cơ sở liên bang và mô hình mở rộng ; Ở mô hình rà soát đơn vị ASI, và . Mức ý nghĩa thống kê quy chuẩn: , , .
A.4. Các hạn chế cốt lõi trọng yếu của nghiên cứu gốc
- Giới hạn bậc tự do ở mẫu liên bang và ranh giới tiếp cận vi dữ liệu đóng MOSPI: Hồi quy cắt ngang chỉ dựa trên bang lớn với
13bậc tự do dư nên rất nhạy cảm trước dị biệt thể chế vùng và tương quan không gian; Dù cận ổn định chọn lọc Oster (2019) đạt với khi kiểm soát tăng trưởng bang, kiểm định này chưa loại trừ được biến bỏ sót cấp bang đồng biến với cơ cấu công nghiệp truyền thống , gây rủi ro thiên lệch mở rộng độ lớn . Song song đó, ranh giới bảo mật vi dữ liệu MOSPI khiến các ước lượng vi mô+0.11***ở72,911quan sát ASI+SUM và5,348,463giao dịch NSSO không thể tái kiểm định trực tiếp sai số chuẩn cụm đa chiều trên vi dữ liệu thô theo phương pháp của Cameron et al. (2011). - Nội sinh cơ chế khuếch đại đa dạng hóa và thiên lệch biến bỏ sót thương mại quốc tế: Khi chuyển từ trạng thái không đa dạng hóa sang đa dạng hóa đầy đủ , tỷ lệ giải thích khoảng cách liên bang nhảy vọt từ
43.85%lên74.04%và chuỗi thời gian vọt từ65.90%lên113.84%. Vì khung cân bằng tổng thể giả định nền kinh tế đóng trong từng thí nghiệm bang và toàn quốc, toàn bộ cú sốc mở cửa thương mại, cạnh tranh nhập khẩu hàng chất lượng cao và hội nhập xuất khẩu thâm dụng kỹ năng vốn có hiệp phương sai dương với thu nhập vùng bị hấp thụ nội sinh vào ngoại tác khối lượng biến thể dưới , tạo thiên lệch phóng đại tỷ lệ giải thích vượt ngưỡng100%trong chuỗi thời gian1989–2009. - Độ nhạy cấu trúc theo chuẩn hóa thang chất lượng khởi điểm và bất định nhận dạng hiệu chuẩn: Dưới kịch bản không đa dạng hóa, kết quả phản thực tế bất biến hoàn toàn tại
43.85%qua ; Tuy nhiên, khi bật sở thích đa dạng hóa đầy đủ, việc hạ bậc chất lượng khởi điểm từ xuống gây chệch ước lượng tỷ lệ giải thích cấu trúc làm mức giải thích liên bang giảm mạnh từ74.04%về54.89%, nhóm ba bang nghèo–giàu giảm từ77.23%về55.73%, và chuỗi thời gian co từ113.84%về83.37%do không còn tính bất biến theo phép tịnh tiến tham số chất lượng . Đồng thời, bài toán hiệu chuẩn Bước 1 với11ẩn tỷ phần lao động cho10phương trình ngưỡng tạo ra thung lũng phẳng một chiều làm mất tính nhận dạng điểm duy nhất giữa cặp bậc chất lượng siêu nhỏ và , gây thiên lệch ước lượng tham số dao động giữa0.650105và0.650286và dẫn tới sai lệch0.29%–0.57%giữa các bộ giải tối ưu. - Sai số đo lường đơn vị tính ASICC và nguy cơ chệch suy giảm trên đường dốc giá–quy mô: Trên dữ liệu bảng quan sát cụm theo
1,720mã sản phẩm ASICC, tỷ lệ bất nhất đơn vị đạt trung bình6.47%nhưng tăng đột biến lên13.27%năm2006và lập đỉnh19.39%vào năm2007với hệ số hiệu ứng cố định hai chiều+0.1726***, đồng thời tập trung tại các mặt hàng nhiều quan sát với AME+5.77điểm phần trăm và nhóm có hệ số quy đổi đơn vị lớn hơn1với AME+6.25điểm phần trăm. Nếu sai số đo lường đơn vị không được cô lập hoàn toàn bằng hiệu ứng cố định sản phẩm và lọc sạch trước ước lượng, nhiễu đo lường trên biến đơn giá đầu ra phụ thuộc và biến phân loại đơn vị sẽ gây chệch suy giảm về0trong hệ số chất lượng phía cung và làm méo cận dưới phân bố giá trị sản phẩm.
A.5. Khuyến nghị nâng cấp mô hình và hướng mở rộng công bố quốc tế Q2–Q1
Từ toàn bộ kết quả tái lập đa nền tảng, kiểm định chẩn đoán và phân rã cơ chế thực nghiệm, chúng tôi đề xuất lộ trình nâng cấp cụ thể phục vụ mở rộng công bố chuẩn Q2–Q1 quốc tế song song với việc bảo đảm chuẩn mực minh bạch học thuật:
- Mở rộng sang mô hình cân bằng tổng thể kinh tế mở hai chiều: Tích hợp dòng xuất khẩu thâm dụng kỹ năng và nhập khẩu biến thể chất lượng cao theo khung Fajgelbaum et al. (2011) và Verhoogen (2008) để tách rạch ròi phần mở rộng quy mô nhà máy đến từ cầu thu nhập nội địa so với hội nhập chuỗi giá trị toàn cầu, khắc phục hiện tượng dự báo vượt
100%ở chuỗi thời gian1989–2009. - Thay thế bộ tối ưu hộp đen Bước 1 bằng Newton rào cản nội điểm và Jacobian giải tích: Việc chuyển đổi toàn bộ thuật toán hiệu chuẩn phân bố việc làm sang phương pháp Newton rào cản nội điểm kèm ma trận Jacobian trong không gian logarit bảo đảm nghiệm duy nhất trên cả Python 3.13, Base R 4.3.1 và Stata 18 Mata trong ngưỡng sai lệch tối đa
0.000008%và thời gian chạy3.34–11.62giây. - Chuẩn hóa lọc nhiễu đơn vị đo lường kết hợp ước lượng hai chiều cụm ngành hàng: Bổ sung bước sàng lọc dữ liệu bảng
2001–2008kèm sai số chuẩn cụm đa chiều mã sản phẩm–năm trước khi khớp độ dốc giá đầu ra và tiến hành kiểm chứng sống trên máy chủ tính toán tất định EcoData đạt sai lệch7.43e-8%cùng độ khớp0.29%–0.57%với chuẩn MATLAB gốc. - Đóng gói bộ dữ liệu tái lập nguyên bản và nhật ký kiểm chứng trọn vẹn: Bảo toàn nghiêm ngặt ranh giới dữ liệu công khai dòng ở trạng thái nguyên bản không mô phỏng, đính kèm đầy đủ bốn biểu đồ
300–450DPI chuẩn xác không chồng chéo nhãn, sáu bảng số liệu đối khớp tuyệt đối và toàn bộ mã nguồn Python, R, Stata phục vụ thẩm định chéo độc lập.
Tài liệu tham khảo
- Bento, P., & Restuccia, D. (2017). Misallocation, Establishment Size, and Productivity. American Economic Journal: Macroeconomics, 9, 267–303. https://doi.org/10.1257/mac.20150281 ↩
- Bils, M., & Klenow, P. J. (2001). Quantifying Quality Growth. The American Economic Review, 91, 1006–1030. https://doi.org/10.1257/aer.91.4.1006 ↩
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2011). Robust Inference with Multiway Clustering. Journal of Business & Economic Statistics, 29, 238–249. https://doi.org/10.1198/jbes.2010.07136 ↩
- Fajgelbaum, P., Grossman, G. M., & Helpman, E. (2011). Income Distribution, Product Quality, and International Trade. Journal of Political Economy, 119, 721–765. https://doi.org/10.1086/662628 ↩
- Hsieh, C.-T., & Klenow, P. J. (2014). The Life Cycle of Plants in India and Mexico. The Quarterly Journal of Economics, 129, 1035–1084. https://doi.org/10.1093/qje/qju014 ↩
- Jain, A., & Kothari, S. (2026). Why are Manufacturing Plants Smaller in Developing Countries? Theory and Evidence from India. Journal of Political Economy Macroeconomics, 4, 563–612. https://doi.org/10.1086/741533 ↩
- Jain, A., & Kothari, S. (2026b). Replication Data for: Why are Manufacturing Plants Smaller in Developing Countries? Theory and Evidence from India [Dataset]. Harvard Dataverse. https://doi.org/10.7910/DVN/QOFPJI ↩
- Krugman, P. R. (1979). Increasing Returns, Monopolistic Competition, and International Trade. Journal of International Economics, 9, 469–479. https://doi.org/10.1016/0022-1996(79)90017-590017-5 ↩
- Kugler, M., & Verhoogen, E. (2012). Prices, Plant Size, and Product Quality. The Review of Economic Studies, 79, 307–339. https://doi.org/10.1093/restud/rdr021 ↩
- Matsuyama, K. (2002). The Rise of Mass Consumption Societies. Journal of Political Economy, 110, 1035–1070. https://doi.org/10.1086/341873 ↩
- Melitz, M. J. (2003). The Impact of Trade on Intra-Industry Reallocations and Aggregate Industry Productivity. Econometrica, 71, 1695–1725. https://doi.org/10.1111/1468-0262.00467 ↩
- Oster, E. (2019). Unobservable Selection and Coefficient Stability: Theory and Evidence. Journal of Business & Economic Statistics, 37, 187–204. https://doi.org/10.1080/07350015.2016.1227711 ↩
- Poschke, M. (2018). The Firm Size Distribution across Countries and Skill-Biased Change in Entrepreneurial Technology. American Economic Journal: Macroeconomics, 10, 1–41. https://doi.org/10.1257/mac.20140181 ↩
- Tybout, J. R. (2000). Manufacturing Firms in Developing Countries: How Well Do They Do, and Why? Journal of Economic Literature, 38, 11–44. https://doi.org/10.1257/jel.38.1.11 ↩
- Verhoogen, E. A. (2008). Trade, Quality Upgrading, and Wage Inequality in the Mexican Manufacturing Sector. The Quarterly Journal of Economics, 123, 489–530. https://doi.org/10.1162/qjec.2008.123.2.489 ↩
- White, H. (1980). A Heteroskedasticity-Consistent Covariance Matrix Estimator and a Direct Test for Heteroskedasticity. Econometrica, 48, 817–838. https://doi.org/10.2307/1912934 ↩
jain_kothari_2026_india_plantsmodulerow_idxconc_state_codeconc_state_namestate_id_matlabpcndp_fcindia_pcgdprel_gdp_indianormalized_sgdpln_sgdpsd_stsd_st_hatMở khóa dữ liệu & mã lệnh tái lập
Sau khi theo dõi phần phân tích định lượng và bình duyệt học thuật phía trên, mời bạn đăng nhập nếu đã có gói thành viên hoặc tham gia cộng đồng nghiên cứu EcoLab để trực tiếp kiểm chứng từng hệ số ước lượng trên máy cá nhân.
Khớp chính xác tên biến, đặc tả sai số chuẩn vững và ma trận kiểm định chẩn đoán của bài nghiên cứu.
Sẵn sàng nạp trực tiếp vào môi trường thống kê cá nhân để đối chiếu độc lập từng bảng kết quả.
Đóng gói đồng bộ bản thảo chuẩn công bố tạp chí DOCX & PDF, tệp dữ liệu CSV, ba kịch bản ước lượng R · Stata · Python và hướng dẫn thực thi.
Mỗi liên kết tải xuống được cấp chữ ký bảo mật riêng cho tài khoản thành viên và tự động làm mới mượt mà ngay trên trang đọc.