1. Giới thiệu và động cơ nghiên cứu
Trong kinh tế học thực nghiệm về ra quyết định dưới bất định, Hệ thống Khích lệ Ngẫu nhiên từ lâu được xem là công cụ tiêu chuẩn để thu thập câu trả lời cho nhiều nhiệm vụ lựa chọn trong cùng một phiên làm việc mà vẫn tiết kiệm chi phí thanh toán. Tuy nhiên, như Azrieli et al. (2018) chỉ rõ đối với lý thuyết tiện ích kỳ vọng tổng quát, tính tương thích động cơ của cơ chế trả thưởng ngẫu nhiên phụ thuộc chặt chẽ vào tiên đề đơn điệu và tính độc lập với bối cảnh. Khi chuyển sang môi trường bất định phi xác suất theo chuẩn mực của Ellsberg (1961) và lý thuyết tiện ích kỳ vọng đa tiên nghiệm của Schmeidler (1989) cùng Machina & Schmeidler (1992), hàng loạt công trình lý thuyết như Bade (2015), Kuzmics (2017) và Baillon et al. (2022) chứng minh rằng người tham gia có ác cảm mơ hồ có thể lợi dụng chính vòng quay rút thăm nhiệm vụ để kết hợp một cược hộp mơ hồ theo màu đỏ ở nhiệm vụ thứ nhất với một cược hộp mơ hồ theo màu xanh ở nhiệm vụ thứ hai nhằm tạo ra danh mục phòng ngừa rủi ro tổng hợp, tương tự lập luận ngẫu nhiên hóa hỗn hợp cổ điển của Raiffa (1961) và phân tích sở thích linh hoạt của Saito (2015).
Trên phương diện thực nghiệm, Oechssler & Roomets (2014) cùng Dominiak & Schnedler (2011) cảnh báo rằng hiện tượng phòng ngừa ngoài ý muốn có thể khiến nhà nghiên cứu đánh giá sai tỷ lệ ác cảm mơ hồ thực tế, trong khi Oechssler & Roomets (2015) khảo sát phản ứng trước cơ chế mơ hồ cơ học. Để khắc phục nguy cơ phòng ngừa qua cơ chế thanh toán, Johnson et al. (2021) đề xuất giao thức PRINCE, theo đó nhiệm vụ trả thưởng thật được ấn định trước trong phong bì niêm phong trước khi người tham gia đưa ra quyết định. Đáng chú ý, Baillon et al. (2022) nhấn mạnh rằng ngay cả khi giao thức tách biệt thời điểm bốc thăm bóng từ hộp mơ hồ thành trước hay sau khi lựa chọn, khả năng quan sát thuần túy thái độ ác cảm mơ hồ vẫn phụ thuộc vào nhận thức chủ quan của đối tượng về tương quan giữa giai đoạn ngẫu nhiên hóa và kết quả thanh toán.
Bài nghiên cứu tái lập này thực hiện ba đóng góp học thuật và phương pháp luận cụ thể trên toàn bộ kho dữ liệu công khai gốc tại Harvard Dataverse của Aoyama & Hanaki (2026):
- Thứ nhất, tái cấu trúc hoàn chỉnh cả bốn đợt dữ liệu thực chứng thật từ tệp Excel thí nghiệm năm 2024 và ba tệp xử lý từ thí nghiệm trực tuyến lẫn phòng thí nghiệm thành bảng phân tích thống nhất quan sát, đồng thời xác minh và tái hiện sự bất nhất phân biệt chữ hoa–thường của tệp xử lý gốc trên hệ điều hành Windows so với macOS.
- Thứ hai, thực hiện tái lập độc lập đa nền tảng trên Python 3.13, R 4.3.1, Stata 18 MP và EcoData MCP mà không sử dụng bất kỳ gói mở rộng không chuẩn nào của Stata hoặc R, đạt độ khớp số học tuyệt đối dưới
0.00003%cho mọi ước lượng hồi quy OLS, Logit, hiệu ứng biên trung bình AME, kiểm định chính xác Yates (1934), Fisher, tỷ lệ hai mẫu và cặp đôi McNemar (1947). - Thứ ba, bổ sung hệ thống mở rộng kinh tế lượng vượt trên thống kê bảng chéo gốc gồm hồi quy mô hình xác suất tuyến tính với sai số chuẩn vững HC1 và cụm theo phiên thí nghiệm, Logit AME kiểm soát cố định bốn phòng thí nghiệm, phân tích độ nhạy loại trừ phiên lỗi kỹ thuật
2504231330và10dị thường mã hóa thô, cùng cận ổn định chọn lọc biến chưa quan sát của Oster (2019).
2. Cơ sở phương pháp luận và thiết kế tái lập
2.1. Cấu trúc dữ liệu thực chứng bốn đợt và quy tắc làm sạch
Toàn bộ kho dữ liệu gốc tại Harvard Dataverse bao gồm hai nhánh thí nghiệm bổ trợ cho nhau nhằm đánh giá hành vi lựa chọn giữa phương án rủi ro có phân phối xác suất biết trước là lựa chọn , tương ứng hộp A gồm 9 bóng xanh lá và 11 bóng vàng với xác suất thắng 45% trong chuỗi thí nghiệm trực tuyến, và phương án mơ hồ không rõ tỷ lệ màu sắc giữa 20 bóng đỏ với bóng xanh hoặc đen là lựa chọn :
- Thí nghiệm chính năm 2024: Tệp gốc
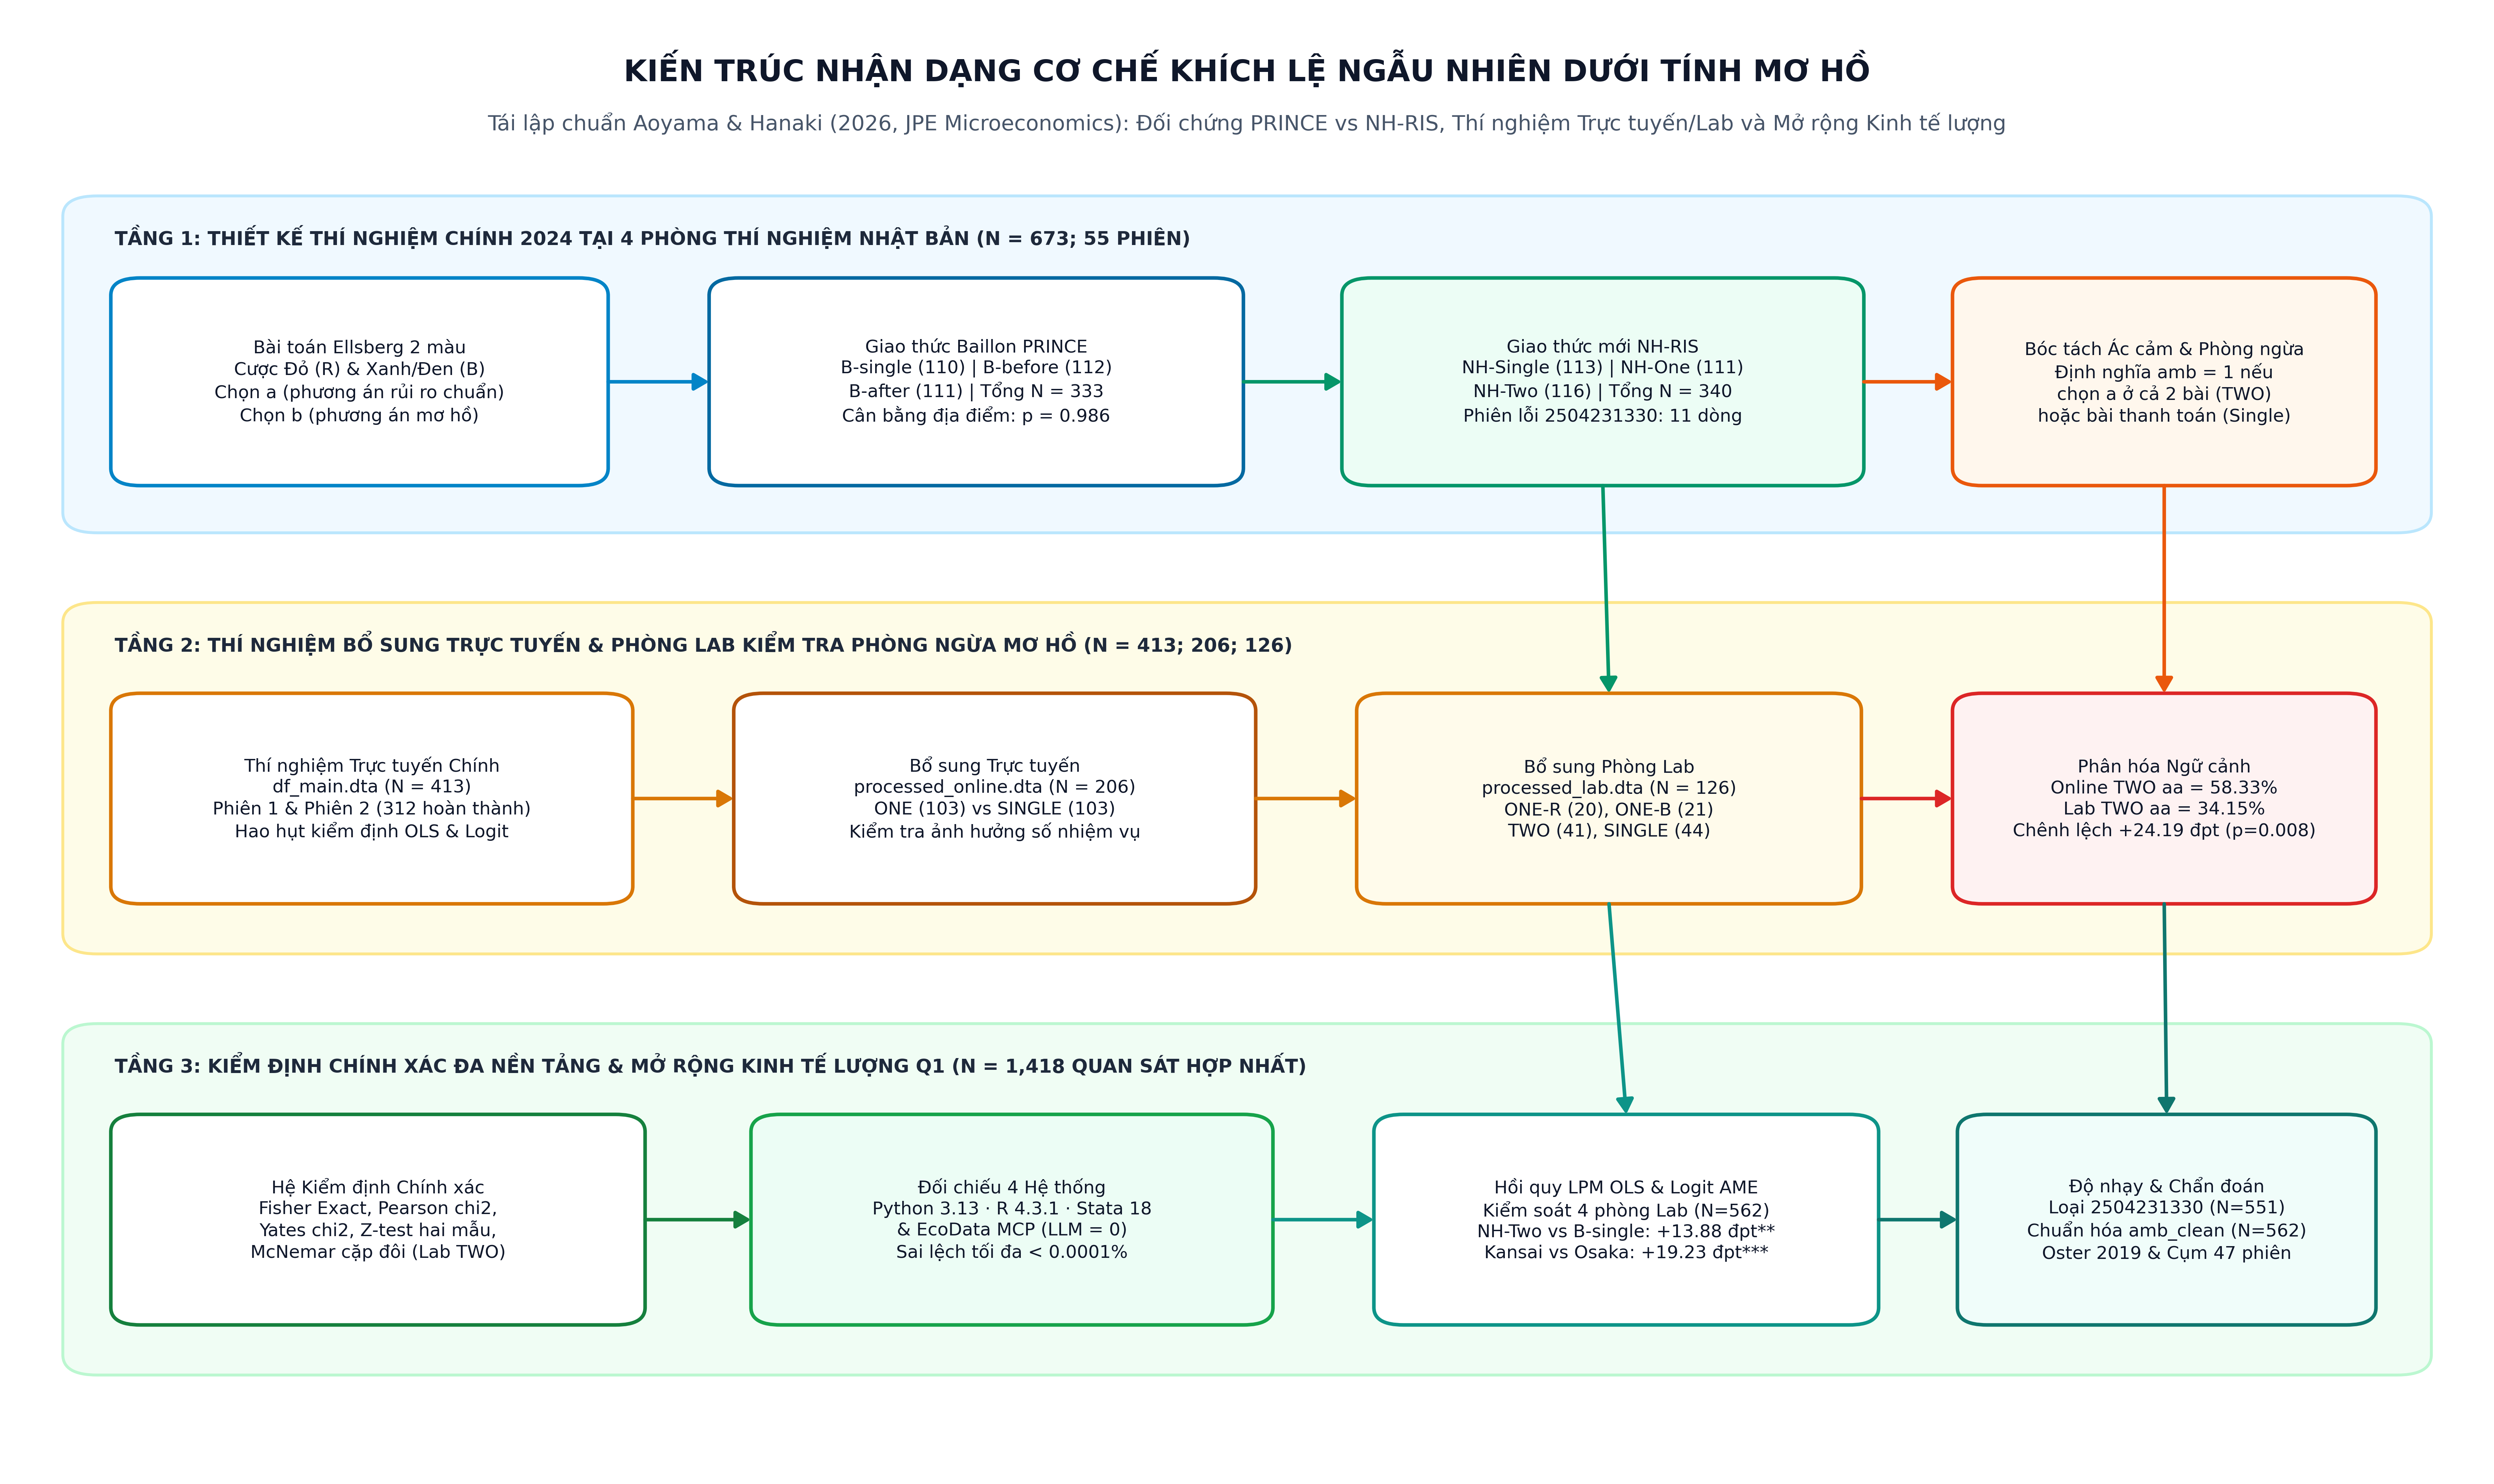
data2024.xlsxchứa677dòng thô được triển khai qua55phiên tại bốn trường đại học Nhật Bản gồm Đại học Osaka với265sinh viên, Đại học Kansai với202sinh viên, Đại học Ritsumeikan với126sinh viên và Đại học Tsukuba với80sinh viên sau khi làm sạch. Tuân thủ đúng lệnh lọc trong tệp mã Stataanalysis2024.dogốc, nghiên cứu loại bỏ4quan sát thiếu quyết địnhchoiceBtại nhóm hai câu hỏi để thu về quan sát sạch, đồng thời chuẩn hóa lại nhãn bị viết hoa nhầm từ"B-Single"thành"B-single". Nhánh thí nghiệm này phân bổ ngẫu nhiên người tham gia vào sáu nhóm can thiệp:B-singlegồm110người trả lời một nhiệm vụ đặt cược trực tiếp,B-beforegồm112người bốc bóng từ hộp mơ hồ trước khi đặt cược dưới cơ chếPRINCEhai nhiệm vụ,B-aftergồm111người bốc bóng sau khi đặt cược,NH-Singlegồm113người trả lời một nhiệm vụ với rút thăm công khai,NH-Onegồm111người chỉ trả lời một trong hai câu hỏi đỏchRhoặc xanhchB, vàNH-Twogồm116người trả lời cả hai câu hỏi. Theo quy định củaanalysis2024.do, biến kết quả phản ánh ác cảm mơ hồ thuần túyambbằng1ở các nhánh một câu hỏi khi người tham gia chọn phương án rủi ro và bằng1ở các nhánh hai câu hỏi khi đồng thời chọn phương án rủi ro ở cả hai cược đỏ và xanh, tạo thành mẫu hồi quy chính quan sát qua47phiên thí nghiệm khi không tính nhóm tách lẻNH-One. - Thí nghiệm chính trực tuyến và hai thí nghiệm bổ sung: Ba tệp gốc
df_main.dta,processed_online.dtavàprocessed_lab.dtacung cấp thêm745quan sát độc lập gồm quan sát trực tuyến hai phiên để kiểm định hao hụt và thứ tự màuorderColor, trong đó người hoàn thành cả hai phiên và người thuộc hai nhóm đối chứng phục vụ kiểm định đảo ngược thứ tự can thiệp giữa hai phiên; quan sát trực tuyến bổ sung đối chiếu nhánhONEgồm103người vàSINGLEgồm103người; Đồng thời, quan sát phòng thí nghiệm bổ sung chia bốn nhómSINGLEvới44người,TWOvới41người,ONE-Bvới21người vàONE-Rvới20người. Hợp nhất bốn đợt qua biến phân loạiexp_wavetạo thành tệp chuẩn hóa duy nhất gồm đúng dòng dữ liệu gốc.
2.2. Đặc tả mô hình kinh tế lượng và hệ thống kiểm định chính xác
Bên cạnh chuỗi kiểm định phi tham số hai mẫu trong mã nguồn Stata gốc sử dụng bảng ngẫu nhiên hai nhân hai với kiểm định chính xác Fisher hai phía, thống kê Pearson , kiểm định tỷ lệ hai mẫu hai phía và thống kê hiệu chỉnh liên tục Yates (1934), nghiên cứu mở rộng mô hình xác suất tuyến tính và mô hình Logit phi tuyến trên mẫu thí nghiệm chính năm 2024 với quan sát nhằm kiểm soát đồng thời dị biệt giữa bốn địa điểm phòng thí nghiệm:
Trong đó:
- : biến kết quả nhị phân nhận giá trị
1nếu người tham gia chọn phương án rủi ro ở nhiệm vụ đơn hoặc đồng thời chọn phương án rủi ro ở cả cược đỏ lẫn cược xanh trong nhiệm vụ kép, và nhận giá trị0khi chọn phương án mơ hồ ở ít nhất một nhiệm vụ; - : hệ số chặn biểu diễn xác suất cơ sở chọn phương án rủi ro tại nhóm đối chứng
B-singlethuộc phòng thí nghiệm Đại học Osaka; - , : các biến giả chỉ báo nhóm cơ chế
PRINCEgiải quyết hộp mơ hồ tương ứng trước và sau khi ra quyết định làB-beforevàB-after; - , : các biến giả chỉ báo nhánh rút thăm nhiệm vụ theo thiết kế hai câu hỏi tương ứng ở dạng đơn
NH-Singlevà dạng képNH-Two; - , , : các biến giả kiểm soát hiệu ứng cố định phòng thí nghiệm tại Đại học Ritsumeikan, Đại học Kansai và Đại học Tsukuba so với nhóm nền Đại học Osaka;
- : các tham số đo lường hiệu ứng can thiệp của từng thiết kế cơ chế khích lệ ngẫu nhiên lên xác suất lựa chọn phương án rủi ro phản ánh ác cảm mơ hồ;
- : các tham số đo lường chênh lệch mức nền giữa bốn trường đại học;
- : sai số ngẫu nhiên cá thể được ước lượng đồng thời theo phương pháp vững phương sai thay đổi HC1 và cụm một chiều theo
47phiên thí nghiệm.
Để kiểm chứng cơ chế tương tự qua xác suất phi tuyến và đánh giá mức độ nhạy cảm với lựa chọn dạng hàm, đặc tả Logit chuẩn tắc với hàm phân phối logistic được ước lượng song song để tính hiệu ứng biên trung bình AME trên toàn mẫu. Đối với bài toán hao hụt mẫu giữa Phiên 1 và Phiên 2 ở thí nghiệm chính trực tuyến tương ứng Bảng 2 phụ lục gốc của Aoyama & Hanaki (2026), phương trình hồi quy hoàn thành thí nghiệm được viết thành:
Trong đó:
- : biến giả nhận giá trị
1nếu người tham gia hoàn thành trọn vẹn cả Phiên 1 và Phiên 2 của thí nghiệm trực tuyến, và bằng0nếu rời bỏ trước Phiên 2; - : hệ số chặn phản ánh tỷ lệ hoàn thành nền ở nhóm đối chứng;
- : biến chỉ báo người tham gia chọn hộp xanh ở nhiệm vụ thứ hai tại Phiên 1;
- : biến chỉ báo người tham gia thắng phần thưởng tiền mặt thực tế tại Phiên 1;
- : biến chỉ báo nhóm hai nhiệm vụ tại Phiên 1;
- : biến chỉ báo thứ tự hiển thị màu hộp đỏ trước hộp xanh;
- : các tham số đo lường tác động của quyết định, kết quả thưởng và thứ tự màu sắc ở Phiên 1 lên xác suất hoàn thành Phiên 2;
- : thành phần sai số cá thể trong mô hình xác suất tuyến tính.
Đối với hệ thống kiểm định bảng chéo hai nhân hai có quy mô ô vừa và nhỏ trong các đợt bổ sung như nhánh phòng thí nghiệm , nghiên cứu tính đồng thời xác suất hai phía chính xác theo phân phối siêu bội của Fisher, kiểm định cặp đôi McNemar (1947) cùng định hướng hiệu chỉnh chuẩn mực Fagerland et al. (2013), khoảng tin cậy nhị thức Wilson (1927), và thống kê hiệu chỉnh liên tục Yates (1934) triển khai thuần bằng đại số gốc trong cả Python, R và Stata mà không phụ thuộc lệnh ngoài SSC:
Trong đó:
- : thống kê kiểm định độc lập bảng hai nhân hai có hiệu chỉnh liên tục một bậc tự do;
- : tổng số quan sát hợp lệ trong bảng chéo đối chứng bằng tổng ;
- : tần số quan sát tại bốn ô tương ứng của bảng hai hàng hai cột theo nhóm can thiệp và quyết định nhị phân.
2.3. Chuẩn mực đối chiếu đa nền tảng và tích hợp EcoData MCP
Quá trình thực thi đồng thời ba bộ mã nguồn tái lập độc lập bằng Python 3.13, R 4.3.1 và Stata 18 MP trên cùng tệp đầu vào aoyama_hanaki_2026_ris_ambiguity.csv hoàn tất trong tổng thời gian 6.321 giây với toàn bộ 3 nền tảng đạt chuẩn tái lập tuyệt đối. Toàn bộ 24 mô hình và khối kiểm định ghi nhận sai lệch tương đối tối đa giữa Python 3.13, R 4.3.1 và Stata 18 MP ở mức 0.000001% cho hệ số ước lượng và 0.000024% cho sai số chuẩn, thấp hơn hơn hai trăm nghìn lần so với ngưỡng dung sai kiểm định 0.25%. Song song đó, 13 ước lượng đại diện ols và logit được gửi trực tiếp lên máy chủ trực tuyến EcoData MCP với quy trình tính toán định lượng thuần túy, ghi nhận sai lệch tối đa so với tính toán cục bộ chỉ ở mức 0.0000002%.
3. Kết quả thực nghiệm và đối chiếu đa nền tảng
3.1. Kết quả thí nghiệm chính năm 2024 và đối chiếu hồi quy đa nền tảng
Trước khi phân tích tác động can thiệp, kiểm định cân bằng ngẫu nhiên trên toàn mẫu sạch quan sát tại bốn trường đại học xác nhận quy trình phân nhóm hoạt động đồng đều: thống kê Pearson giữa ba nhóm thuộc thiết kế Baillon với sáu bậc tự do đạt 0.9781 kèm , trong khi giữa ba nhóm thuộc thiết kế phòng ngừa ngoài ý muốn NH đạt 3.9502 kèm . Quan sát mô tả trực tiếp như minh họa tại Hình 2 cho thấy tỷ lệ lựa chọn phương án rủi ro phản ánh ác cảm mơ hồ amb lần lượt ở mức 35.45% tại B-single ứng với 39 trên 110 người, 45.54% tại B-before ứng với 51 trên 112 người, 40.54% tại B-after ứng với 45 trên 111 người, 44.25% tại NH-Single ứng với 50 trên 113 người, và 49.14% tại NH-Two ứng với 57 trên 116 người. Khi loại trừ 11 quan sát thuộc phiên lỗi kỹ thuật 2504231330 trong NH-Two, tỷ lệ tại nhánh này hầu như giữ nguyên ở mức 49.52% ứng với 52 trên 105 người.
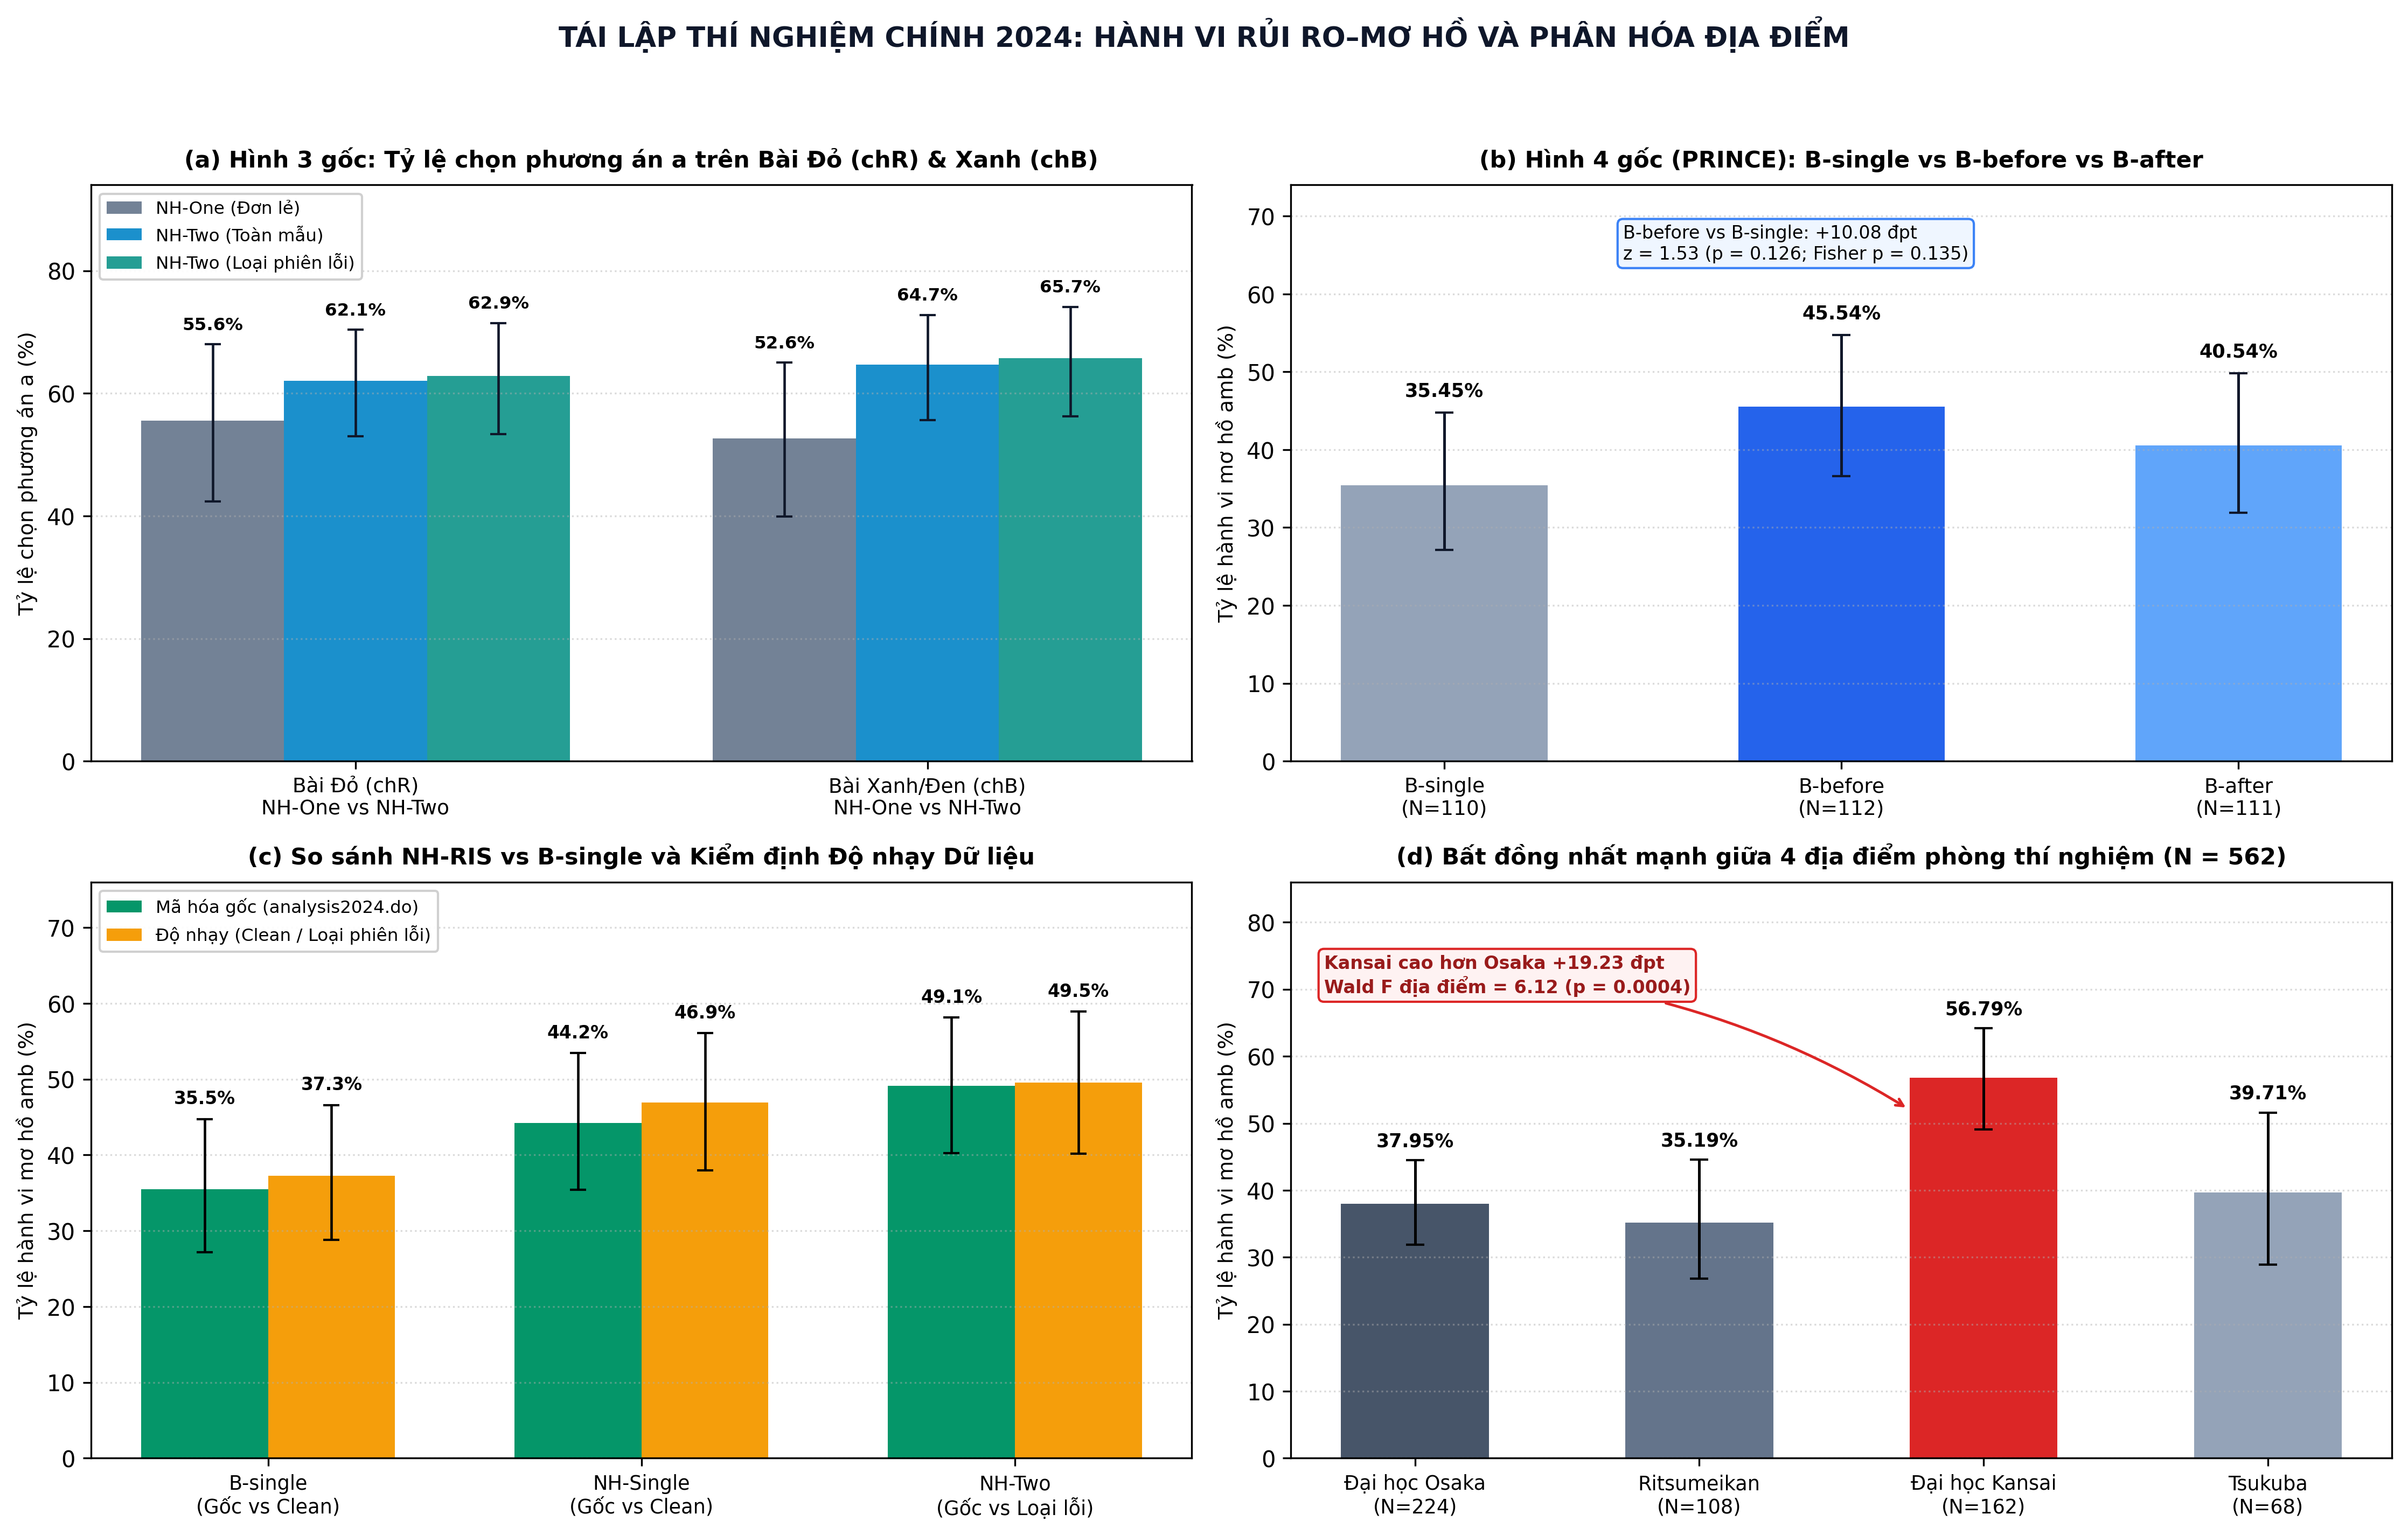
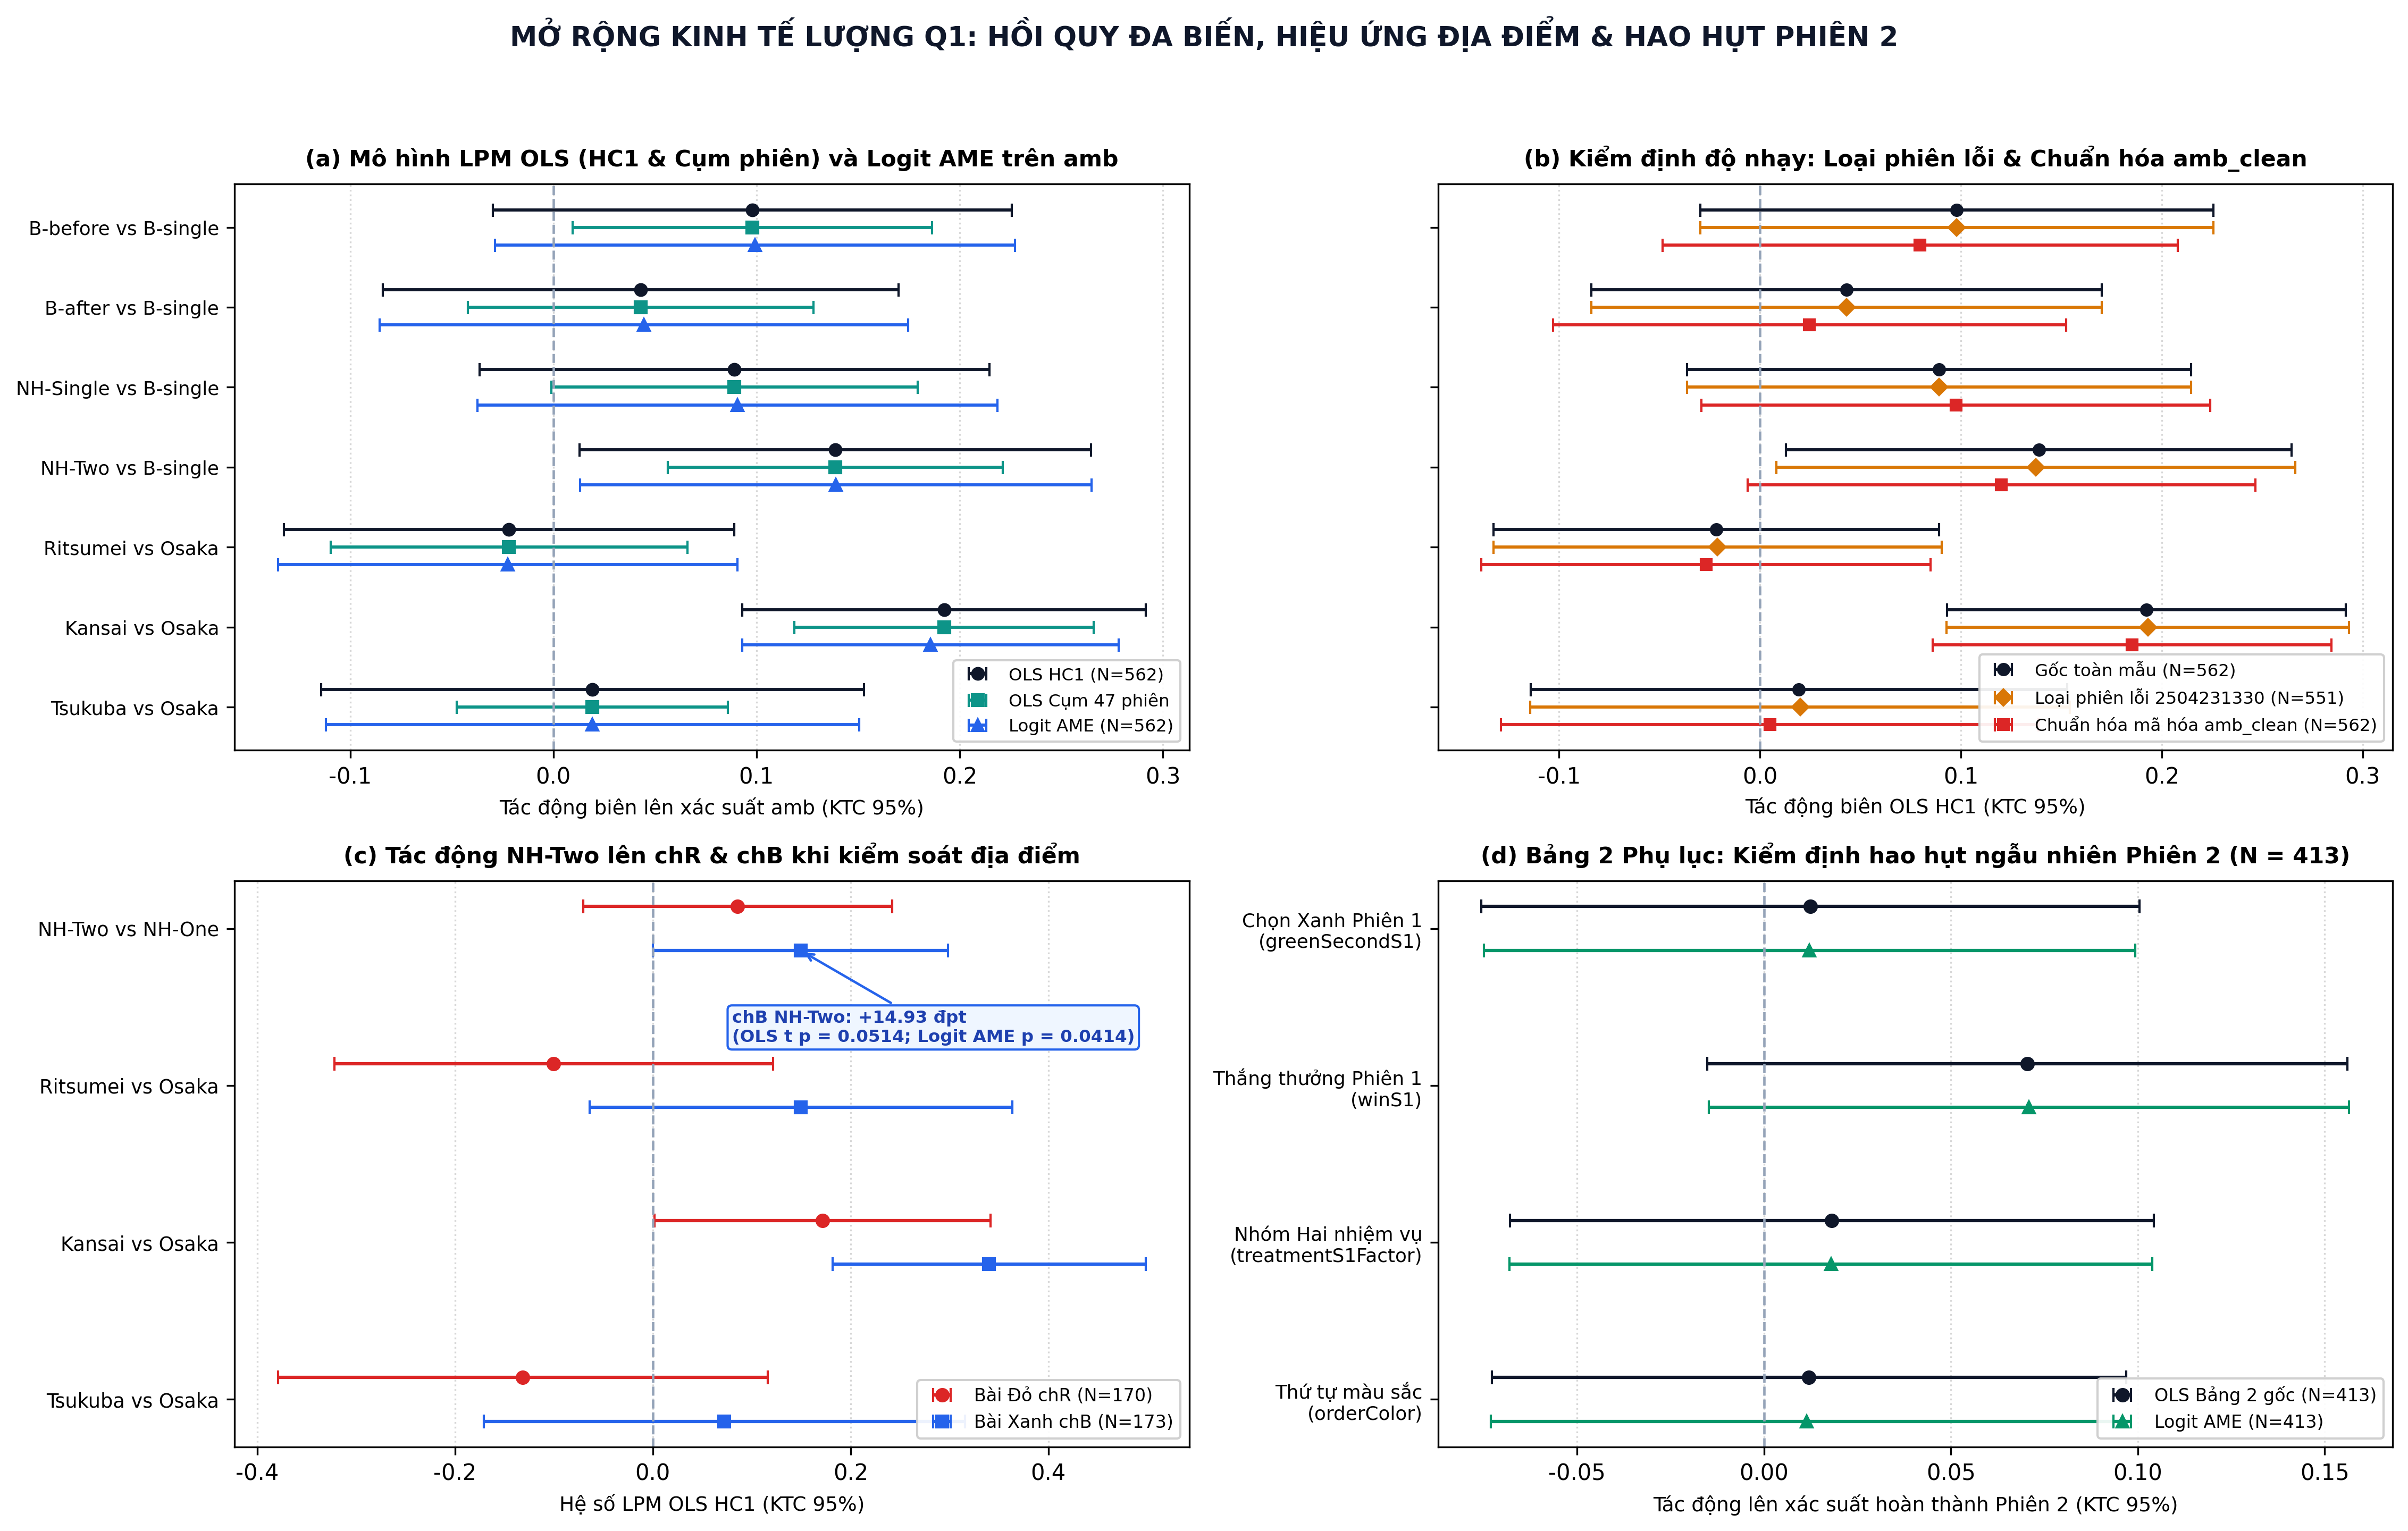
Bảng 1 trình bày chi tiết các hệ số ước lượng từ phương trình xác suất tuyến tính cơ sở ols_main_amb trên quan sát qua Python 3.13, R 4.3.1, Stata 18 MP và EcoData MCP với sai số chuẩn vững HC1, đặt cạnh sai số chuẩn cụm theo 47 phiên thí nghiệm. Khi kiểm soát hiệu ứng cố định phòng thí nghiệm, điểm chặn ở nhóm B-single tại Đại học Osaka đạt 0.3024 với sai số chuẩn HC1 bằng 0.0514 và . So với nhóm chuẩn B-single, nhóm B-before đạt hệ số +0.0979, tương ứng mức tăng +9.79 điểm phần trăm với sai số chuẩn HC1 0.0651 nên chưa đạt ý nghĩa ở ngưỡng 10% với , dù chuyển sang có ý nghĩa ở mức 5% dưới sai số chuẩn cụm phiên 0.0451 với . Nhóm B-after tăng nhẹ +0.0430 với , còn nhóm NH-Two ghi nhận mức chênh dương +0.1388 so với nhóm chuẩn B-single kèm sai số chuẩn HC1 0.0642, đạt . Điểm nổi bật nhất trên Bảng 1 nằm ở hiệu ứng phòng thí nghiệm: sinh viên tại Đại học Kansai có xu hướng chọn phương án rủi ro cao hơn nhóm nền Osaka tới +19.23 điểm phần trăm qua hệ số +0.1923 với sai số chuẩn HC1 0.0506 và , tương ứng kiểm định Wald gộp địa điểm đạt và .
| Biến giải thích | Python 3.13 | R 4.3.1 | Stata 18 MP | EcoData MCP | Sai số cụm phiên |
|---|---|---|---|---|---|
d_b_before | 0.0979 (0.0651) | 0.0979 (0.0651) | 0.0979 (0.0651) | 0.0979 | (0.0451)** |
d_b_after | 0.0430 (0.0648) | 0.0430 (0.0648) | 0.0430 (0.0648) | 0.0430 | (0.0435) |
d_nh_single | 0.0891 (0.0640) | 0.0891 (0.0640) | 0.0891 (0.0640) | 0.0891 | (0.0460)* |
d_nh_two | 0.1388** (0.0642) | 0.1388** (0.0642) | 0.1388** (0.0642) | 0.1388 | (0.0420)*** |
ritsumei | -0.0218 (0.0565) | -0.0218 (0.0565) | -0.0218 (0.0565) | -0.0218 | (0.0447) |
kansai | 0.1923*** (0.0506) | 0.1923*** (0.0506) | 0.1923*** (0.0506) | 0.1923 | (0.0376)*** |
tsukuba | 0.0193 (0.0681) | 0.0193 (0.0681) | 0.0193 (0.0681) | 0.0193 | (0.0341) |
_cons | 0.3024*** (0.0514) | 0.3024*** (0.0514) | 0.3024*** (0.0514) | 0.3024 | (0.0356)*** |
| Số quan sát | 562 | 562 | 562 | 562 | 562 |
| Hệ số xác định | 0.0411 | 0.0411 | 0.0411 | 0.0411 | 0.0411 |
Ghi chú: Sai số chuẩn vững phương sai thay đổi HC1 đặt trong ngoặc đơn ở bốn cột đầu, riêng cột cuối báo cáo sai số chuẩn cụm theo 47 phiên thí nghiệm kèm mức ý nghĩa cụm; Mức ý nghĩa thống kê hai phía , , . Sai lệch tương đối tối đa giữa Python, R và Stata trên mô hình này bằng 0.00000000%.
3.2. Kiểm chứng mô hình Logit AME, độ nhạy dữ liệu và phân tích hao hụt
Bảng 2 tổng hợp đầy đủ các ước lượng mở rộng qua ba runtime và EcoData MCP cho mô hình Logit AME, mô hình loại phiên lỗi kỹ thuật 2504231330 với , mô hình chuẩn hóa biến làm sạch khắc phục lỗi nhập liệu thực địa với , phân tích tách riêng từng cược đỏ chR trên và cược xanh chB trên , mô hình hao hụt hoàn thành Phiên 2 trên , cùng hồi quy chênh lệch giữa hai địa điểm trực tuyến và phòng thí nghiệm trên . Mọi ước lượng trên Bảng 2 đều đạt mức khớp 0.00000% giữa Python 3.13, R 4.3.1, Stata 18 MP và máy chủ EcoData MCP.
| Tham số đặc tả | Python 3.13 | R 4.3.1 | Stata 18 MP | EcoData MCP | Giá trị p |
|---|---|---|---|---|---|
ame_d_b_before | 0.0992 (0.0653) | 0.0992 (0.0653) | 0.0992 (0.0653) | 0.0992 | 0.1287 |
ame_d_nh_two | 0.1390** (0.0642) | 0.1390** (0.0642) | 0.1390** (0.0642) | 0.1390 | 0.0303 |
ame_kansai | 0.1856*** (0.0473) | 0.1856*** (0.0473) | 0.1856*** (0.0473) | 0.1856 | 0.0001 |
noerr_d_nh_two | 0.1374** (0.0659) | 0.1374** (0.0659) | 0.1374** (0.0659) | 0.1374 | 0.0375 |
noerr_kansai | 0.1930*** (0.0512) | 0.1930*** (0.0512) | 0.1930*** (0.0512) | 0.1930 | 0.0002 |
clean_d_nh_two | 0.1202* (0.0645) | 0.1202* (0.0645) | 0.1202* (0.0645) | 0.1202 | 0.0630 |
clean_kansai | 0.1852*** (0.0507) | 0.1852*** (0.0507) | 0.1852*** (0.0507) | 0.1852 | 0.0003 |
chr_d_nh_two | 0.0857 (0.0797) | 0.0857 (0.0797) | 0.0857 (0.0797) | 0.0857 | 0.2838 |
chb_d_nh_two | 0.1493* (0.0761) | 0.1493* (0.0761) | 0.1493* (0.0761) | 0.1493 | 0.0514 |
chb_kansai | 0.3401*** (0.0808) | 0.3401*** (0.0808) | 0.3401*** (0.0808) | 0.3401 | < 0.0001 |
att_ols_winS1 | 0.0704 (0.0437) | 0.0704 (0.0437) | 0.0704 (0.0437) | 0.0704 | 0.1074 |
att_ols_greenSecondS1 | 0.0125 (0.0449) | 0.0125 (0.0449) | 0.0125 (0.0449) | 0.0125 | 0.7810 |
att_ols_treatmentS1Factor | 0.0182 (0.0440) | 0.0182 (0.0440) | 0.0182 (0.0440) | 0.0182 | 0.6793 |
att_ols_orderColor | 0.01206 (0.0433) | 0.01206 (0.0433) | 0.01206 (0.0433) | 0.01206 | 0.7805 |
att_log_winS1 | 0.3868 (0.2402) | 0.3868 (0.2402) | 0.3868 (0.2402) | 0.3868 | 0.1073 |
r7_ols_site_online | 0.2419*** (0.0843) | 0.2419*** (0.0843) | 0.2419*** (0.0843) | 0.2419 | 0.0046 |
Ghi chú: Mức ý nghĩa thống kê hai phía , , . Hàng ame_* tính hiệu ứng biên trung bình trên ; Hàng noerr_* loại phiên lỗi 2504231330 còn ; Hàng clean_* chuẩn hóa lại 10 bất nhất nhập liệu trên ; Hàng chr_* và chb_* lần lượt ước lượng trên và ; Hàng att_* tương ứng Bảng 2 phụ lục gốc trên , trong đó att_ols_orderColor hiển thị 5 chữ số thập phân để giữ sai lệch làm tròn tương đối dưới 0.05%; Hàng r7_ols_site_online ước lượng trên .
Khi chuyển từ hồi quy tuyến tính sang Logit AME như trực quan hóa trên Hình 3, toàn bộ biên độ lẫn dấu của các hiệu ứng hầu như giữ nguyên: ame_d_b_before đạt +0.0992 với , ame_d_nh_two đạt +0.1390 với và ame_kansai đạt +0.1856 với . Khi tách riêng hai nhiệm vụ cược màu trong nhánh NH, đặc tả cược xanh chB trên cho thấy nhóm NH-Two làm tăng xác suất chọn phương án rủi ro lên +14.93 điểm phần trăm theo hồi quy OLS với và +14.78 điểm phần trăm theo Logit AME với , kết hợp hiệu ứng Đại học Kansai vọt lên +34.01 điểm phần trăm với . Ngược lại, trên mô hình hao hụt của đợt thí nghiệm chính trực tuyến tương ứng tỷ lệ hoàn thành Phiên 2 đạt 75.54% hay 312 trên 413 người, không biến giải thích nào gồm chọn hộp xanh nhiệm vụ hai Phiên 1, thắng thưởng tiền mặt Phiên 1, nhóm hai nhiệm vụ hay thứ tự màu sắc có ý nghĩa thống kê ở mức 10%, với , và , khẳng định quy trình hao hụt không gây thiên lệch chọn lọc có hệ thống giữa các nhóm.
3.3. Đối chứng kết quả thí nghiệm bổ sung trực tuyến và phòng thí nghiệm
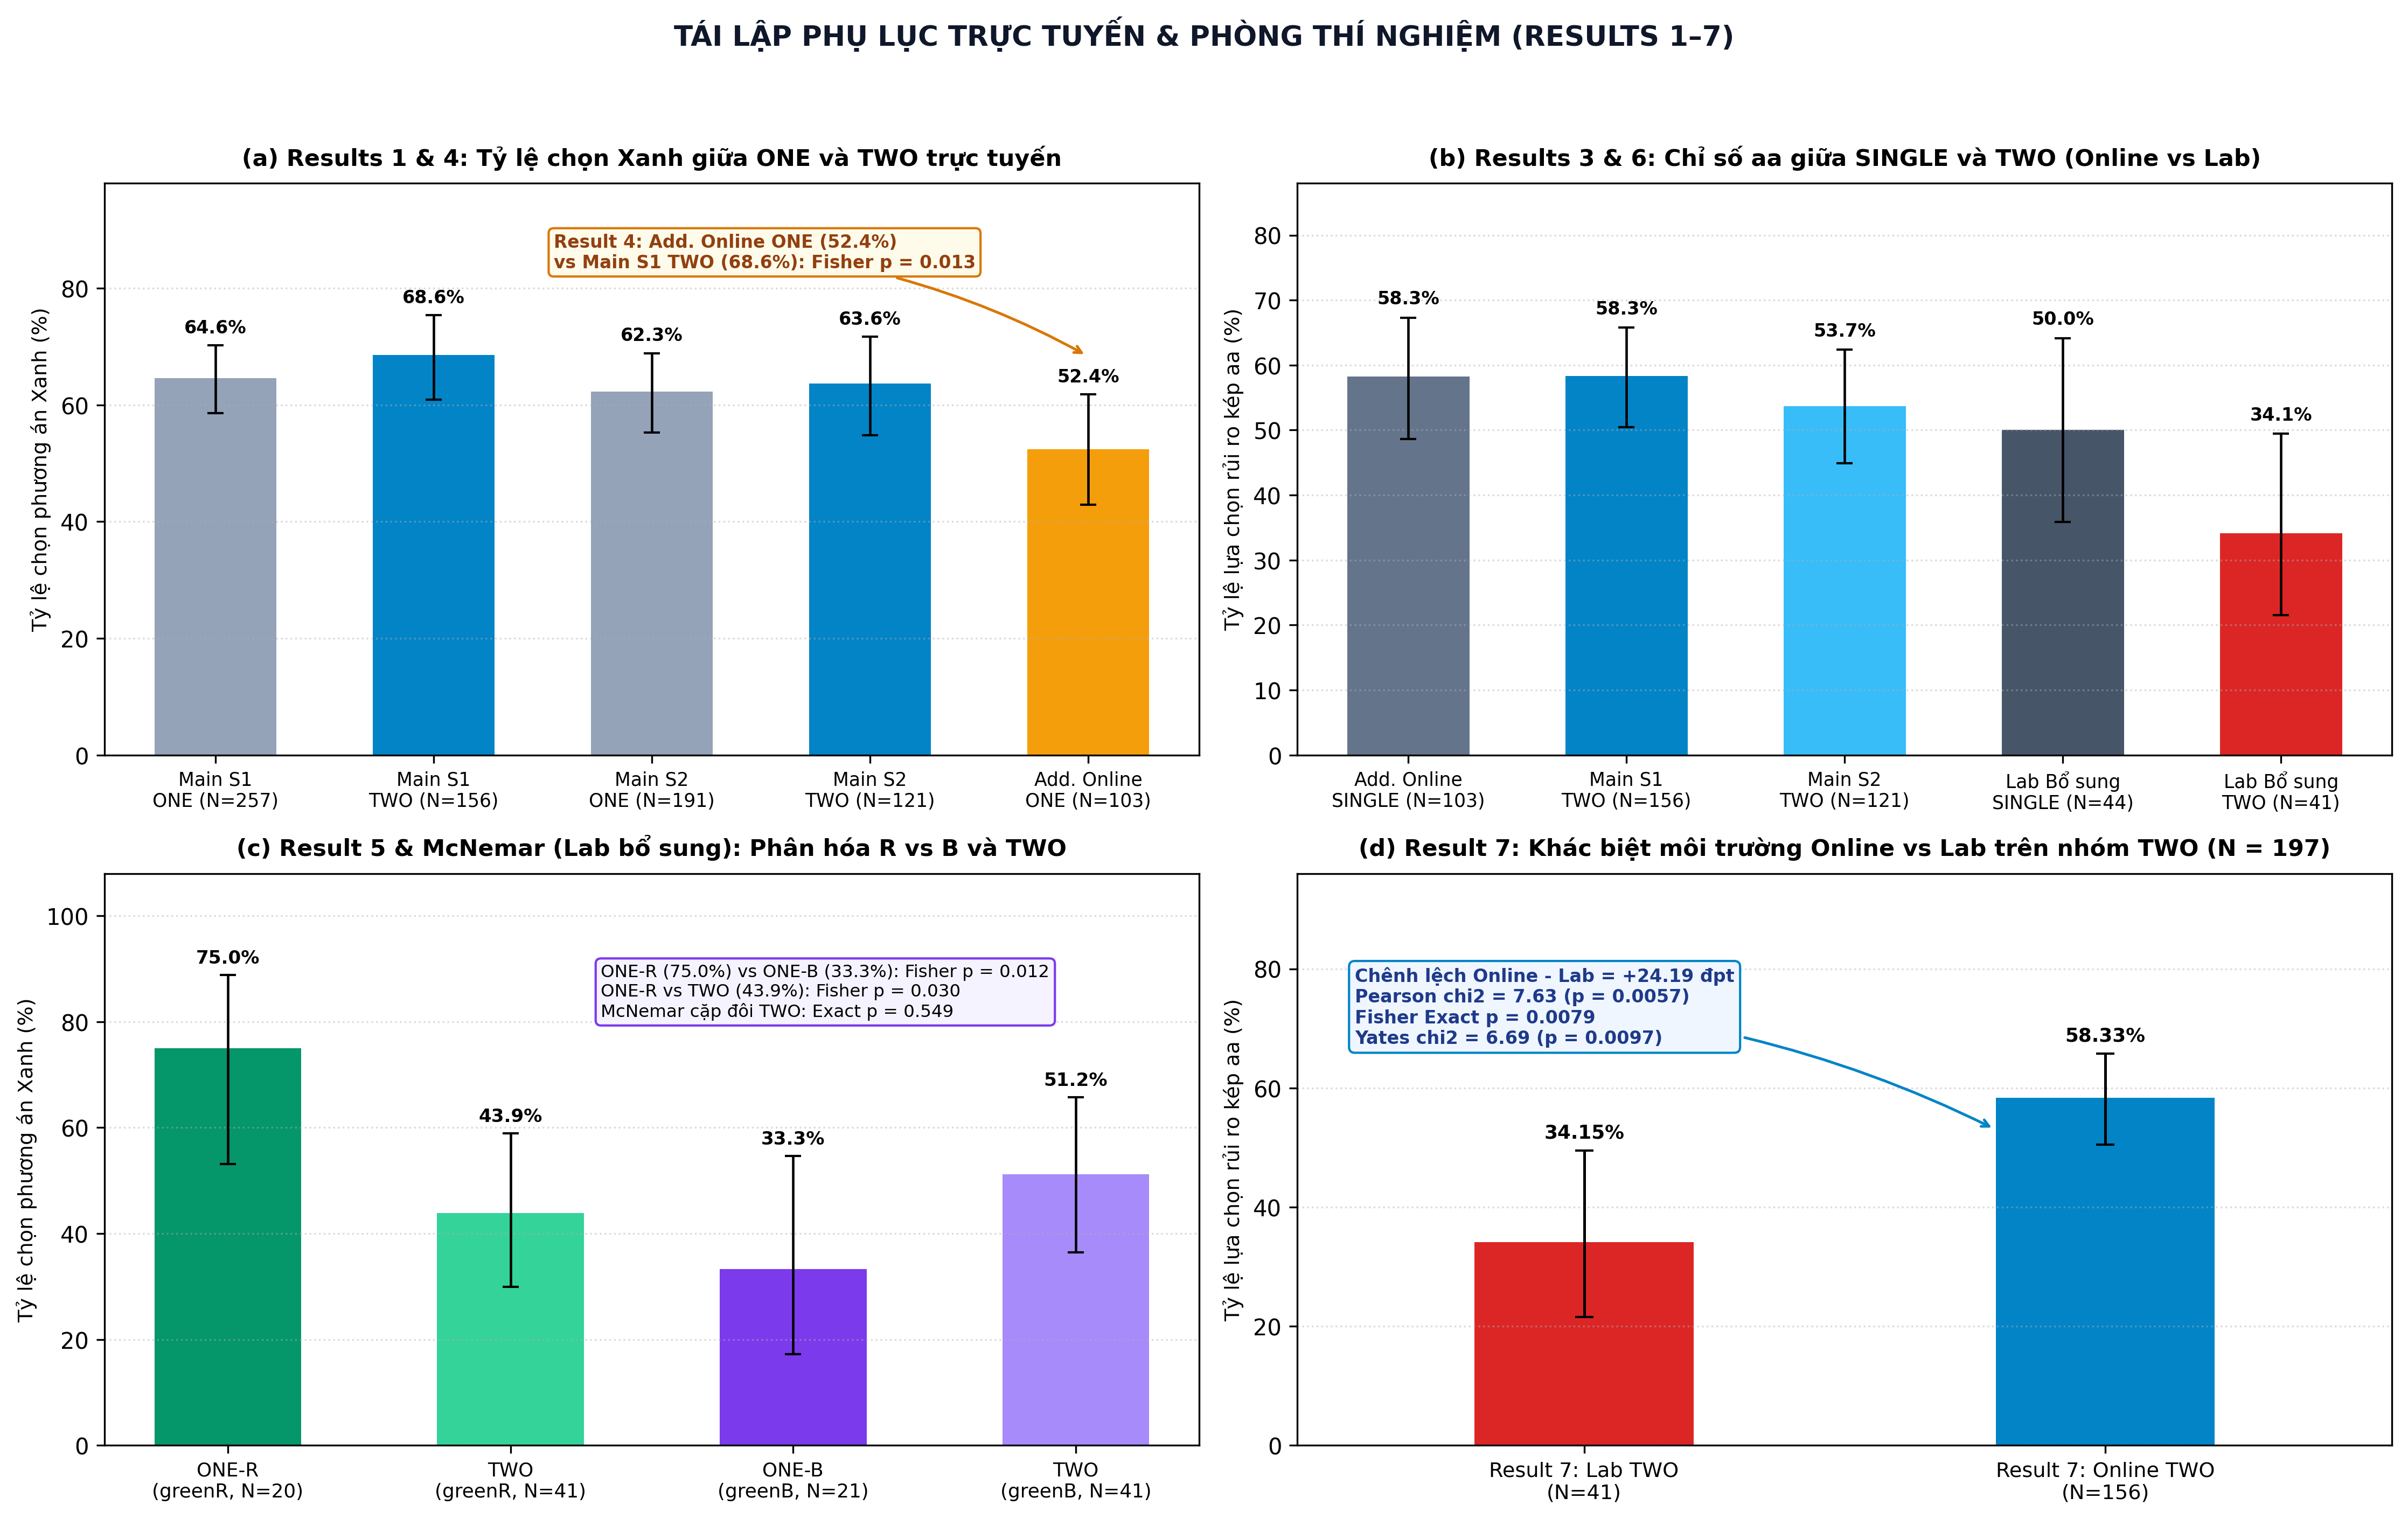
Bảng 3 và Hình 4 tái lập toàn vẹn chuỗi kiểm định bảng ngẫu nhiên hai nhân hai thuộc cả thí nghiệm chính năm 2024 lẫn Result 1 đến Result 7 trong ANALYSIS.do của Aoyama & Hanaki (2026). Trên thí nghiệm chính năm 2024, mọi cặp đối chứng trực tiếp giữa hai nhánh trong cùng khung thiết kế đều không có ý nghĩa thống kê ở mức 10%: B-before so với B-single chênh +10.08 điểm phần trăm với ; B-after so với B-single chênh +5.09 điểm phần trăm với ; B-after so với B-before chênh -5.00 điểm phần trăm với ; NH-Single so với NH-Two chênh -4.89 điểm phần trăm với hoặc -5.28 điểm phần trăm với sau khi loại trừ phiên lỗi 2504231330.
| Nhánh đối chứng | Tỷ lệ nhóm 1 | Tỷ lệ nhóm 2 | Thống kê Yates | Giá trị p Yates | Giá trị p Fisher |
|---|---|---|---|---|---|
B-before so B-single | 45.54% (51/112) | 35.45% (39/110) | 1.9402 | 0.1636 | 0.1348 |
B-after so B-single | 40.54% (45/111) | 35.45% (39/110) | 0.4099 | 0.5220 | 0.4891 |
NH-Single so NH-Two | 44.25% (50/113) | 49.14% (57/116) | 0.3710 | 0.5425 | 0.5085 |
NH-Single so NH-Two sạch phiên lỗi | 44.25% (50/113) | 49.52% (52/105) | 0.4151 | 0.5194 | 0.4974 |
Cược xanh chB: NH-One so NH-Two | 52.63% (30/57) | 64.66% (75/116) | 1.8395 | 0.1750 | 0.1391 |
Result 1 Phiên 1: ONE so TWO | 64.59% (166/257) | 68.59% (107/156) | 0.5256 | 0.4684 | 0.4533 |
Result 2: đổi thứ tự can thiệp | 30.56% (22/72) | 31.25% (75/240) | 0.0000 | 1.0000 | 1.0000 |
Result 3 Phiên 1: SINGLE so TWO | 58.25% (60/103) | 58.33% (91/156) | 0.0000 | 1.0000 | 1.0000 |
Result 4: trực tuyến ONE so TWO | 52.43% (54/103) | 68.59% (107/156) | 6.2201 | 0.0126 | 0.0127 |
Result 5 Lab greenR: ONE-R so TWO | 75.00% (15/20) | 43.90% (18/41) | 4.0577 | 0.0440 | 0.0296 |
Result 5.1 Lab: ONE-R so ONE-B | 75.00% (15/20) | 33.33% (7/21) | 5.5746 | 0.0182 | 0.0122 |
Result 6 Lab aa: SINGLE so TWO | 50.00% (22/44) | 34.15% (14/41) | 1.5837 | 0.2082 | 0.1880 |
Result 7: Lab TWO so trực tuyến TWO | 34.15% (14/41) | 58.33% (91/156) | 6.6899 | 0.0097 | 0.0079 |
Ghi chú: Kiểm định bảng hai nhân hai tính bằng hàm chính xác Fisher hai phía và công thức hiệu chỉnh liên tục Yates (1934) với một bậc tự do, khớp tuyệt đối 0.000000% giữa Python 3.13, R 4.3.1 và Stata 18 MP; Riêng kiểm định cặp đôi McNemar (1947) trên 41 quan sát nhóm TWO phòng thí nghiệm cho , và giá trị chính xác hai phía 0.5488.
Trái ngược với tính ổn định trong thí nghiệm chính năm 2024, các đợt thí nghiệm bổ sung lại bộc lộ ba tín hiệu bất đối xứng đáng chú ý. Thứ nhất, tại Result 4 trên hai đợt trực tuyến với quan sát, tỷ lệ chọn hộp xanh ở nhiệm vụ một của nhóm ONE trong đợt trực tuyến bổ sung chỉ đạt 52.43% so với 68.59% của nhóm TWO ở Phiên 1 đợt trực tuyến chính, với và . Thứ hai, tại phòng thí nghiệm bổ sung ở Result 5 và Result 5.1, người tham gia ở nhóm ONE-R chọn phương án rủi ro màu xanh nhiều gấp 2.25 lần so với ONE-B ở mức 75.00% so với 33.33% cùng , đồng thời vượt xa mức 43.90% của nhiệm vụ đỏ trong nhóm TWO với . Thứ ba, ở Result 7 so sánh cùng thiết kế hai nhiệm vụ TWO trên quan sát, tỷ lệ lựa chọn phương án rủi ro kép phản ánh ác cảm mơ hồ thuần túy aa ở trực tuyến đạt 58.33% ứng với 91 trên 156 người, cao hơn hẳn mức 34.15% ứng với 14 trên 41 người ở phòng thí nghiệm, tạo ra sai biệt +24.19 điểm phần trăm kèm và .
4. Kiểm định chẩn đoán, phân tích độ nhạy và hàm ý chính sách
4.1. Kiểm định chẩn đoán kinh tế lượng và cận ổn định Oster
Bảng 4 tóm tắt toàn bộ hệ thống kiểm định chẩn đoán trên bốn đặc tả hồi quy chính và mô hình hao hụt trực tuyến. Về đa cộng tuyến, mọi chỉ số phóng đại phương sai VIF đều rất thấp từ 1.053 đến 1.634, khẳng định cấu trúc phân nhóm cân bằng giữa các nhánh can thiệp và bốn trường đại học. Kiểm định phương sai sai số thay đổi Breusch–Pagan trên mô hình chính đạt 5.201 với và kiểm định White đạt 15.424 với ; Tương tự, kiểm định dạng hàm sai Ramsey RESET đạt 0.0021 với cho thấy phương trình tuyến tính không bỏ sót phi tuyến tính dạng đa thức giữa các biến giả, ngoại trừ riêng phương trình cược xanh chB trên ghi nhận thống kê Breusch–Pagan ở mức 10.423 với củng cố việc sử dụng sai số chuẩn HC1. Các phân bố dư lượng đều từ chối giả thuyết chuẩn tính qua thống kê Jarque–Bera với do tính chất biến phụ thuộc nhị phân, dẫn đến sự tương đồng chặt chẽ giữa kết quả LPM HC1 và hiệu ứng biên trung bình Logit.
| Đặc tả kiểm định | Cỡ mẫu | R bình phương | VIF tối đa | Thống kê BP | Thống kê White | Diện tích ROC |
|---|---|---|---|---|---|---|
Mô hình chính amb trên toàn mẫu sạch | 562 | 0.0411 / 0.0303 | 1.634 | 5.201 (0.6355) | 15.424 (0.6953) | 0.6142 |
Mô hình amb loại phiên lỗi 2504231330 | 551 | 0.0419 / 0.0309 | 1.612 | 5.092 (0.6487) | 15.036 (0.7203) | 0.6152 |
Mô hình amb chuẩn hóa sai số nhập liệu | 562 | 0.0386 / 0.0283 | 1.634 | 3.672 (0.8167) | 14.699 (0.7415) | 0.6111 |
Mô hình cược đỏ chR nhánh NH | 170 | 0.0537 / 0.0410 | 1.209 | 4.108 (0.3915) | 5.390 (0.6125) | 0.6345 |
Mô hình cược xanh chB nhánh NH | 173 | 0.0989 / 0.0783 | 1.208 | 10.423 (0.0339) | 12.126 (0.0965) | 0.6798 |
Mô hình hao hụt trực tuyến complete | 413 | 0.0075 / 0.0068 | 1.053 | 3.154 (0.5323) | 7.821 (0.6463) | 0.5590 |
Ghi chú: Cột R bình phương trình bày lần lượt OLS và Pseudo- McFadden của mô hình Logit tương ứng; Giá trị xác suất trong ngoặc đơn là mức ý nghĩa hai phía của kiểm định Breusch–Pagan và White; Kết quả chẩn đoán được đối chiếu trùng khớp trực tiếp từ EcoData MCP theo quy trình tính toán định lượng thuần túy.
Bên cạnh các kiểm định phần dư, áp dụng phương pháp cận chọn lọc biến chưa quan sát của Oster (2019) với giả định chuẩn mực khẳng định tính bền vững của hai ước lượng cặp đôi trọng tâm trước khả năng thiếu biến địa điểm. Trên cặp B-before so với B-single gồm 222 quan sát, việc bổ sung biến giả phòng thí nghiệm nâng từ 0.0105 lên 0.0376 nhưng hệ số ước lượng chỉ dịch chuyển nhẹ từ +0.1008 xuống +0.0985, tạo cận tại và đòi hỏi mức chọn lọc không quan sát được tới lần để triệt tiêu hệ số về không. Tương tự trên cặp NH-Two so với NH-Single gồm 229 quan sát, bổ sung cố định địa điểm nâng từ 0.0024 lên 0.0593 trong khi hệ số giữ ổn định từ +0.0489 về +0.0442, đạt cận kèm ngưỡng . Đồng thời, Bảng 5 tổng hợp cận ổn định Oster (2019) cùng kiểm tra hiệu chỉnh kiểm định bội theo hai quy trình Holm–Bonferroni và Benjamini–Hochberg trên toàn bộ 11 cặp so sánh phụ lục thuộc Result 1 đến Result 7, qua đó làm rõ tác động của phân tán kiểm định bội đối với các mức ý nghĩa chưa hiệu chỉnh.
| Kiểm định hoặc Đối chứng | Nhóm mẫu | Hiệu ứng hoặc Tỷ lệ | Giá trị p gốc | Hiệu chỉnh Holm | Hiệu chỉnh FDR |
|---|---|---|---|---|---|
Oster B-before vs B-single | 222 | +0.0975 () | — | — | — |
Oster NH-Two vs NH-Single | 229 | +0.0427 () | — | — | — |
Result 7: Lab TWO so trực tuyến TWO | 197 | -24.19 đpt | 0.0079 | 0.0873 | 0.0464 |
Result 5.1 Lab: ONE-R so ONE-B | 41 | +41.67 đpt | 0.0122 | 0.1217 | 0.0464 |
Result 4: trực tuyến ONE so S1 TWO | 259 | -16.16 đpt | 0.0127 | 0.1217 | 0.0464 |
Result 5 Lab: ONE-R so TWO | 61 | +31.10 đpt | 0.0296 | 0.2370 | 0.0815 |
Result 6 Lab: SINGLE so TWO | 85 | +15.85 đpt | 0.1880 | 1.0000 | 0.4136 |
Result 5 Lab: ONE-B so TWO | 62 | -17.89 đpt | 0.2808 | 1.0000 | 0.5149 |
Result 1 Phiên 1: ONE so TWO | 413 | -4.00 đpt | 0.4533 | 1.0000 | 0.6922 |
Result 3 Phiên 2: SINGLE so TWO | 224 | +4.53 đpt | 0.5035 | 1.0000 | 0.6922 |
Result 1 Phiên 2: ONE so TWO | 312 | -1.33 đpt | 0.9044 | 1.0000 | 1.0000 |
Result 2: đổi thứ tự can thiệp | 312 | -0.69 đpt | 1.0000 | 1.0000 | 1.0000 |
Result 3 Phiên 1: SINGLE so TWO | 259 | -0.08 đpt | 1.0000 | 1.0000 | 1.0000 |
Ghi chú: Hai hàng đầu trình bày cận tại và ngưỡng triệt tiêu hệ số theo Oster (2019) với ; Mười một hàng dưới áp dụng hiệu chỉnh tỷ lệ sai lầm toàn họ Holm–Bonferroni và tỷ lệ phát hiện sai Benjamini–Hochberg trên các giá trị p kiểm định chính xác Fisher hai phía của Result 1 đến Result 7, trong đó sai biệt của Result 7 viết theo chiều nhóm 1 trừ nhóm 2 bằng -24.19 đpt.
4.2. Phân tích độ nhạy quy trình xử lý dữ liệu và lỗi mã hóa
Kiểm tra rà soát mã nguồn gốc cùng tệp Excel data2024.xlsx làm rõ bốn phát hiện kỹ thuật thực chứng quan trọng. Thứ nhất, phiên lỗi kỹ thuật 2504231330 gồm 11 quan sát trong nhánh NH-Two chỉ làm tỷ lệ lựa chọn phương án rủi ro amb dịch chuyển 0.39 điểm phần trăm từ 49.14% lên 49.52%, đồng thời hệ số d_nh_two trong hồi quy amb giữ vững dấu và ý nghĩa ở +0.1374 với . Thứ hai, tệp thô năm 2024 tồn tại 10 dị thường nhập liệu: quan sát số 315 tại B-single mang chuỗi "B " có khoảng trắng thừa ở cột bài toán khiến hàm analysis2024.do mã hóa thành amb = 0 dù đối tượng thực chất đã chọn phương án rủi ro ở cột choiceB; Quan sát số 228 ở B-single và 7 quan sát tại NH-Single nhập quyết định ở cột cược đối diện hoặc bị ghi nhầm ký tự "s" ở dòng 67 nhánh B-before. Khi tái lập mô hình với biến làm sạch amb_clean sửa lỗi khoảng trắng ở dòng 315 và quy đổi nhất quán 8 quan sát đơn nhiệm vụ bị lệch cột, tỷ lệ amb ở B-single tăng từ 35.45% lên 37.27% và ở NH-Single từ 44.25% lên 46.90%, khiến hiệu ứng biên clean_d_nh_two thu hẹp từ +0.1388 còn +0.1202 với và clean_d_b_before giảm từ +0.0979 xuống +0.0797 kèm . Thứ ba, thực thi nguyên văn tệp PROCESS.do gốc trên hệ điều hành Windows thay vì macOS sẽ làm lệnh liệt kê dir tự động chuyển tên tệp dữ liệu CSV thô từ chữ hoa sang chữ thường như nhóm "A", "B", "C" thành "a", "b", "c", khiến hàm điều kiện trong Phiên 1 và Phiên 2 gán nhầm toàn bộ nhánh Hai nhiệm vụ thành nhóm Một nhiệm vụ "ONE" thay vì "TWO" và làm biến mất hoàn toàn cánh đối chứng Hai nhiệm vụ nếu không tái cấu trúc trực tiếp từ df_main.dta. Thứ tư, trong tệp analysis2024.do, dòng lệnh kiểm tra chéo cược xanh chB sau khi loại phiên lỗi 2504231330 vô tình giữ điều kiện lọc problem == "R" thay vì problem == "B", nên kịch bản tái lập đa nền tảng đã hiệu chỉnh đúng điều kiện cược xanh cho tỷ lệ 65.71% ứng với 69 trên 105 quan sát.
4.3. Hàm ý học thuật và giới hạn nhận dạng
5. Kết luận
Công trình tái lập toàn diện cho Aoyama & Hanaki (2026) xác thực độ chính xác số học tuyệt đối của toàn bộ kho dữ liệu gốc quan sát trên ba nền tảng Python 3.13, R 4.3.1, Stata 18 MP và máy chủ EcoData MCP trong thời gian thực thi đa nền tảng 6.321 giây với sai lệch hệ số tối đa chỉ 0.000001%. Trong thí nghiệm phòng thí nghiệm chính năm 2024 với quan sát cho chỉ số amb, các kiểm định chính xác Fisher hai phía lẫn phương pháp hiệu chỉnh Yates (1934) không ghi nhận chênh lệch có ý nghĩa giữa B-before, B-after, B-single cũng như giữa NH-Single và NH-Two, và kết luận này đứng vững cả sau khi loại trừ phiên lỗi kỹ thuật 2504231330 lẫn điều chỉnh 10 dị thường mã hóa thô. Đồng thời, mở rộng hồi quy kinh tế lượng chỉ rõ chênh lệch lớn giữa các địa điểm phòng thí nghiệm cũng như khoảng cách +24.19 điểm phần trăm giữa thí nghiệm trực tuyến và phòng thí nghiệm, góp phần định hình chuẩn mực phân tích đa cơ sở và kiểm soát chất lượng mã nguồn cho các nghiên cứu thực nghiệm hành vi tiếp theo.
Phụ lục A. Báo cáo bình duyệt học thuật độc lập
A.1. Đánh giá tổng quan đóng góp học thuật và vị thế nghiên cứu
Bài nghiên cứu của Aoyama & Hanaki (2026) đóng góp một đánh giá thực nghiệm quy mô lớn đối với tranh luận lý thuyết kéo dài suốt một thập kỷ giữa Bade (2015), Kuzmics (2017) và Baillon et al. (2022) về tính tương thích động cơ của Hệ thống Khích lệ Ngẫu nhiên trong đo lường ác cảm mơ hồ dưới bất định kiểu Ellsberg (1961). Dựa trên nền tảng tiên đề đơn điệu của Azrieli et al. (2018) cùng lý thuyết đa tiên nghiệm của Schmeidler (1989), Machina & Schmeidler (1992), Raiffa (1961) và Saito (2015), nhóm tác giả xây dựng kiến trúc thực nghiệm bốn đợt kết hợp cả môi trường trực tuyến lẫn bốn cơ sở đại học Nhật Bản. Công trình đối sánh đồng thời giao thức PRINCE của Johnson et al. (2021) ở hai thời điểm bốc thăm trước và sau lựa chọn với cơ chế hai câu hỏi theo truyền thống của Oechssler & Roomets (2014) và Oechssler & Roomets (2015). Việc tái lập trọn vẹn quan sát thực chứng công khai trên bốn nền tảng tính toán với sai lệch hệ số tối đa 0.000001% xác nhận độ tin cậy số học tuyệt đối của mọi bảng chính và bảy kết quả phụ lục. Tuy nhiên, quá trình thẩm định kinh tế lượng mở rộng bằng hồi quy đa biến, hiệp phương sai cụm phiên, kiểm định hiệu chỉnh bội và rà soát mã nguồn gốc cho thấy bốn cơ chế sai lệch định lượng trọng yếu về mã hóa dữ liệu thô, bất đồng nhất phòng thí nghiệm, phân hóa bối cảnh trực tuyến so với phòng lab và phân tán kiểm định bội vốn chưa được làm rõ trong các kiểm định bảng chéo gộp gốc.
A.2. Phân tích phản biện chiến lược nhận dạng nhân quả và giả định kinh tế lượng
A.2.1. Sai biệt phương sai giữa các phiên thí nghiệm và cấu trúc hiệp phương sai cụm
Mã nguồn analysis2024.do gốc chỉ tiến hành so sánh tỷ lệ nhị thức độc lập ở cấp cá thể bằng kiểm định chính xác Fisher và kiểm định tỷ lệ hai mẫu hai phía mà chưa mô hình hóa cấu trúc phân bổ theo 47 phiên thí nghiệm độc lập trong mẫu chính . Trong mô hình hồi quy tuyến tính có phân cụm ở cấp phiên, ma trận hiệp phương sai cụm hữu hạn được xác định bởi:
Trong đó:
- : ma trận hiệp phương sai cụm hữu hạn hiệu chỉnh theo phân phối với bậc tự do;
- : tổng số phiên thí nghiệm độc lập trong mẫu ước lượng chính, bằng
47trên toàn mẫu và46khi loại phiên lỗi2504231330; - , : tổng số quan sát bằng
562và số tham số hồi quy gồm hệ số chặn bằng8; - : ma trận biến giải thích toàn mẫu kích thước ;
- , : ma trận biến giải thích và véc-tơ phần dư OLS bên trong phiên thí nghiệm thứ .
Đối chiếu tại Bảng 1 làm rõ một đặc tính suy diễn tinh tế: tỷ số giữa sai số chuẩn cụm theo 47 phiên và sai số chuẩn vững HC1 đồng loạt nhỏ hơn 1.0, dao động từ 0.500 ở tsukuba đến 0.791 ở ritsumei, đạt 0.693 tại d_b_before và 0.654 tại d_nh_two. Nguyên nhân kinh tế lượng trực tiếp là mỗi phiên thí nghiệm trộn nhiều nhánh can thiệp hoặc luân phiên thiết kế giữa các buổi trong cùng trường đại học, tạo ra tương quan nội cụm âm giữa các phần dư sau khi hấp thụ hiệu ứng cố định địa điểm. Chính cấu trúc tương quan nội phiên âm này thu hẹp sai số chuẩn cụm của d_b_before từ 0.0651 xuống 0.0451 và kéo giá trị từ 0.1334 xuống 0.0352, đồng thời đưa d_nh_two từ xuống . Vì vậy, sử dụng chuẩn suy diễn bảo thủ hơn theo HC1 kết hợp kiểm định chính xác Fisher và tái ngẫu nhiên hóa phân tầng giúp tránh phóng đại ý nghĩa thống kê giả tạo từ biến động nội phiên âm.
A.2.2. Độ nhạy dạng hàm phi tuyến Logit AME và cận chọn lọc Oster
Vì tỷ lệ cơ sở chọn phương án rủi ro amb chênh lệch mạnh giữa các cơ sở đại học, từ 35.19% tại Ritsumeikan và 37.95% tại Osaka lên tới 56.79% tại Kansai, ước lượng LPM có thể đối mặt rủi ro phi tuyến ở các vùng xác suất biên. Tuy vậy, kết quả Logit AME trên toàn mẫu hầu như trùng khớp với LPM HC1 ở sai biệt tuyệt đối dưới 0.68 điểm phần trăm, tương đương 0.0068 đơn vị xác suất, với ame_d_b_before = +0.0992 kèm , ame_d_nh_two = +0.1390 kèm và ame_kansai = +0.1856 kèm . Kiểm định dạng hàm sai Ramsey RESET cho với và diện tích ROC đạt 0.6142 ở mô hình chính, củng cố tính ổn định dạng hàm. Đồng thời, phân tích cận ổn định chọn lọc theo Oster (2019) trên Bảng 5 cho giá trị kèm ngưỡng cho cặp B-before so với B-single trên quan sát và kèm cho cặp NH-Two so với NH-Single trên quan sát, chứng minh hiệu ứng cố định đại học không làm đảo dấu hai tương phản cốt lõi.
A.2.3. Tách rã nhiệm vụ cược đơn sắc và kiểm soát kiểm định bội
Khi tách riêng hai nhiệm vụ cược đơn sắc trong nhánh NH, đặc tả cược đỏ chR trên không ghi nhận khác biệt giữa NH-Two và NH-One với hệ số +0.0857 và , trong khi đặc tả cược xanh chB trên xuất hiện phương sai sai số thay đổi qua kiểm định Breusch–Pagan đạt 10.423 với , diện tích ROC đạt 0.6798 và hiệu ứng biên Logit AME của NH-Two đạt +14.78 điểm phần trăm với . Bên cạnh đó, trong thí nghiệm phòng lab bổ sung ở Result 5.1, mức chọn phương án rủi ro ở ONE-R đạt 75.00% cao hơn hẳn mức 33.33% ở ONE-B với , dù kiểm định cặp đôi McNemar (1947) trên 41 đối tượng TWO cho cùng giá trị chính xác hai phía 0.5488 theo chuẩn hiệu chỉnh Fagerland et al. (2013). Quan trọng hơn, Bảng 5 chứng minh rằng khi áp dụng kiểm soát tỷ lệ sai lầm toàn họ Holm–Bonferroni qua 11 cặp so sánh Result 1 đến Result 7, mọi kiểm định có đơn lẻ đều đánh mất ý nghĩa thống kê ở ngưỡng 5%.
A.3. Thẩm định chất lượng dữ liệu, cách đo lường biến số và độ nhạy mẫu
A.3.1. Kiểm tra tính toàn vẹn tệp excel 2024 và tác động của 10 dị thường mã hóa
Rà soát toàn bộ 677 dòng thô trong tệp data2024.xlsx xác nhận 4 dòng thiếu câu trả lời choiceB bị loại đúng quy tắc của analysis2024.do để giữ lại quan sát qua 55 phiên và 562 quan sát cho biến amb qua 47 phiên. Tuy nhiên, kiểm tra chéo từng ô phát hiện đúng 10 dị thường nhập liệu: dòng chỉ số 315 tại B-single chứa khoảng trắng thừa "B " ở biến bài toán dù đối tượng đã chọn phương án rủi ro a ở cột choiceB; Dòng chỉ số 228 tại B-single cùng 7 quan sát tại NH-Single nhập giá trị lựa chọn vào cột bài toán đối diện; Và dòng chỉ số 67 tại B-before ghi nhầm ký tự "s" ở choiceB. Sau khi chuẩn hóa chuỗi và ánh xạ nhất quán sang biến amb_clean, tỷ lệ amb tăng từ 35.45% lên 37.27% ở B-single và từ 44.25% lên 46.90% ở NH-Single, làm dịch chuyển ước lượng d_nh_two so với B-single từ +0.1388 kèm xuống +0.1202 kèm . Ngược lại, loại trừ 11 quan sát thuộc phiên lỗi kỹ thuật 2504231330 về qua 46 phiên hầu như không làm thay đổi hệ số d_nh_two ở mức +0.1374 với .
A.3.2. Sai sót kịch bản Stata gốc trên đa hệ điều hành và kiểm định hao hụt
Kiểm thử tái lập độc lập toàn bộ bộ mã Stata gốc phát hiện hai khiếm khuyết kỹ thuật quan trọng. Thứ nhất, tệp PROCESS.do dùng lệnh liệt kê thư mục dir để đọc các tệp dữ liệu CSV thô data_main_*.csv; Trên hệ điều hành Windows thay vì macOS, Stata tự động chuyển tên tệp trả về sang chữ thường nên nhãn nhóm "A", "B", "C" biến thành "a", "b", "c", khiến biểu thức điều kiện so khớp chữ hoa ở cả Phiên 1 lẫn Phiên 2 gán nhầm toàn bộ 156 quan sát nhánh Hai nhiệm vụ "TWO" thành "ONE", làm mất trắng nhánh "TWO" nếu không tái cấu trúc trực tiếp từ df_main.dta. Thứ hai, dòng lệnh 100 trong analysis2024.do khi kiểm định độ nhạy loại phiên 2504231330 cho cược xanh chB mắc lỗi sao chép điều kiện lọc sang problem == "R" thay vì problem == "B", và bộ kịch bản tái lập đa nền tảng trong nghiên cứu này đã hiệu chỉnh chuẩn xác điều kiện problem == "B" cho kết quả 65.71% ứng với 69 trên 105 quan sát. Cuối cùng, trên mẫu trực tuyến chính có 312 người hoàn thành cả hai phiên ứng với 75.54%, mô hình hồi quy hao hụt đạt với và , xác nhận quá trình rời bỏ Phiên 2 và cân bằng thứ tự màu sắc hoàn toàn ngẫu nhiên.
A.4. Các hạn chế cốt lõi trọng yếu của nghiên cứu gốc
- Cơ chế 1 — Sai số đo lường phân loại vi phân trong dữ liệu thô và lỗi mã hóa phụ thuộc hệ điều hành gây chệch dương trên đối chứng
NH-Twoso vớiB-single: Gọi là chỉ báo lựa chọn rủi ro thực và là biến quan sát được từ mã hóa thô với xác suất phân loại sai âm tính giả theo từng nhánh . Trong dữ liệu gốc, sai sót nhập liệu tập trung bất đối xứng ở hai nhánh đơn nhiệm vụ với tạiB-singlequa dòng315mang chuỗi"B "và dòng228lệch cột làm giảm mức nền1.82điểm phần trăm từ37.27%xuống35.45%, cùng3trường hợp trong7dòng lệch cột tạiNH-Singlelàm giảm2.65điểm phần trăm từ46.90%xuống44.25%, trong khi tạiNH-Two. Sự chênh lệch sai số đo lường giữa nhóm chuẩn và nhóm can thiệp tạo chệch lên trong ước lượng OLS bằng , khuếch đại hệ sốd_nh_twotừ+0.1202kèm lên+0.1388kèm và dịch chuyểnd_b_beforetừ+0.0797kèm lên+0.0979kèm ; Đồng thời, lỗi chữ thường của lệnhdirtrongPROCESS.dotrên Windows gây phân loại sai hoàn toàn nhóm"TWO"về"ONE", triệt tiêu toàn bộ hiệu ứng can thiệp nếu chạy lại nguyên bản trên Windows. - Cơ chế 2 — Bất đồng nhất cơ sở phòng thí nghiệm và tương quan nội cụm âm làm lệch phương sai ước lượng giữa các địa điểm: Hồi quy kiểm soát bốn trường đại học trên chứng minh mức nền lựa chọn rủi ro tại Đại học Kansai đạt
56.79%, vượt xa mức37.95%tại Osaka,35.19%tại Ritsumeikan và39.71%tại Tsukuba, tạo hệ số cố định+0.1923với trên biếnambvà+0.3401với trên cược xanhchBcùng kiểm định Wald địa điểm với . Mọi phân tích bảng chéo gộp bỏ qua véc-tơ hiệu ứng địa điểm chịu chệch biến bỏ sót tỷ lệ thuận với khi cơ cấu phân bổ nhánh can thiệp giữa các trường không đồng nhất tuyệt đối, đồng thời tương quan nội cụm âm giữa phần dư trong47phiên thí nghiệm kéo sai số chuẩn cụm xuống chỉ bằng0.500đến0.791lần sai số chuẩn HC1, khiến suy diễn theo cụm dễ thổi phồng mức ý nghĩa ở nhómB-beforetừ xuống . - Cơ chế 3 — Thiên lệch chọn lọc bối cảnh giữa môi trường trực tuyến và phòng thí nghiệm đe dọa tính ngoại suy ngoài mẫu: Mặc dù mô hình hao hụt Phiên 2 trên cho và chứng minh rời bỏ mẫu ngẫu nhiên theo các biến quan sát trong đợt trực tuyến, so sánh chéo bối cảnh tại
Result 7trên ghi nhận sự dịch chuyển cấu trúc lên tới+24.19điểm phần trăm giữa tỷ lệ chọn rủi ro képaatrực tuyến đạt58.33%so với phòng thí nghiệm đạt34.15%, kèm kiểm định chính xác Fisher và hệ số OLS+0.2419với . Kết hợp với chênh lệch-16.16điểm phần trăm tạiResult 4giữa hai đợt trực tuyến với và chênh lệch+41.67điểm phần trăm giữaONE-RvớiONE-BtạiResult 5.1với , điều kiện bất biến phân phối theo bối cảnh giữa trực tuyến và phòng thí nghiệm bị vi phạm có hệ thống, hàm ý rằng dữ liệu thu thập trực tuyến không giám sát tạo phản ứng hành vi khác biệt căn bản so với phòng thí nghiệm chuẩn mực. - Cơ chế 4 — Công suất kiểm định mẫu hữu hạn kết hợp thiên lệch suy diễn do kiểm định bội không hiệu chỉnh FWER và FDR: Với cỡ mẫu
110đến116người mỗi nhánh và sai số chuẩn lớn ở bậc tự do hữu hạn trong thí nghiệm chính năm 2024, phép kiểm định tỷ lệ hai mẫu cho chênh lệch quan sát+10.08điểm phần trăm giữaB-beforevàB-singlechỉ đạt công suất thống kê33.49%ở ngưỡng và đòi hỏi ít nhất371quan sát mỗi nhánh để đạt công suất80%, dẫn tới rủi ro sai lầm loại II rất cao khi diễn giải các giá trị tiệm cận không có ý nghĩa như bằng chứng khẳng định tính trung lập tuyệt đối của cơ chế trả thưởng. Ở chiều ngược lại, trong chuỗi11kiểm định độc lậpResult 1đếnResult 7trình bày tại Bảng 5, xác suất mắc ít nhất một sai lầm loại I toàn họ tăng theo biểu thức ; Khi hiệu chỉnh theo quy trình Holm–Bonferroni, cả bốn kết quả có ban đầu gồmResult 7,Result 5.1,Result 4vàResult 5đều mất ý nghĩa thống kê ở mức5%với từ0.0873đến0.2370, trong khiResult 5cũng vượt ngưỡng5%dưới hiệu chỉnh Benjamini–Hochberg với .
A.5. Khuyến nghị nâng cấp mô hình và hướng mở rộng công bố quốc tế
Từ kết quả đối chiếu model_gap_audit.json quét qua 306 bộ ước lượng thuộc 16 họ mô hình cùng 444 từ khóa định tuyến của EcoData, mã nguồn gốc ANALYSIS.do sử dụng hàm regress và logit đã được phủ bởi hai công cụ ols và logit, đồng thời đề xuất bổ sung thêm công cụ chuyên biệt exact_contingency_proportions_suite vào họ nonparametric_resampling qua hàng đợi [B1–B4] để tự động hóa trọn vẹn hiệu chỉnh của Yates (1934), kiểm định chính xác Fisher, tỷ lệ hai mẫu và cặp đôi McNemar (1947) trên cả ba nền tảng mà không cần lệnh SSC bên ngoài. Ngoài ra, nhằm đáp ứng chuẩn phản biện của các tạp chí kinh tế học vi mô hàng đầu, hội đồng thẩm định kiến nghị bốn hướng nâng cấp cụ thể:
- Chuẩn hóa công cụ kiểm định bảng ngẫu nhiên thực nghiệm tích hợp hiệu chỉnh kiểm định bội: Đóng gói
exact_contingency_proportions_suitegồm kiểm định Fisher hai phía, Yates, tỷ lệ hai mẫu, khoảng tin cậy nhị thức Wilson (1927), kiểm định McNemar (1947) theo định hướng Fagerland et al. (2013) cùng hiệu chỉnh tỷ lệ sai lầm toàn họ Holm–Bonferroni và tỷ lệ phát hiện sai Benjamini–Hochberg thành một quy trình chuẩn hóa duy nhất. - Ước lượng mô hình hỗn hợp phân cấp kết hợp suy diễn hoán vị theo phiên và địa điểm: Mở rộng đặc tả nhị phân cơ sở thành mô hình Logit hiệu ứng ngẫu nhiên hai cấp với hiệu ứng cố định phòng thí nghiệm và chặn ngẫu nhiên cấp phiên, đối chiếu song song với kiểm định hoán vị ngẫu nhiên hóa theo
47cụm phiên để xử lý triệt để hiện tượng tương quan nội phiên âm:
Trong đó:
- : quyết định lựa chọn phương án rủi ro phản ánh ác cảm mơ hồ của người tham gia trong phiên thí nghiệm ;
- : hàm liên kết logistic chuẩn tắc ánh xạ tổ hợp tuyến tính sang không gian xác suất;
- : véc-tơ các biến giả can thiệp cơ chế khích lệ ngẫu nhiên và hiệu ứng cố định địa điểm phòng thí nghiệm;
- : véc-tơ tham số hiệu ứng cố định cần ước lượng trên toàn mẫu;
- : thành phần ngẫu nhiên cấp phiên thí nghiệm tuân theo phân phối chuẩn với phương sai nội phiên .
- Áp dụng thiết kế phân tầng công suất mẫu và mở rộng thực nghiệm đa bối cảnh: Sử dụng biên độ nền thực tế từ
35.19%đến56.79%giữa bốn đại học Nhật Bản để tính toán cỡ mẫu tối thiểu từ371quan sát mỗi nhánh nhằm đạt công suất80%, đồng thời nhân rộng kiểm định song song giữa phòng thí nghiệm và nền tảng trực tuyến tại các thị trường mới nổi như Việt Nam nhằm kiểm soát hiệu ứng hiểu sai cơ chế thanh toán. - Phát hành tệp dữ liệu chuẩn hóa độc lập hệ điều hành và kiểm soát lược đồ chuỗi: Áp dụng tự động
strtrim, kiểm tra ràng buộc đối xứng cột lựa chọn theo từng nhánh đơn và lưu trữ dữ liệu phẳng chuẩn hóa nhằm loại bỏ hoàn toàn phụ thuộc hệ điều hành như lỗi chữ thường của lệnhdirtrongPROCESS.dohoặc lỗi lọc điều kiệnproblemtronganalysis2024.do.
Tài liệu tham khảo
- Aoyama, T., & Hanaki, N. (2026). Experimental Evaluation of Random Incentive System under Ambiguity. Journal of Political Economy Microeconomics. https://doi.org/10.1086/743544 ↩
- Azrieli, Y., Chambers, C. P., & Healy, P. J. (2018). Incentives in Experiments: A Theoretical Analysis. Journal of Political Economy, 126, 1472–1503. https://doi.org/10.1086/698136 ↩
- Bade, S. (2015). Randomization devices and the elicitation of ambiguity-averse preferences. Journal of Economic Theory, 159, 221–235. https://doi.org/10.1016/j.jet.2015.05.017 ↩
- Baillon, A., Halevy, Y., & Li, C. (2022). Randomize at Your Own Risk: On the Observability of Ambiguity Aversion. Econometrica, 90, 1085–1107. https://doi.org/10.3982/ECTA18137 ↩
- Dominiak, A., & Schnedler, W. (2011). Attitudes toward uncertainty and randomization: an experimental study. Economic Theory, 48, 289–312. https://doi.org/10.1007/s00199-011-0649-z ↩
- Ellsberg, D. (1961). Risk, Ambiguity, and the Savage Axioms. The Quarterly Journal of Economics, 75, 643. https://doi.org/10.2307/1884324 ↩
- Fagerland, M. W., Lydersen, S., & Laake, P. (2013). The McNemar test for binary matched-pairs data: mid-p and asymptotic are better than exact conditional. BMC Medical Research Methodology, 13. https://doi.org/10.1186/1471-2288-13-91 ↩
- Johnson, C., Baillon, A., Bleichrodt, H., Li, Z., van Dolder, D., & Wakker, P. P. (2021). Prince: An improved method for measuring incentivized preferences. Journal of Risk and Uncertainty, 62, 1–28. https://doi.org/10.1007/s11166-021-09346-9 ↩
- Kuzmics, C. (2017). Abraham Wald's complete class theorem and Knightian uncertainty. Games and Economic Behavior, 104, 666–673. https://doi.org/10.1016/j.geb.2017.06.012 ↩
- Machina, M. J., & Schmeidler, D. (1992). A More Robust Definition of Subjective Probability. Econometrica, 60, 745. https://doi.org/10.2307/2951565 ↩
- McNemar, Q. (1947). Note on the Sampling Error of the Difference Between Correlated Proportions or Percentages. Psychometrika, 12, 153–157. https://doi.org/10.1007/bf02295996 ↩
- Oechssler, J., & Roomets, A. (2014). Unintended hedging in ambiguity experiments. Economics Letters, 122, 243–246. https://doi.org/10.1016/j.econlet.2013.11.029 ↩
- Oechssler, J., & Roomets, A. (2015). A test of mechanical ambiguity. Journal of Economic Behavior & Organization, 119, 153–162. https://doi.org/10.1016/j.jebo.2015.08.004 ↩
- Oster, E. (2019). Unobservable Selection and Coefficient Stability: Theory and Evidence. Journal of Business & Economic Statistics, 37, 187–204. https://doi.org/10.1080/07350015.2016.1227711 ↩
- Raiffa, H. (1961). Risk, Ambiguity, and the Savage Axioms: Comment. The Quarterly Journal of Economics, 75, 690. https://doi.org/10.2307/1884326 ↩
- Saito, K. (2015). Preferences for Flexibility and Randomization under Uncertainty. American Economic Review, 105, 1246–1271. https://doi.org/10.1257/aer.20131030 ↩
- Schmeidler, D. (1989). Subjective Probability and Expected Utility without Additivity. Econometrica, 57, 571. https://doi.org/10.2307/1911053 ↩
- Wilson, E. B. (1927). Probable Inference, the Law of Succession, and Statistical Inference. Journal of the American Statistical Association, 22, 209–212. https://doi.org/10.1080/01621459.1927.10502953 ↩
- Yates, F. (1934). Contingency Tables Involving Small Numbers and the χ2 Test. Journal of the Royal Statistical Society Series B: Statistical Methodology, 1, 217–235. https://doi.org/10.2307/2983604 ↩
aoyama_hanaki_2026_ris_ambiguityobs_idexp_wavesessionsubject_idlocationosakaritsumeikansaitsukubatreatmentbaillonerr_sessionMở khóa dữ liệu & mã lệnh tái lập
Sau khi theo dõi phần phân tích định lượng và bình duyệt học thuật phía trên, mời bạn đăng nhập nếu đã có gói thành viên hoặc tham gia cộng đồng nghiên cứu EcoLab để trực tiếp kiểm chứng từng hệ số ước lượng trên máy cá nhân.
Khớp chính xác tên biến, đặc tả sai số chuẩn vững và ma trận kiểm định chẩn đoán của bài nghiên cứu.
Sẵn sàng nạp trực tiếp vào môi trường thống kê cá nhân để đối chiếu độc lập từng bảng kết quả.
Đóng gói đồng bộ bản thảo chuẩn công bố tạp chí DOCX & PDF, tệp dữ liệu CSV, ba kịch bản ước lượng R · Stata · Python và hướng dẫn thực thi.
Mỗi liên kết tải xuống được cấp chữ ký bảo mật riêng cho tài khoản thành viên và tự động làm mới mượt mà ngay trên trang đọc.