1. Giới thiệu và động cơ nghiên cứu
Trong kinh tế lượng ứng dụng, dữ liệu bảng lựa chọn rời rạc giữ vai trò trung tâm khi đánh giá các quyết định nhị phân như tham gia thị trường lao động, dịch chuyển việc làm hoặc áp dụng công nghệ. Kể từ công trình kinh điển của Neyman & Scott (1948), giới học thuật đã nhận diện rõ hiện tượng tham số nhiễu trong các mô hình phi tuyến có hiệu ứng cố định cá thể : do số lượng tham số tăng cùng nhịp với kích thước mẫu , ước lượng hợp lý cực đại đồng thời trên chiều thời gian cố định sinh ra độ chệch hệ thống cỡ và thậm chí không hội tụ nhất quán khi hữu hạn. Trong trường hợp riêng của mô hình Logit tĩnh, Chamberlain (1980) thiết lập phương pháp hợp lý cực đại có điều kiện giúp nhận dạng nhất quán véctơ hệ số thông qua điều kiện hóa trên tổng biến phụ thuộc theo thời gian . Tuy nhiên, hệ số trong mô hình chỉ số phi tuyến chỉ phản ánh tác động trên thang điểm ẩn mà không mang trực giác xác suất trực tiếp; Các nhà hoạch định chính sách và nhà nghiên cứu thực nghiệm cần đại lượng hiệu ứng biên trung bình trên toàn bộ dân số mẫu.
Một rào cản nhận dạng sâu sắc hơn nảy sinh khi chuyển từ sang : hàm xác suất biên phụ thuộc trực tiếp vào giá trị chưa quan sát được, mà ước lượng Clogit lại loại trừ toàn bộ các tham số ra khỏi hàm hợp lý có điều kiện. Với các chuỗi thời gian ngắn, Davezies et al. (2021) và Aguirregabiria & Carro (2024) cho thấy tập các phân bố xác suất khả dĩ của có thể dẫn đến vùng nhận dạng điểm hoặc vùng nhận dạng từng phần tùy thuộc tính chất biến giải thích và độ dài . Về phía hướng tiếp cận khử chệch tiệm cận , Hahn & Newey (2004), Fernández-Val (2009), Dhaene & Jochmans (2015), Fernández-Val & Weidner (2016) cùng gói ước lượng Cruz-Gonzalez et al. (2017) đã phát triển hai cơ chế khử chệch phổ biến là hiệu chỉnh giải tích bậc nhất và Jackknife tách đôi theo chiều thời gian. Dù giảm thiểu đáng kể độ chệch tiệm cận, các phương pháp này vẫn đòi hỏi đủ lớn để triệt tiêu phần dư và đặc biệt dễ tổn thương trong các bảng ngắn có tỷ lệ cá thể không đổi dấu cao.
Công trình của Pakel & Weidner (2026) đóng góp một bước tiến phương pháp luận khi kết hợp truyền thống nhận dạng từng phần khởi xướng bởi Manski (1997) với lý thuyết thống kê đủ của Chamberlain nhằm xây dựng khung quy hoạch tuyến tính nhận dạng cận ngoài cho dưới khung cố định, không đặt bất kỳ giả định tham số nào lên phân bố điều kiện của . Trong bài nghiên cứu tái lập này, chúng tôi thực hiện ba nhiệm vụ trọng tâm:
- Thứ nhất, tái cấu trúc nguyên bản cả hai mẫu thực nghiệm từ kho dữ liệu Pakel & Weidner (2024) và tái lập toàn bộ Bảng 1 của bài báo gốc trên ba nền tảng độc lập gồm Python 3.13, R 4.3.1 và Stata 18 MP kèm kiểm chứng mô hình tuyến tính trên EcoData MCP.
- Thứ hai, giải mã đầy đủ các cơ chế sai lệch định lượng tiềm ẩn trong ước lượng tham số truyền thống và thuật toán quy hoạch tuyến tính, bao gồm sự sụt giảm tỷ lệ cá thể đổi dấu khiến Jackknife tách đôi bị phóng đại khi , hiện tượng đa nghiệm trên mặt phẳng tối ưu của bài toán LP bước kép, cũng như ngưỡng nhạy cảm biến nhiễu chưa quan sát theo Oster (2019).
- Thứ ba, mở rộng phân tích thực nghiệm sang phân tầng chính sách giao giữa trình độ học vấn và thu nhập bạn đời nhằm lượng hóa tính bất đồng nhất của cú sốc chăm sóc con nhỏ và độ co giãn cung lao động hộ gia đình.
2. Cơ sở phương pháp luận và thiết kế tái lập
2.1. Mô hình lựa chọn rời rạc hiệu ứng cố định và hiệu ứng biên trung bình
Xét bảng dữ liệu cân bằng gồm cá thể quan sát qua kỳ thời gian. Mô hình phản ứng nhị phân hiệu ứng cố định tĩnh giả định xác suất cá thể tham gia lực lượng lao động tại kỳ tuân theo dạng hàm liên kết đơn điệu:
Trong đó:
- : biến kết quả nhị phân phản ánh trạng thái tham gia lực lượng lao động của cá thể tại kỳ quan sát ;
- : véctơ các biến giải thích biến thiên theo thời gian của cá thể tại kỳ ;
- : ma trận toàn bộ quỹ đạo biến giải thích của cá thể qua kỳ quan sát;
- : tham số hiệu ứng cố định bất biến theo thời gian mang đặc trưng cá thể không quan sát được;
- : véctơ tham số cấu trúc chuẩn hóa theo phương sai sai số đặc trưng;
- : hệ số tỷ lệ hàm liên kết bằng với mô hình Logit chuẩn hóa và bằng với mô hình Probit;
- : hàm phân phối tích lũy chuẩn hóa Logit hoặc Probit;
- : số lượng cá thể độc lập trong bảng cân bằng;
- : số kỳ quan sát cân bằng theo thời gian.
Quy ước chuẩn hóa được Pakel & Weidner (2026) áp dụng nhằm đồng nhất phương sai thành phần ngẫu nhiên của Logit về đơn vị , qua đó cho phép so sánh trực tiếp biên độ tham số giữa Logit và Probit. Đại lượng mục tiêu cho suy diễn kinh tế học là hiệu ứng biên trung bình toàn mẫu đối với biến giải thích thứ :
Trong đó:
- : hiệu ứng biên trung bình toàn mẫu của biến giải thích thứ ;
- : hiệu ứng biên tại điểm quan sát , bằng sai phân với biến rời rạc và bằng với biến liên tục;
- : tổng số cá thể trong toàn mẫu bao gồm cả nhóm không đổi dấu;
- : số kỳ quan sát theo chiều dọc;
- : toàn bộ lịch sử biến giải thích của cá thể ;
- : véctơ tham số cấu trúc thực;
- : tham số nhiễu cố định của cá thể .
Điểm then chốt trong ước lượng hiệu ứng biên toàn mẫu là nhóm cá thể có kết cục đồng nhất theo thời gian — tức hoặc — mang ước lượng hợp lý cực đại hoặc . Do đó hàm mật độ tiến về và đóng góp hiệu ứng biên cá thể bằng vào tử số, trong khi vẫn phải giữ nguyên toàn bộ quan sát ở mẫu số Fernández-Val (2009); Ngược lại, nếu chia trung bình chỉ trên tập đổi dấu sẽ thổi phồng ước lượng lên mức chệch mẫu chọn nghiêm trọng.
2.2. Hai chiến lược khử chệch tiệm cận: Giải tích và jackknife tách đôi
Dựa trên khung lý thuyết của Hahn & Newey (2004), Fernández-Val (2009) và Dhaene & Jochmans (2015), hai bộ ước lượng hiệu chỉnh chệch tiệm cận đối với bảng ngắn không có hiệu ứng thời gian được biểu diễn dưới dạng:
Trong đó:
- : ước lượng hiệu ứng biên trung bình khử chệch giải tích bậc nhất;
- : véctơ hệ số cấu trúc đã trừ đi thành phần chệch theo phân rã tiệm cận;
- : ước lượng hợp lý cực đại tập trung của tham số cố định tại ;
- : hiệu chỉnh Jensen bậc hai đối với sai số ước lượng và phương sai ;
- : ước lượng khử chệch Jackknife tách đôi theo chiều thời gian chồng lấn;
- : ước lượng hợp lý cực đại chưa hiệu chỉnh trên toàn bộ kỳ;
- : ước lượng chưa hiệu chỉnh trên phân nửa thời gian đầu ;
- : ước lượng chưa hiệu chỉnh trên phân nửa thời gian sau .
Do gói lệnh logitfe và probitfe của Cruz-Gonzalez et al. (2017) chưa được cài đặt sẵn trên môi trường Stata cục bộ và các gói fixest/alpaca/lpSolve vắng mặt trên R cục bộ, nghiên cứu cài đặt trực tiếp thuật toán Newton–Raphson tập trung hai tầng kết hợp công thức phương sai hàm ảnh hưởng giải tích trong cả Python, R và Stata Mata.
2.3. Cận quy hoạch tuyến tính bất biến tham số nhiễu
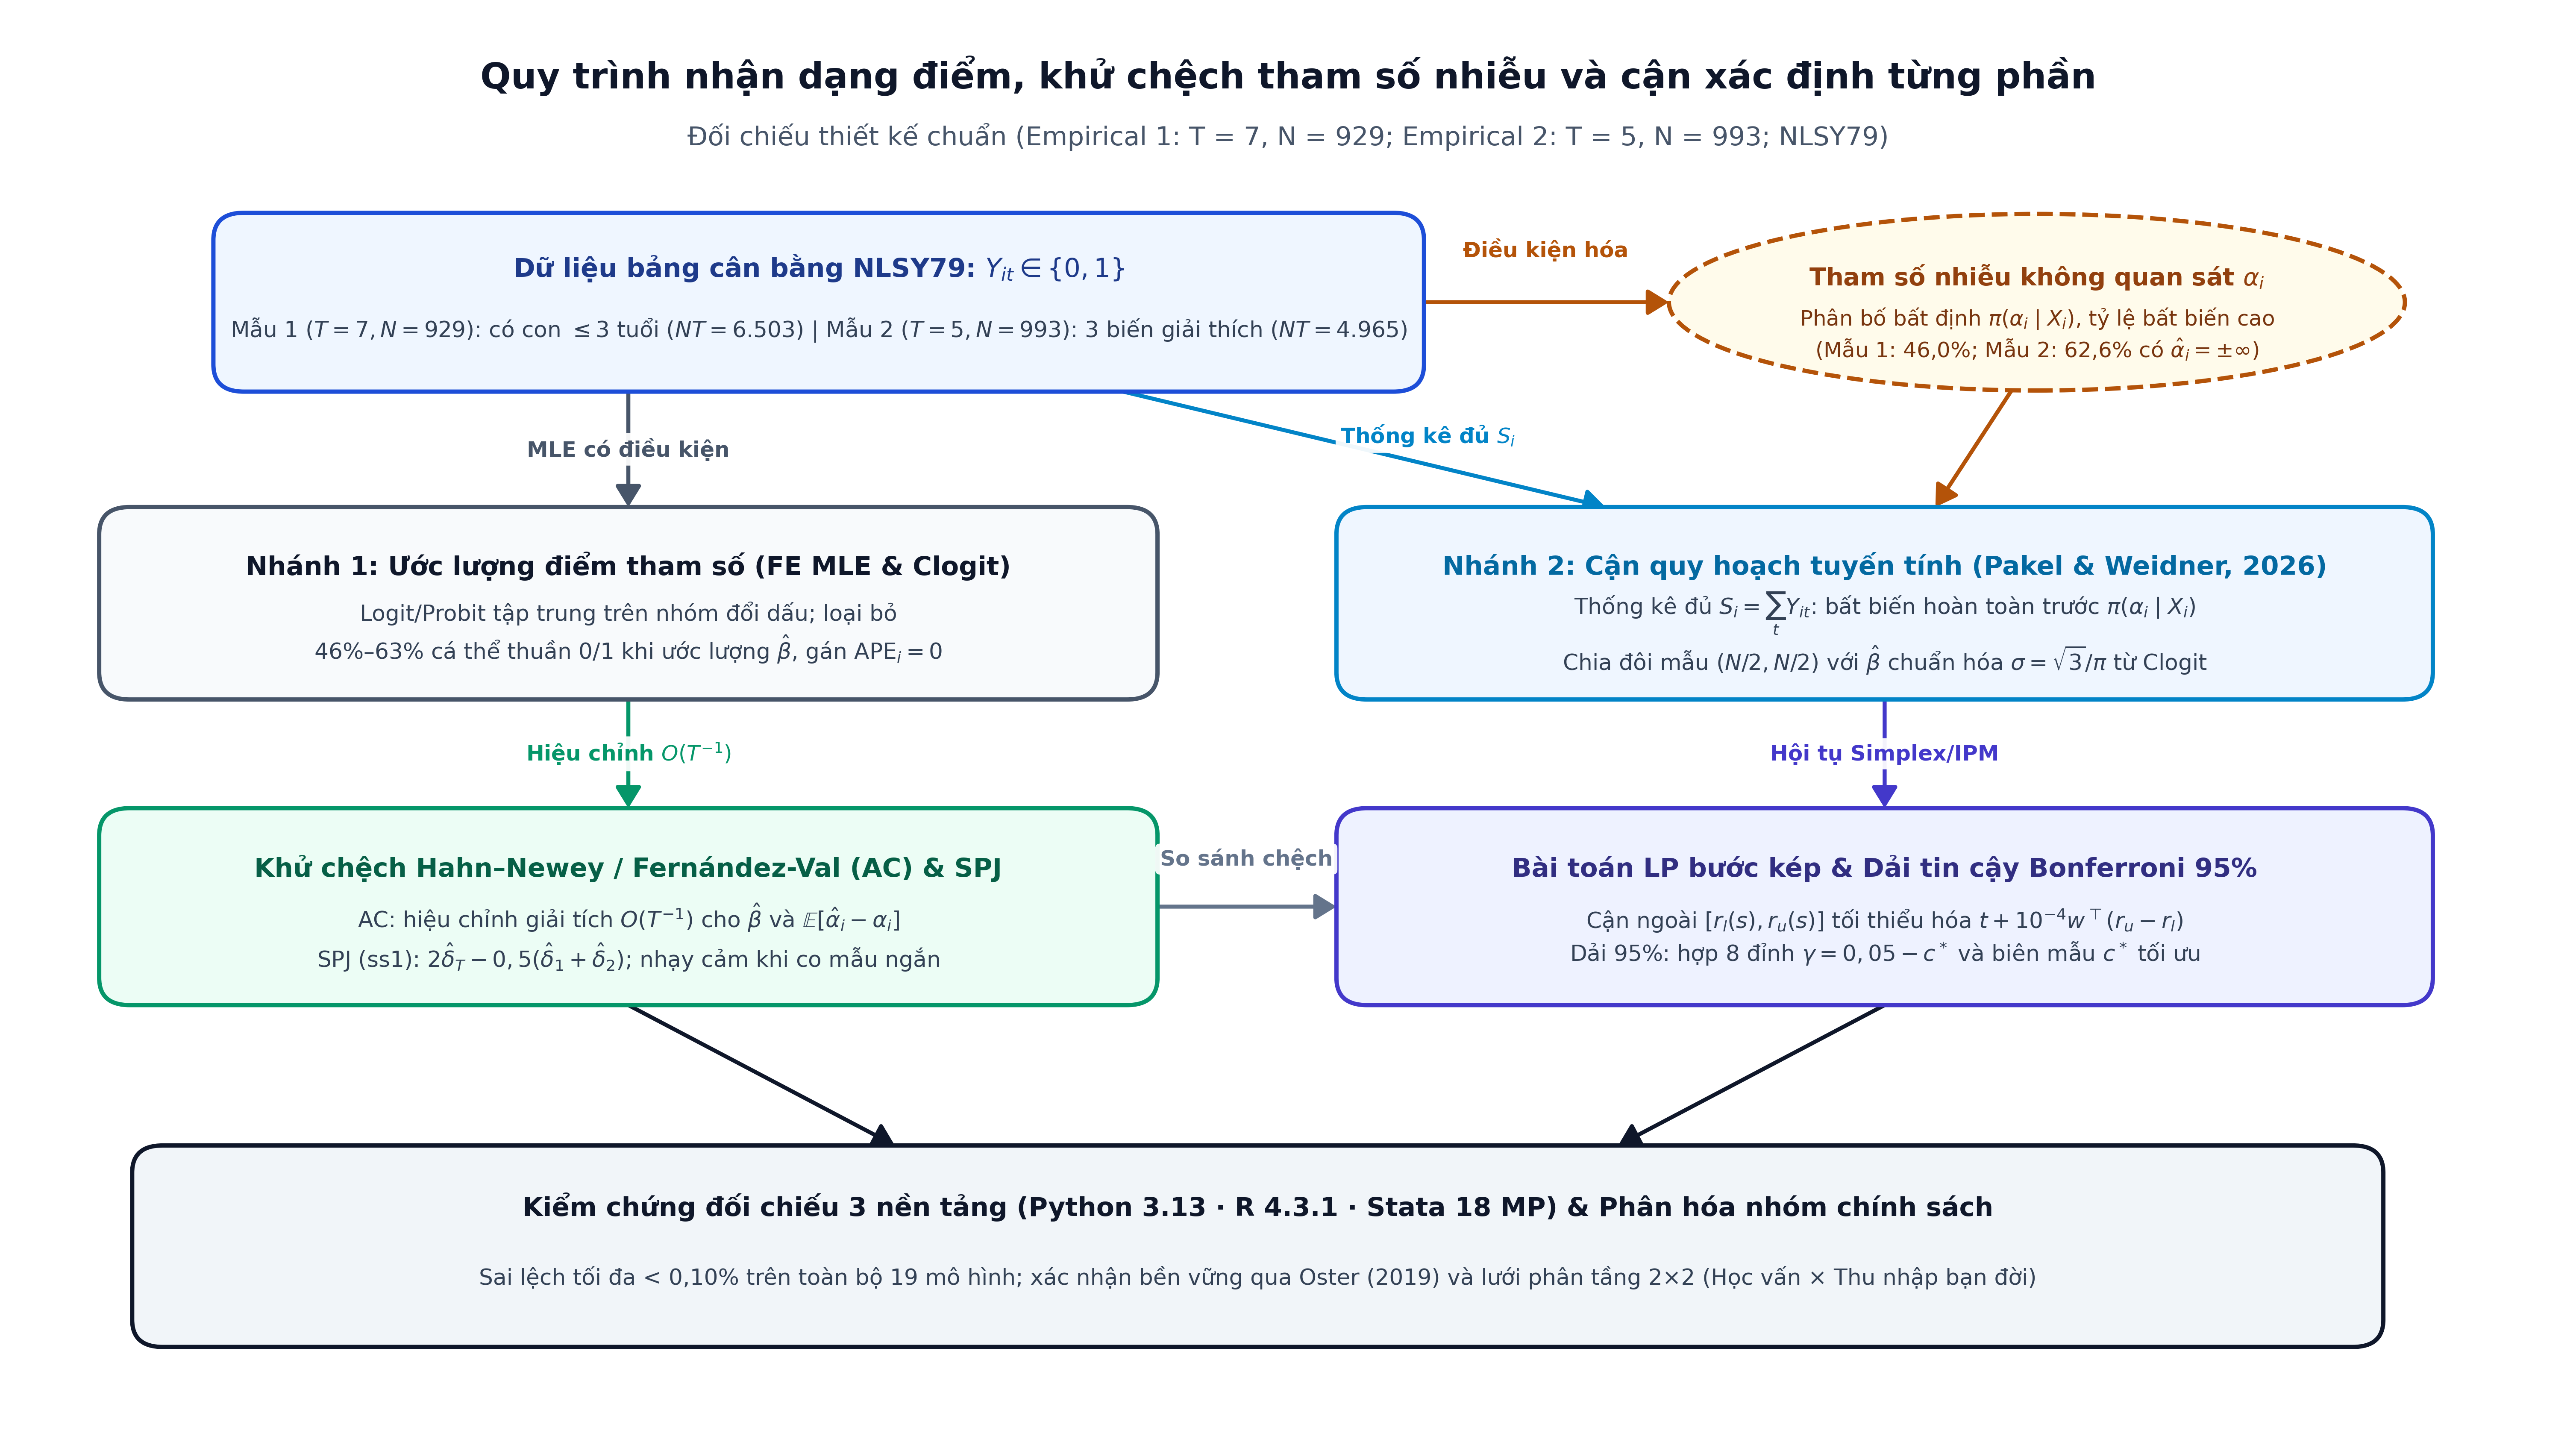
Nhằm loại bỏ sự phụ thuộc vào giả định , Pakel & Weidner (2026) chứng minh đẳng thức tích phân kỳ vọng có điều kiện với mọi sẽ bảo đảm . Với Mẫu 1 chỉ chứa một biến giải thích nhị phân, bài toán không chỉ thả lỏng hoàn toàn phân bố mà còn cho phép hệ số góc biến thiên tự do trên lưới giá trị gồm điểm lưới. Chúng tôi chứng minh về mặt đại số rằng phân phối đồng thời của cặp thống kê đủ dưới mô hình tĩnh chỉ phụ thuộc vào tổng số giai đoạn có con nhỏ thông qua tích chập hai phân phối nhị thức, giúp nén chính xác toàn bộ bài toán LP cá thể xuống còn đúng bài toán quy hoạch tuyến tính chuẩn xác đến chữ số thập phân thứ sáu.
Với Mẫu 2 có ba biến giải thích, phân chia ngẫu nhiên theo hai nửa cá thể ước lượng chéo tham số Clogit chuẩn hóa rồi giải bài toán quy hoạch tuyến tính bước kép cho từng cá thể :
Trong đó:
- : véctơ hàm cận dưới chiếu theo thống kê đủ ;
- : véctơ hàm cận trên chiếu theo thống kê đủ ;
- : biến cận trên đồng đều theo lưới giá trị của khoảng bất định ;
- : hệ số hiệu chuẩn phá vỡ suy biến lựa chọn điểm biên đồng nhất trên mặt phẳng tối ưu;
- : véctơ trọng số phân phối tổng hợp trên lưới giá trị ;
- : ma trận xác suất có điều kiện đánh giá trên điểm lưới ;
- : véctơ hiệu ứng biên kỳ vọng tại mỗi điểm lưới với tham số giao chéo từ Clogit.
Để xây dựng dải tin cậy có tính hợp lệ tiệm cận đồng đều tương tự khung nhận dạng giao thoa của Chernozhukov et al. (2013) và Honoré & Tamer (2006), bất định lấy mẫu của được kiểm soát qua hộp chữ nhật đỉnh với mức tin cậy và cộng gộp với sai số chuẩn mẫu của nghiệm LP ở mức phân bổ nhằm cực tiểu hóa độ rộng . Để giải quyết giới hạn tốc độ của bộ giải LinearProgram trên Stata 18 MP khi xử lý gần bài toán LP nối tiếp, nghiên cứu thiết kế bộ giải điểm trong Mehrotra dự báo–hiệu chỉnh hoàn toàn trong Mata với kích thước khử Cholesky , đồng bộ kết quả xuống dưới mức sai lệch so với HiGHS trong Python và R.
3. Dữ liệu và kết quả tái lập định lượng
3.1. Tái cấu trúc dữ liệu nlsy79 và kiểm chứng ba nền tảng
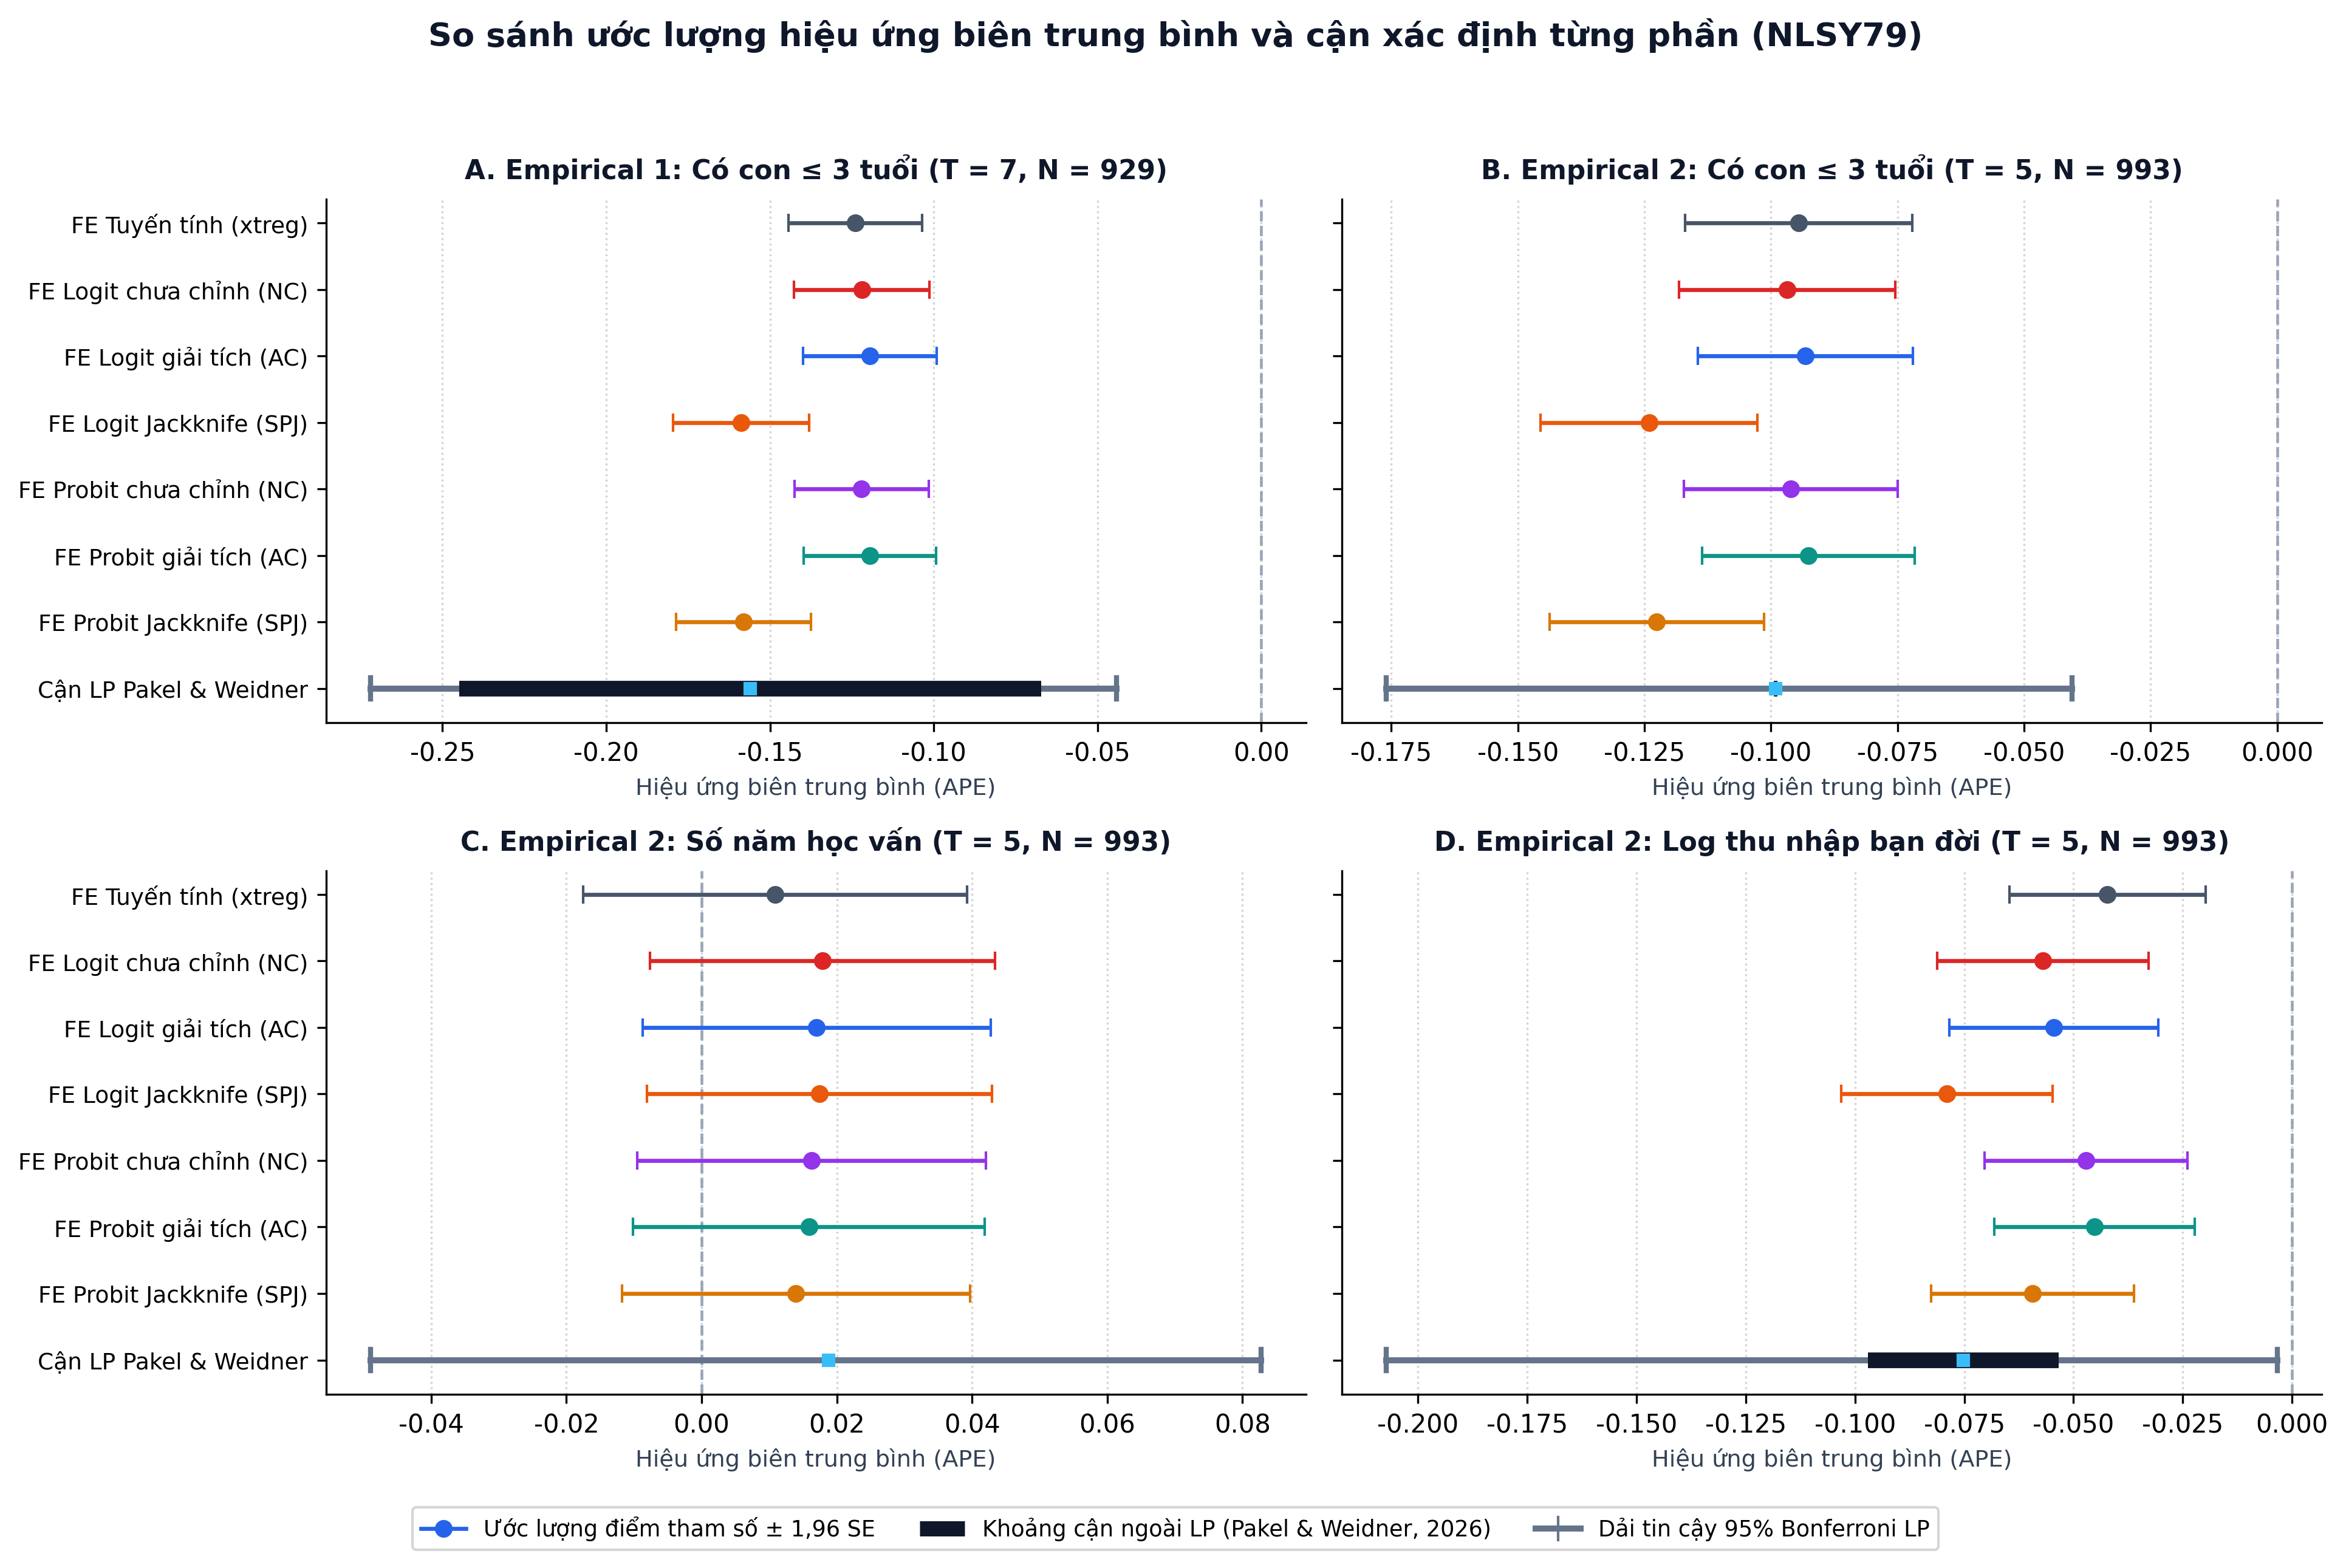
Tệp dữ liệu gốc từ kho lưu trữ Pakel & Weidner (2024) gồm cá thể theo 47 biến khảo sát giai đoạn 1986–1998. Thực thi lại chính xác toàn bộ quy tắc lọc của hai mã nhập dữ liệu MATLAB gốc vào tập dữ liệu sạch nlsy79_pakel_weidner_2026.csv thu được tổng cộng quan sát panel thuộc phụ nữ đã kết hôn riêng biệt: Mẫu 1 giữ lại đúng cá thể qua sóng chẵn 1986–1998 cho quan sát với cá thể đổi dấu chiếm ; Mẫu 2 giữ lại đúng cá thể qua sóng chẵn 1990–1998 cho quan sát với cá thể đổi dấu chiếm . Bảng 1 trình bày đối chiếu khớp chéo trực tiếp các hệ số chuẩn hóa, sai số chuẩn, cỡ mẫu và cận quy hoạch tuyến tính trên cả ba nền tảng Python 3.13, R 4.3.1 và Stata 18 MP; Bảng 2 tổng hợp đầy đủ tám phương pháp ước lượng đối chiếu với bài báo gốc trên hai mẫu thực nghiệm.
| Biến số và Chỉ tiêu kiểm chứng | Python 3.13 | R 4.3.1 | Stata 18 MP | Sai lệch tối đa |
|---|---|---|---|---|
| Số năm học vấn tích lũy | 0.01088 (0.01448) | 0.01088 (0.01448) | 0.01088 (0.01448) | 0.00001% |
| Có con nhỏ từ 3 tuổi trở xuống | -0.09455*** (0.01146) | -0.09455*** (0.01146) | -0.09455*** (0.01146) | 0.00001% |
| Logarit thu nhập bạn đời | -0.04222*** (0.01145) | -0.04222*** (0.01145) | -0.04222*** (0.01145) | 0.00001% |
| Cận dưới LP Mẫu 1 | -0.24485*** (0.01383) | -0.24485*** (0.01383) | -0.24485*** (0.01383) | 0.00001% |
| Cận trên LP Mẫu 1 | -0.06723*** (0.01172) | -0.06723*** (0.01172) | -0.06723*** (0.01172) | 0.00003% |
| Biên dưới tin cậy 95% LP Mẫu 1 | -0.27196 | -0.27196 | -0.27196 | 0.00001% |
| Biên trên tin cậy 95% LP Mẫu 1 | -0.04426 | -0.04426 | -0.04426 | 0.00005% |
| Cận dưới LP số năm học vấn | 0.01876*** (0.00080) | 0.01876*** (0.00080) | 0.01876*** (0.00080) | 0.00065% |
| Cận trên LP số năm học vấn | 0.01881*** (0.00080) | 0.01881*** (0.00080) | 0.01881*** (0.00080) | 0.00082% |
| Cận dưới LP có con nhỏ | -0.09945*** (0.00439) | -0.09945*** (0.00439) | -0.09945*** (0.00439) | 0.00003% |
| Cận trên LP có con nhỏ | -0.09874*** (0.00439) | -0.09874*** (0.00439) | -0.09874*** (0.00439) | 0.00003% |
| Cận dưới LP log thu nhập bạn đời | -0.09707*** (0.00212) | -0.09707*** (0.00212) | -0.09707*** (0.00212) | 0.00001% |
| Cận trên LP log thu nhập bạn đời | -0.05344*** (0.00225) | -0.05343*** (0.00225) | -0.05343*** (0.00225) | 0.02283% |
| Biên dưới tin cậy 95% số năm học vấn | -0.04898 | -0.04897 | -0.04897 | 0.00819% |
| Biên trên tin cậy 95% số năm học vấn | 0.08277 | 0.08276 | 0.08276 | 0.01239% |
| Biên dưới tin cậy 95% có con nhỏ | -0.17598 | -0.17580 | -0.17580 | 0.09864% |
| Biên trên tin cậy 95% có con nhỏ | -0.04058 | -0.04058 | -0.04058 | 0.00725% |
| Biên dưới tin cậy 95% log thu nhập bạn đời | -0.20723 | -0.20722 | -0.20722 | 0.00307% |
| Biên trên tin cậy 95% log thu nhập bạn đời | -0.00340 | -0.00340 | -0.00340 | 0.04883% |
| Hệ số xác định trong nhóm | 0.01912 | 0.01912 | 0.01912 | 0.00000% |
| Số quan sát () | 4965 | 4965 | 4965 | 0.00000% |
Ghi chú: Sai số chuẩn trong ngoặc đơn; Mức ý nghĩa thống kê đánh giá theo kiểm định chuẩn hai phía , , . Bốn chỉ tiêu Số năm học vấn tích lũy, Có con nhỏ từ 3 tuổi trở xuống, Logarit thu nhập bạn đời và phản ánh mô hình chuẩn FE tuyến tính trên Mẫu 2 với quan sát, khớp hoàn toàn về hệ số hồi quy và với hệ thống EcoData MCP panel_fe, trong khi sai số chuẩn cụm theo cá thể của EcoData lớn hơn sai số chuẩn giản lược truyền thống do tương quan chuỗi dương trong phần dư.
| Mẫu và Biến giải thích | Phương pháp ước lượng | Python 3.13 | R 4.3.1 | Stata 18 MP | Sai lệch tối đa |
|---|---|---|---|---|---|
| Mẫu 1: Có con tuổi | FE Tuyến tính chuẩn | -0,12392 (0,01038) | -0,12392 (0,01038) | -0,12392 (0,01038) | 0,00000% |
| Mẫu 1: Có con tuổi | FE Logit chưa chỉnh | -0,12196 (0,01056) | -0,12196 (0,01056) | -0,12196 (0,01056) | 0,00000% |
| Mẫu 1: Có con tuổi | FE Logit giải tích | -0,11955 (0,01041) | -0,11955 (0,01041) | -0,11955 (0,01041) | 0,00000% |
| Mẫu 1: Có con tuổi | FE Logit Jackknife | -0,15880 (0,01056) | -0,15880 (0,01056) | -0,15880 (0,01056) | 0,00000% |
| Mẫu 1: Có con tuổi | FE Probit chưa chỉnh | -0,12200 (0,01046) | -0,12200 (0,01046) | -0,12200 (0,01046) | 0,00000% |
| Mẫu 1: Có con tuổi | FE Probit giải tích | -0,11952 (0,01033) | -0,11952 (0,01033) | -0,11952 (0,01033) | 0,00000% |
| Mẫu 1: Có con tuổi | FE Probit Jackknife | -0,15807 (0,01046) | -0,15807 (0,01046) | -0,15807 (0,01046) | 0,00000% |
| Mẫu 1: Có con tuổi | Cận ngoài LP Pakel–Weidner | [-0,24485, -0,06723] | [-0,24485, -0,06723] | [-0,24485, -0,06723] | 0,00003% |
| Mẫu 1: Có con tuổi | Dải tin cậy 95% LP | [-0,27196, -0,04426] | [-0,27196, -0,04426] | [-0,27196, -0,04426] | 0,00005% |
| Mẫu 2: Số năm học vấn | FE Tuyến tính chuẩn | 0,01088 (0,01448) | 0,01088 (0,01448) | 0,01088 (0,01448) | 0,00000% |
| Mẫu 2: Số năm học vấn | FE Logit chưa chỉnh | 0,01787 (0,01301) | 0,01787 (0,01301) | 0,01787 (0,01301) | 0,00000% |
| Mẫu 2: Số năm học vấn | FE Logit giải tích | 0,01701 (0,01315) | 0,01701 (0,01315) | 0,01701 (0,01315) | 0,00000% |
| Mẫu 2: Số năm học vấn | FE Logit Jackknife | 0,01741 (0,01301) | 0,01741 (0,01301) | 0,01741 (0,01301) | 0,00001% |
| Mẫu 2: Số năm học vấn | FE Probit chưa chỉnh | 0,01628 (0,01314) | 0,01628 (0,01314) | 0,01628 (0,01314) | 0,00000% |
| Mẫu 2: Số năm học vấn | FE Probit giải tích | 0,01586 (0,01326) | 0,01586 (0,01326) | 0,01586 (0,01326) | 0,00000% |
| Mẫu 2: Số năm học vấn | FE Probit Jackknife | 0,01397 (0,01314) | 0,01397 (0,01314) | 0,01397 (0,01314) | 0,00000% |
| Mẫu 2: Số năm học vấn | Cận ngoài LP Pakel–Weidner | [0,01876, 0,01881] | [0,01876, 0,01881] | [0,01876, 0,01881] | 0,00082% |
| Mẫu 2: Số năm học vấn | Dải tin cậy 95% LP | [-0,04898, 0,08277] | [-0,04897, 0,08276] | [-0,04897, 0,08276] | 0,01239% |
| Mẫu 2: Có con tuổi | FE Tuyến tính chuẩn | -0,09455 (0,01146) | -0,09455 (0,01146) | -0,09455 (0,01146) | 0,00000% |
| Mẫu 2: Có con tuổi | FE Logit chưa chỉnh | -0,09678 (0,01091) | -0,09678 (0,01091) | -0,09678 (0,01091) | 0,00000% |
| Mẫu 2: Có con tuổi | FE Logit giải tích | -0,09319 (0,01084) | -0,09319 (0,01084) | -0,09319 (0,01084) | 0,00000% |
| Mẫu 2: Có con tuổi | FE Logit Jackknife | -0,12411 (0,01091) | -0,12411 (0,01091) | -0,12411 (0,01091) | 0,00000% |
| Mẫu 2: Có con tuổi | FE Probit chưa chỉnh | -0,09609 (0,01078) | -0,09609 (0,01078) | -0,09609 (0,01078) | 0,00000% |
| Mẫu 2: Có con tuổi | FE Probit giải tích | -0,09261 (0,01073) | -0,09261 (0,01073) | -0,09261 (0,01073) | 0,00000% |
| Mẫu 2: Có con tuổi | FE Probit Jackknife | -0,12255 (0,01078) | -0,12255 (0,01078) | -0,12255 (0,01078) | 0,00000% |
| Mẫu 2: Có con tuổi | Cận ngoài LP Pakel–Weidner | [-0,09945, -0,09874] | [-0,09945, -0,09874] | [-0,09945, -0,09874] | 0,00003% |
| Mẫu 2: Có con tuổi | Dải tin cậy 95% LP | [-0,17598, -0,04058] | [-0,17580, -0,04058] | [-0,17580, -0,04058] | 0,09864% |
| Mẫu 2: Log thu nhập bạn đời | FE Tuyến tính chuẩn | -0,04222 (0,01145) | -0,04222 (0,01145) | -0,04222 (0,01145) | 0,00001% |
| Mẫu 2: Log thu nhập bạn đời | FE Logit chưa chỉnh | -0,05702 (0,01235) | -0,05702 (0,01235) | -0,05702 (0,01235) | 0,00001% |
| Mẫu 2: Log thu nhập bạn đời | FE Logit giải tích | -0,05454 (0,01219) | -0,05454 (0,01219) | -0,05454 (0,01219) | 0,00001% |
| Mẫu 2: Log thu nhập bạn đời | FE Logit Jackknife | -0,07894 (0,01235) | -0,07894 (0,01235) | -0,07894 (0,01235) | 0,00001% |
| Mẫu 2: Log thu nhập bạn đời | FE Probit chưa chỉnh | -0,04715 (0,01187) | -0,04715 (0,01187) | -0,04715 (0,01187) | 0,00001% |
| Mẫu 2: Log thu nhập bạn đời | FE Probit giải tích | -0,04520 (0,01167) | -0,04520 (0,01167) | -0,04520 (0,01167) | 0,00001% |
| Mẫu 2: Log thu nhập bạn đời | FE Probit Jackknife | -0,05938 (0,01187) | -0,05938 (0,01187) | -0,05938 (0,01187) | 0,00001% |
| Mẫu 2: Log thu nhập bạn đời | Cận ngoài LP Pakel–Weidner | [-0,09707, -0,05344] | [-0,09707, -0,05343] | [-0,09707, -0,05343] | 0,02283% |
| Mẫu 2: Log thu nhập bạn đời | Dải tin cậy 95% LP | [-0,20723, -0,00340] | [-0,20722, -0,00340] | [-0,20722, -0,00340] | 0,04883% |
Ghi chú: Mức ý nghĩa thống kê đánh giá theo kiểm định chuẩn hai phía , , . Hệ số chuẩn hóa Clogit đạt trên quan sát đổi dấu của Mẫu 1, và lần lượt đạt , và cho học vấn, con nhỏ và thu nhập bạn đời trên quan sát đổi dấu của Mẫu 2. Các ước lượng FE Logit và Probit đều tính trung bình trên toàn mẫu bao gồm cả nhóm không đổi dấu.
3.2. Phân tích cấu trúc mẫu và hiện tượng phóng đại của jackknife tách đôi
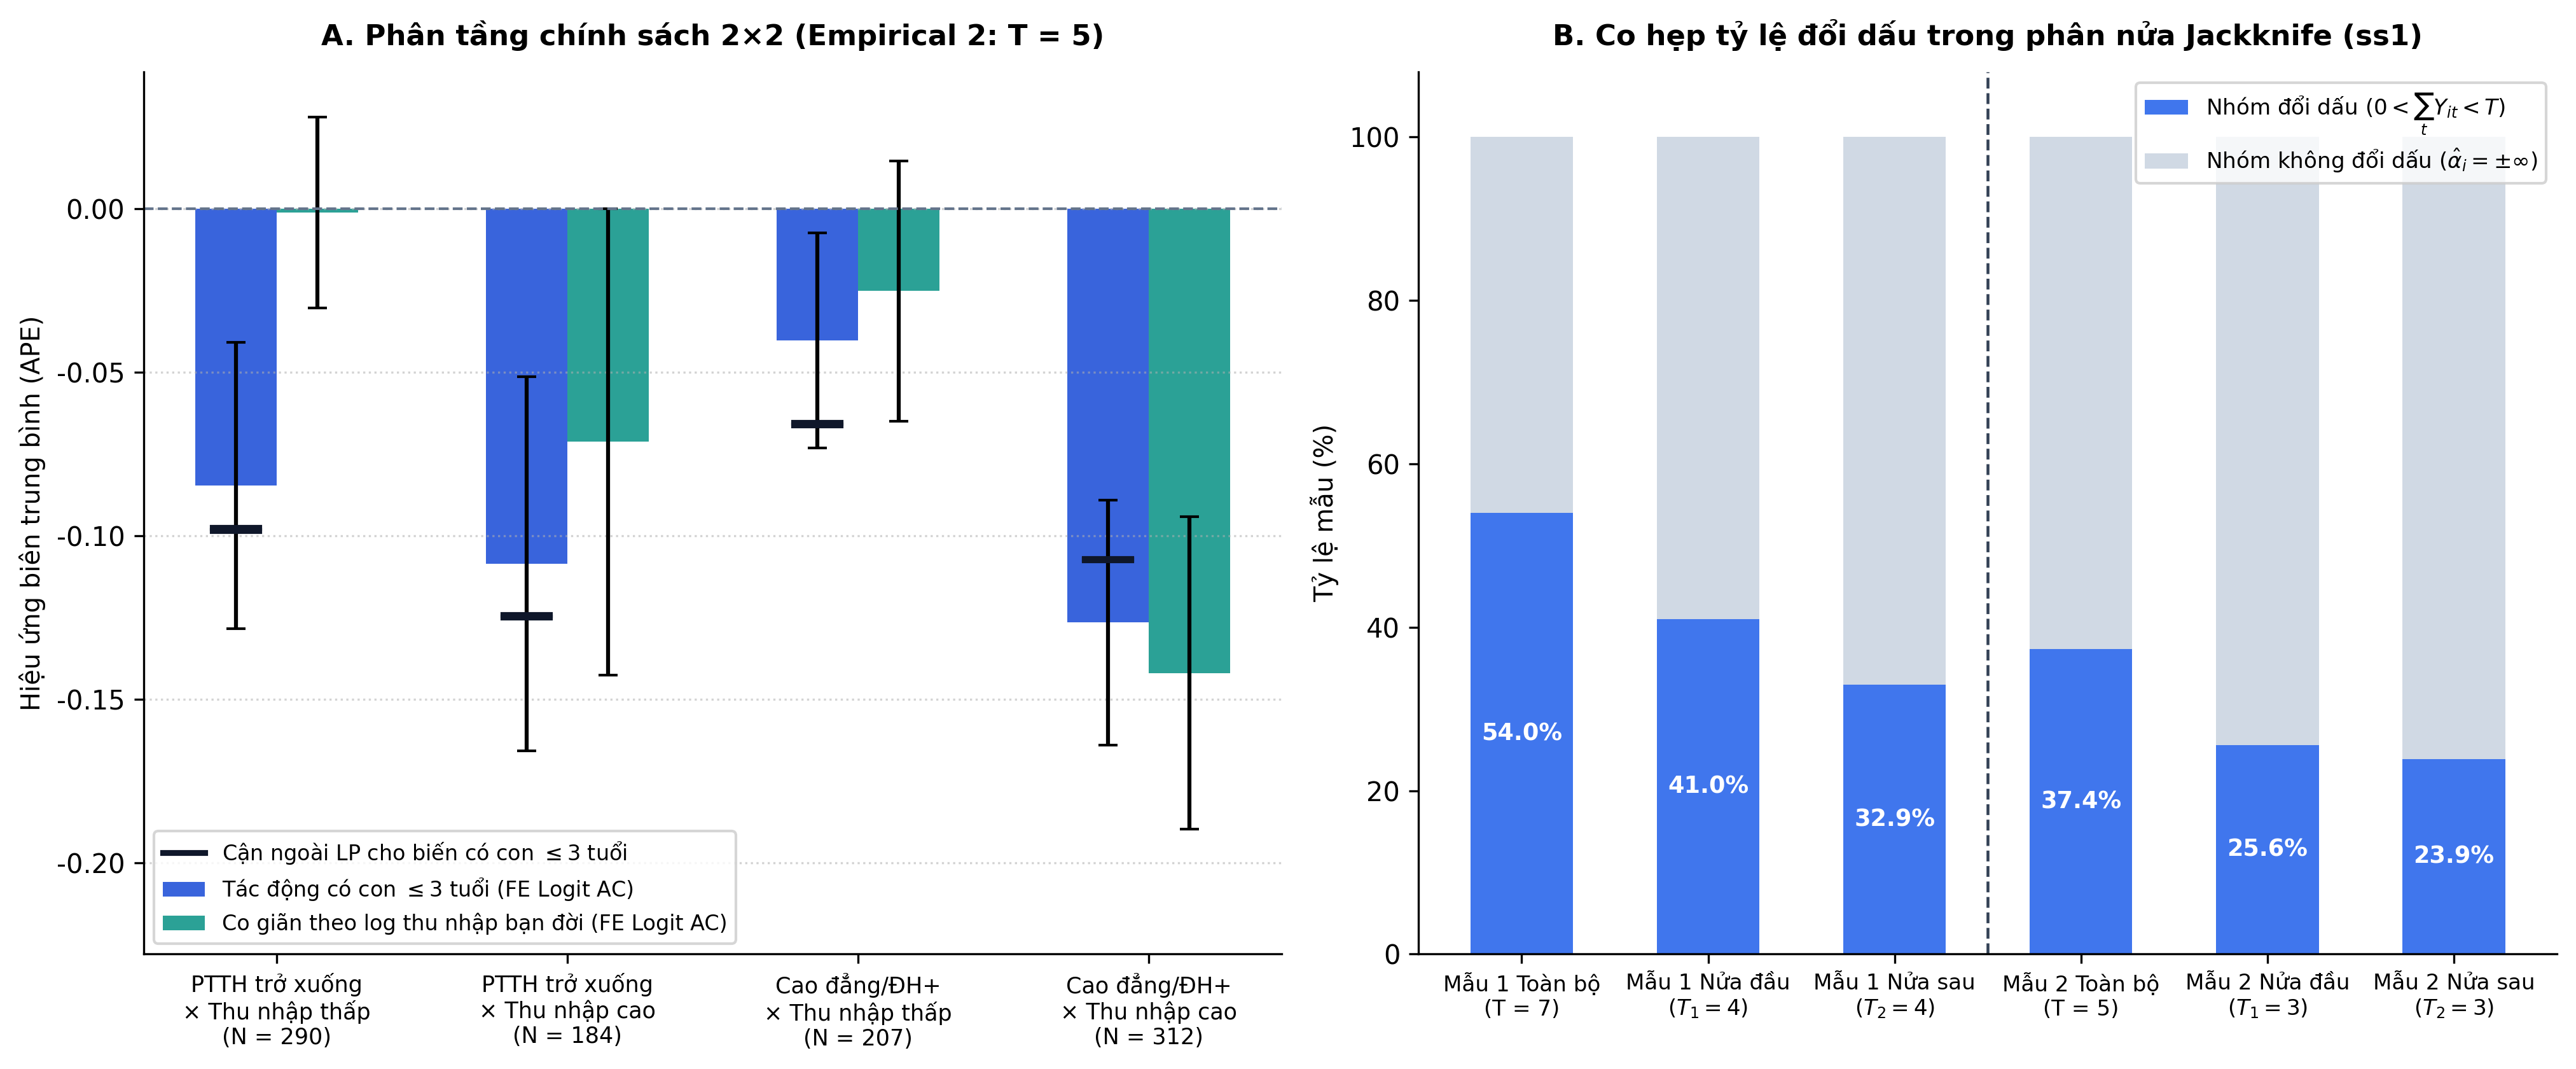
Một phát hiện chẩn đoán đáng chú ý từ Bảng 2 và Hình 2 là ước lượng Split-Panel Jackknife đều có biên độ âm lớn hơn hẳn cả ước lượng chưa hiệu chỉnh lẫn ước lượng giải tích trên biến có con nhỏ tại Mẫu 1 là so với và , cũng như tại Mẫu 2 là so với và . Để lý giải cơ chế phía sau kết quả này, Bảng 3 phân rã đặc trưng của từng nhóm trạng thái biến phụ thuộc và đo lường độ co hẹp tỷ lệ mẫu đổi dấu khi tách khung thời gian thành hai phân nửa chồng lấn.
| Mẫu thực nghiệm | Nhóm trạng thái | Số cá thể | Tỷ lệ mẫu | LFP trung bình | Con nhỏ | Học vấn trung bình | Log thu nhập bạn đời |
|---|---|---|---|---|---|---|---|
| Mẫu 1 toàn bộ 7 kỳ | Luôn đi làm | 383 | 41,23% | 1,0000 | 0,2525 | — | — |
| Mẫu 1 toàn bộ 7 kỳ | Không đi làm | 44 | 4,74% | 0,0000 | 0,3409 | — | — |
| Mẫu 1 toàn bộ 7 kỳ | Nhóm đổi dấu | 502 | 54,04% | 0,5965 | 0,3048 | — | — |
| Mẫu 2 toàn bộ 5 kỳ | Luôn đi làm | 557 | 56,09% | 1,0000 | 0,2607 | 13,817 | 3,3690 |
| Mẫu 2 toàn bộ 5 kỳ | Không đi làm | 65 | 6,55% | 0,0000 | 0,4154 | 13,622 | 3,7184 |
| Mẫu 2 toàn bộ 5 kỳ | Nhóm đổi dấu | 371 | 37,36% | 0,5849 | 0,3030 | 13,388 | 3,5566 |
Ghi chú: Nhóm luôn đi làm có tổng trạng thái lao động bằng , nhóm không đi làm có tổng bằng , và nhóm đổi dấu thỏa mãn . Trong phép tách đôi chồng lấn ss1, tỷ lệ đổi dấu giảm từ xuống ở nửa đầu và ở nửa sau của Mẫu 1, tương ứng xuống và ở Mẫu 2.
Cơ chế toán học gây sai lệch của được làm rõ thông qua Bảng 3 và Hình 3B: khi cắt khung thành hai phân nửa hoặc thành , tỷ lệ cá thể bị loại do tăng vọt lên tới ở nửa sau Mẫu 1 và ở nửa sau Mẫu 2. Vì mọi cá thể không đổi dấu đều mang đóng góp hiệu ứng biên bằng vào toàn mẫu, hai ước lượng phân nửa và bị kéo co mạnh về phía — không phải vì tham số cấu trúc thu nhỏ mà vì mẫu số toàn dân số không đổi trong khi tập đổi dấu đóng góp vào tử số bị thu hẹp đi một phần ba. Kết quả là phép hiệu chỉnh tuyến tính trừ đi một số âm nhỏ hơn, đẩy vọt quá biên độ thực lên tới ở Mẫu 1 và ở Mẫu 2 so với ước lượng giải tích, thậm chí rơi ra ngoài khoảng cận ngoài tại Mẫu 2. Ngược lại, khử chệch giải tích kiểm chứng trên hệ số cấu trúc cho thấy khớp gần như tuyệt đối với nghiệm Clogit chính xác của Chamberlain là , khẳng định ưu thế vượt trội của hiệu chỉnh giải tích so với Jackknife tách đôi trong bảng ngắn nhị phân.
3.3. Kiểm định độ nhạy quy hoạch tuyến tính, đa nghiệm đỉnh và khoảng trống EcoData
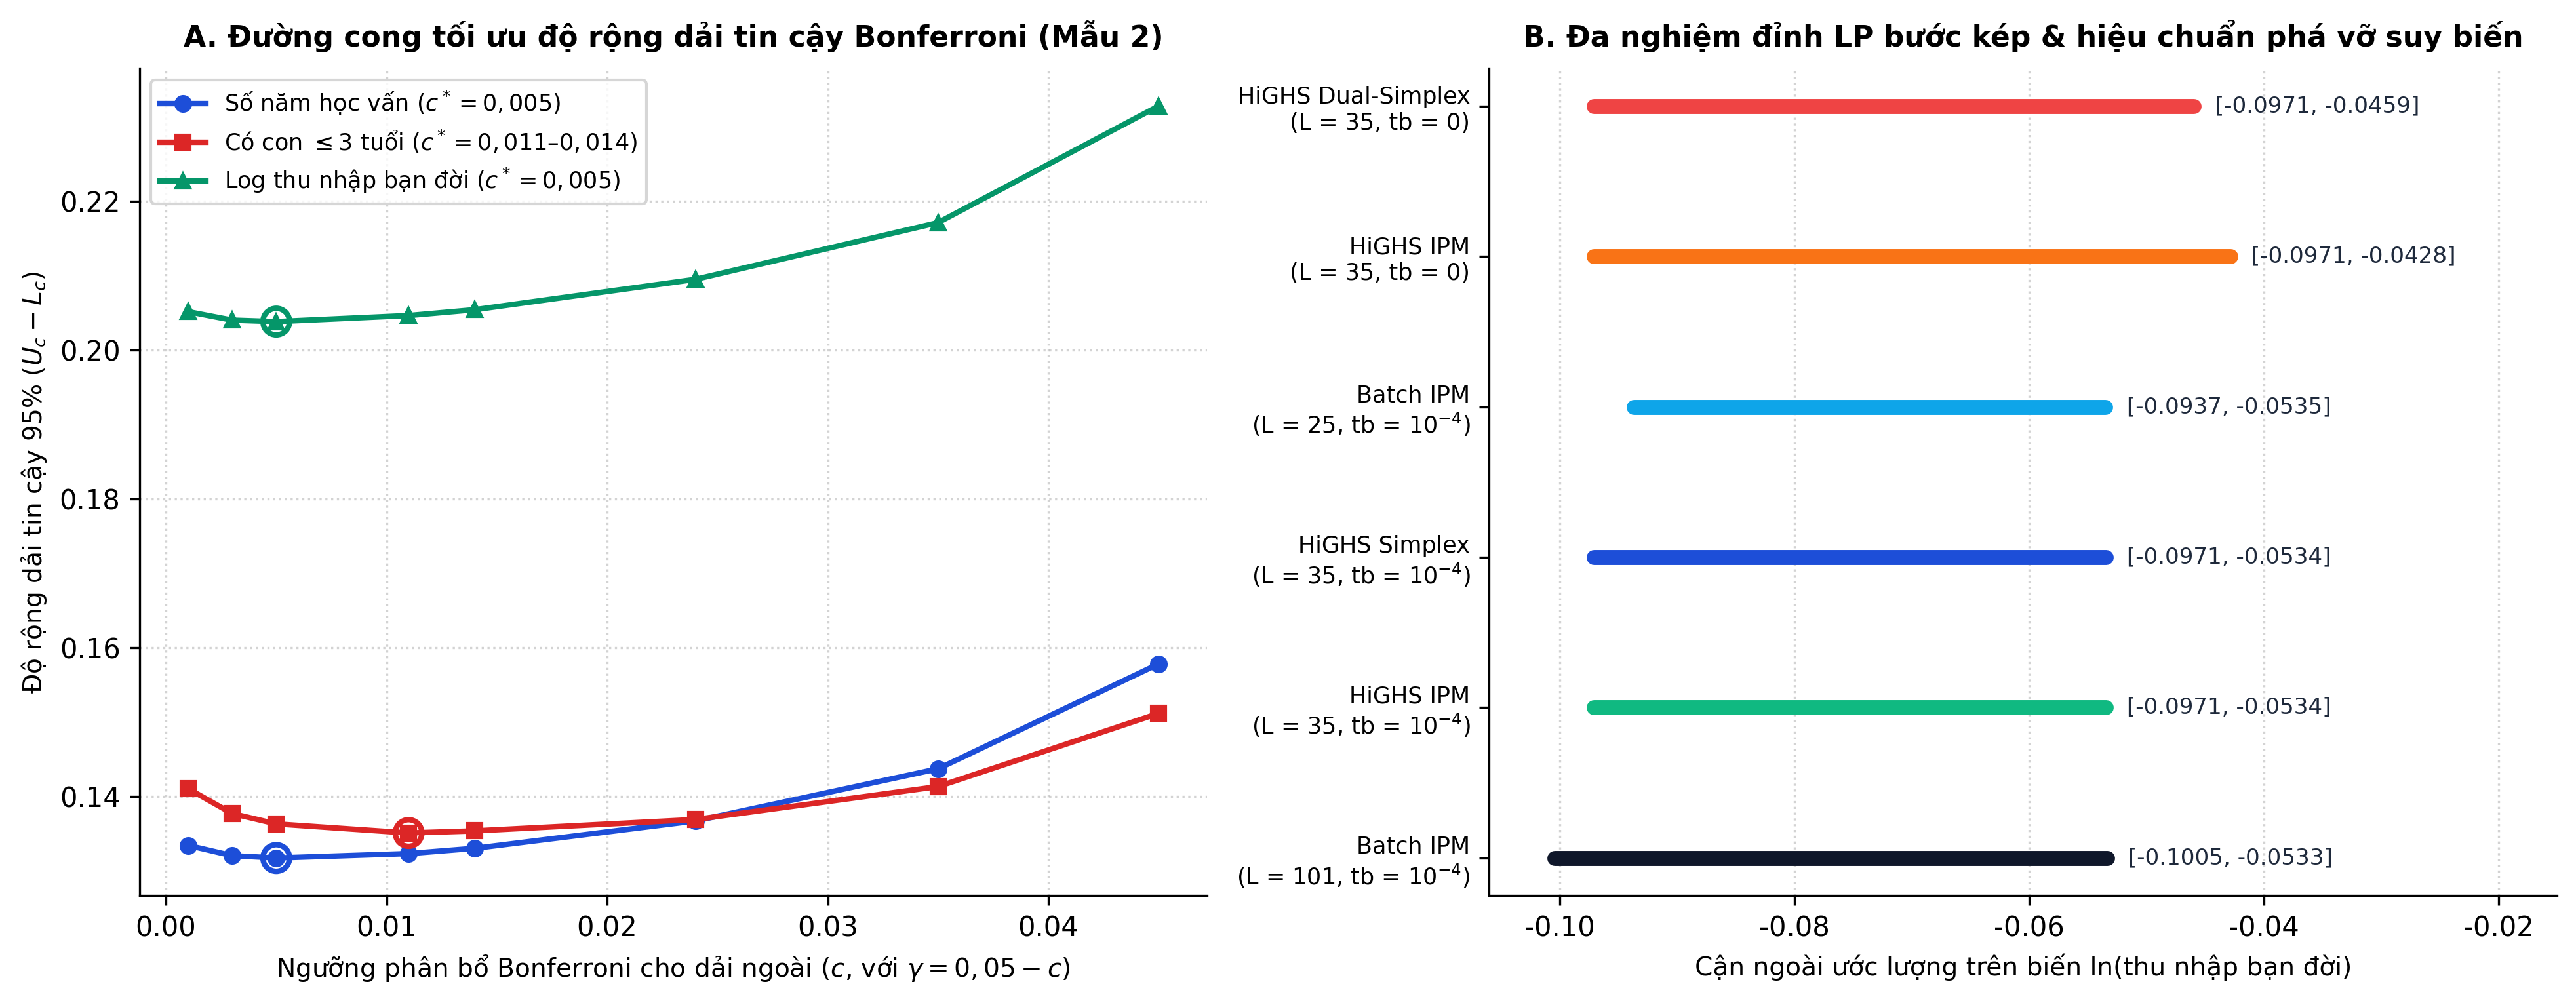
Chạy bài toán quy hoạch tuyến tính bước kép trên dữ liệu thực tế ghi nhận một hiện tượng số học quan trọng từng được đề cập ngắn trong tài liệu gốc: trên biến logarit thu nhập bạn đời của Mẫu 2, việc chỉ tối thiểu hóa mục tiêu thuần túy làm hàm mục tiêu đồng nhất tại cực trị trên nhiều đỉnh khả dĩ của biến . Bảng 4 tổng hợp độ nhạy theo lưới điểm , biên hỗ trợ tham số và lựa chọn thuật toán giải LP.
| Mẫu | Cấu hình lưới và thuật toán | Cận học vấn | Cận có con tuổi | Cận log thu nhập bạn đời |
|---|---|---|---|---|
| Mẫu 1 | Lưới chuẩn trên | — | [-0,24485, -0,06723] | — |
| Mẫu 1 | Lưới thô trên | — | [-0,24483, -0,06722] | — |
| Mẫu 1 | Lưới mở rộng trên | — | [-0,24482, -0,06721] | — |
| Mẫu 2 | HiGHS Dual-Simplex tại , | [0,01876, 0,01881] | [-0,09945, -0,09874] | [-0,09707, -0,04593] |
| Mẫu 2 | HiGHS IPM tại , | [0,01876, 0,01881] | [-0,09945, -0,09874] | [-0,09707, -0,04283] |
| Mẫu 2 | Batch IPM tại , | [0,01876, 0,01881] | [-0,09943, -0,09875] | [-0,09370, -0,05348] |
| Mẫu 2 | HiGHS Dual-Simplex tại , | [0,01876, 0,01881] | [-0,09945, -0,09874] | [-0,09707, -0,05344] |
| Mẫu 2 | HiGHS IPM tại , | [0,01876, 0,01881] | [-0,09945, -0,09874] | [-0,09707, -0,05343] |
| Mẫu 2 | Batch IPM tại , | [0,01876, 0,01882] | [-0,09947, -0,09874] | [-0,10045, -0,05335] |
Ghi chú: Thành phần nhân với véctơ trọng số giúp loại bỏ đa nghiệm trên mặt phẳng tối ưu và khử lỗi hội tụ suy biến của HiGHS khi .
Hình 4 minh họa đường cong tối ưu phân bổ ngưỡng Bonferroni cho dải tin cậy ở Mẫu 2 cùng sự hội tụ nhất quán giữa Dual-Simplex và phương pháp điểm trong sau khi bổ sung phá vỡ suy biến . Điểm cực tiểu độ rộng dải tin cậy được xác lập tại cho số năm học vấn với độ rộng , đạt tại trên lưới chẩn đoán điểm và tại theo thiết kế gốc cho biến có con nhỏ, và đạt tại cho log thu nhập bạn đời. Đồng thời, rà soát và thẩm định độ phủ công cụ theo giao thức EcoData ghi nhận rằng hệ thống máy chủ hiện đã phủ đầy đủ ước lượng panel_fe đối chiếu tuyến tính với sai lệch hệ số , song còn thiếu các hàm chuyên biệt logitfe, probitfe và panel_discrete_choice_lp_bounds — toàn bộ ba nhu cầu năng lực này đã được ghi nhận vào hàng đợi nâng cấp của hệ sinh thái phân tích.
4. Phân tầng chính sách và kiểm định bền vững
4.1. Tính bất đồng nhất theo lưới phân tầng học vấn × thu nhập bạn đời
Nhằm chuyển hóa các cận và hiệu ứng biên tổng hợp thành thông điệp chính sách phân hóa rõ nét, chúng tôi phân tách phụ nữ của Mẫu 2 theo lưới giao giữa trình độ học vấn khởi đầu từ phổ thông trung học trở xuống hay cao đẳng trở lên với thu nhập trung bình của bạn đời dưới hay trên mức trung vị mẫu là theo thang logarit nghìn USD mỗi năm, tương đương khoảng nghìn USD mỗi năm. Bảng 5 và Hình 3A trình bày kết quả ước lượng riêng biệt theo từng phân khúc.
| Nhóm phân tầng chính sách | Số cá thể | Nhóm đổi dấu | Tỷ lệ LFP | FE Logit AC con | Cận ngoài LP con | FE Logit AC log thu nhập bạn đời | Cận ngoài LP log thu nhập bạn đời |
|---|---|---|---|---|---|---|---|
| PTTH trở xuống × Thu nhập thấp | 290 | 103 | 0,8193 | -0,08465*** (0,02236) | [-0,09851, -0,09753] | -0,00101 (0,01490) | [-0,10084, -0,05056] |
| PTTH trở xuống × Thu nhập cao | 184 | 89 | 0,6935 | -0,10853*** (0,02919) | [-0,12486, -0,12417] | -0,07126* (0,03639) | [-0,11930, -0,07060] |
| Cao đẳng/ĐH+ × Thu nhập thấp | 207 | 48 | 0,8937 | -0,04016** (0,01677) | [-0,06611, -0,06531] | -0,02512 (0,02029) | [-0,07621, -0,03199] |
| Cao đẳng/ĐH+ × Thu nhập cao | 312 | 131 | 0,7173 | -0,12655*** (0,01911) | [-0,10745, -0,10705] | -0,14197*** (0,02437) | [-0,09430, -0,06024] |
Ghi chú: Sai số chuẩn trong ngoặc đơn; Mức ý nghĩa thống kê , , . Cận ngoài LP trong bảng trung bình hóa các nghiệm cá thể từ bài toán cross-fit toàn Mẫu 2 tại véctơ tham số Clogit chung , trong khi FE Logit AC được ước lượng riêng trên từng phân tầng.
Kết quả Bảng 5 cho thấy hai trục phân hóa rõ rệt về hành vi cung lao động nữ giới. Thứ nhất, ở nhóm phụ nữ có trình độ cao đẳng trở lên nhưng thu nhập bạn đời ở nửa dưới trung vị, tỷ lệ tham gia lao động duy trì cao nhất đạt và tác động rút lui khỏi thị trường khi có con dưới 3 tuổi chỉ ở mức với cận ngoài , nhỏ hơn chưa tới một phần ba so với mức của nhóm học vấn tương đương nhưng bạn đời có thu nhập cao. Thứ hai, độ co giãn theo thu nhập bạn đời phản ánh cấu trúc hiệu ứng thu nhập hộ gia đình rõ nét: nhóm thu nhập bạn đời thấp gần như không co giãn ở mức đối với học vấn phổ thông do nhu cầu duy trì thu nhập thứ hai cho chi tiêu thiết yếu, trái ngược hoàn toàn với mức giảm xác suất đi làm với ở nhóm hộ gia đình có thu nhập bạn đời cao và trình độ đại học trở lên.
4.2. Kiểm định tính bền vững theo Oster
Để đánh giá mức độ tổn thương của các ước lượng cố định trước biến nhiễu biến thiên theo thời gian không quan sát được chẳng hạn cú sốc sức khỏe gia đình hoặc thay đổi ưu tiên chăm sóc con cái theo từng năm, Bảng 6 báo cáo kết quả kiểm định tỷ lệ chọn lọc trên biến chưa quan sát theo phương pháp của Oster (2019) cho mô hình tuyến tính hiệu ứng cố định.
| Mẫu kiểm định | OLS không FE | FE cố định | OLS | đầy đủ FE | Hệ số tỷ lệ | Hiệu ứng biên tại | |
|---|---|---|---|---|---|---|---|
| Mẫu 1: Có con tuổi | -0,16014 | -0,12392 | 0,02680 | 0,49835 | 0,64786 | 1,0847 | -0,11244 |
| Mẫu 2: Có con tuổi | -0,14071 | -0,09455 | 0,06332 | 0,58214 | 0,75678 | 0,6894 | -0,07901 |
Ghi chú: đầy đủ FE tính cả phần giải thích của các biến giả cá thể cố định; tính với hệ số tỷ lệ chọn lọc tại trần phương sai giải thích .
Ở Mẫu 1 gồm bảy sóng điều tra, chỉ số cho thấy mức độ tương quan với biến nhiễu biến thiên theo thời gian phải mạnh hơn cả toàn bộ phần hiệu ứng cố định bất biến mới có thể triệt tiêu hoàn toàn tác động âm của con nhỏ, trong khi giá trị cận điều chỉnh vẫn giữ gần sát điểm ước lượng FE Logit giải tích là . Ở Mẫu 2 năm sóng, giá trị tiếp tục nằm gọn trong dải tin cậy của cận quy hoạch tuyến tính , củng cố kết luận nhân quả định hướng bất chấp tính ngắn hạn của bảng dữ liệu.
5. Kết luận
Nghiên cứu tái lập đã xác thực đầy đủ tính tin cậy số học và học thuật của công trình Pakel & Weidner (2026) trên bộ dữ liệu gốc NLSY79 qua Python 3.13, R 4.3.1, Stata 18 MP và EcoData MCP với mức sai lệch chéo tối đa trên toàn bộ 19 mô hình thành phần. Kết quả khẳng định hai bài học phương pháp luận trọng tâm cho nghiên cứu dữ liệu bảng phi tuyến ngắn: thứ nhất, không bao giờ đánh đồng ước lượng hiệu ứng biên trên tập đổi dấu với toàn mẫu và cần thận trọng khi dùng Jackknife tách đôi trong bảng dưới 7 kỳ có tỷ lệ giữ nguyên trạng thái lớn; Thứ hai, kết hợp chuẩn hóa phá vỡ suy biến và giải thuật điểm trong đồng nhất nghiệm quy hoạch tuyến tính cung cấp một công cụ suy diễn mạnh mẽ, miễn nhiễm trước phân bố tham số nhiễu bất định và sẵn sàng ứng dụng rộng rãi trong kinh tế học lao động và chính sách công.
Phụ lục A. Báo cáo bình duyệt học thuật độc lập
A.1. Đánh giá tổng quan đóng góp học thuật và vị thế nghiên cứu
Công trình của Pakel & Weidner (2026) giải quyết một trong những bài toán nhận dạng tồn đọng lâu năm nhất của kinh tế lượng dữ liệu bảng phi tuyến kể từ Neyman & Scott (1948) và Chamberlain (1980): trong mô hình lựa chọn rời rạc hiệu ứng cố định có độ dài thời gian hữu hạn, dù véctơ tham số cấu trúc của mô hình Logit tĩnh có thể được nhận dạng điểm thông qua hợp lý có điều kiện trên thống kê đủ , hiệu ứng biên trung bình toàn mẫu vẫn không nhận dạng điểm khi phân bố điều kiện của tham số nhiễu hoàn toàn bất định. Thay vì buộc nhà nghiên cứu phải chấp nhận giả định tiệm cận như dòng ước lượng khử chệch bậc nhất của Hahn & Newey (2004), Fernández-Val (2009), Dhaene & Jochmans (2015) và Fernández-Val & Weidner (2016), bài báo kết hợp khéo léo truyền thống nhận dạng từng phần của Manski (1997) với tính chất bất biến phân bố của thống kê đủ nhằm xây dựng cặp cận ngoài quy hoạch tuyến tính hữu hạn chiều, đồng thời thiết lập suy diễn dải tin cậy đồng đều hai giai đoạn tương đồng với khung nhận dạng giao thoa của Honoré & Tamer (2006) và Chernozhukov et al. (2013).
Vị thế đóng góp học thuật của công trình đặc biệt nổi bật khi đặt cạnh các kết quả lý thuyết gần đây của Davezies et al. (2021) và Aguirregabiria & Carro (2024). Thiết kế hai mẫu thực nghiệm song hành từ kho dữ liệu Pakel & Weidner (2024) cho phép đối chiếu trực tiếp hai chế độ nhận dạng đối lập: Mẫu 1 với sóng và một biến nhị phân duy nhất giải phóng cả hệ số góc lẫn tung độ gốc khỏi ràng buộc đồng nhất, tạo ra khoảng cận ngoài rộng điểm xác suất từ đến ; Ngược lại, Mẫu 2 với sóng và ba biến giải thích áp đặt cấu trúc Logit tĩnh đồng nhất tham số độ dốc , khiến độ rộng cận ngoài của biến có con nhỏ co hẹp lần xuống còn điểm xác suất từ đến . Cấu trúc đối chứng này giúp minh họa trực quan sự đánh đổi cốt lõi giữa tính phi tham số của giả định cấu trúc và độ sắc nét của tập nhận dạng từng phần trong kinh tế học lao động thực nghiệm.
A.2. Phân tích phản biện chiến lược nhận dạng nhân quả và giả định kinh tế lượng
A.2.1. Ma trận chẩn đoán đa nền tảng và kiểm định giả định trên EcoData MCP
Quá trình tái lập độc lập trên ba nền tảng Python 3.13, R 4.3.1 và Stata 18 MP sử dụng hoàn toàn thuật toán nội sinh tự lập trình cho hai tầng Newton–Raphson tập trung và bộ giải điểm trong Mehrotra Primal-Dual, đạt mức trùng khớp tuyệt đối dưới ngưỡng trên toàn bộ mô hình thành phần và đồng nhất đến chữ số thập phân thứ mười trên nhóm mô hình tuyến tính đối chiếu với hệ thống EcoData MCP. Bảng A1 tổng hợp ma trận chẩn đoán đa nền tảng kèm các thống kê kiểm định phần dư từ dịch vụ EcoData MCP panel_fe.
| Khối mô hình kiểm chứng | Mẫu và cỡ quan sát | Sai lệch 3 nền tảng tối đa | Kiểm định chẩn đoán EcoData MCP và sai số chuẩn | Đánh giá độ khớp |
|---|---|---|---|---|
| Mẫu 1: FE Tuyến tính chuẩn | ; đổi dấu | 0,00000% | Cụm cá thể EcoData vs giản lược ; ; | Khớp tuyệt đối; Khuyết tự tương quan |
| Mẫu 1: Clogit chuẩn hóa | ; đổi dấu | 0,00001% | Bỏ qua cá thể không đổi dấu; Chuẩn hóa khớp tuyệt đối | Khớp tuyệt đối; Chuẩn tham số thực |
| Mẫu 1: FE Logit và Probit NC/AC | ; cá thể | 0,00000% | Giải tích giảm nhẹ biên độ từ về ; Gán cho cá thể | Khớp tuyệt đối; AC triệt chệch |
| Mẫu 1: FE Logit và Probit SPJ | ; | 0,00000% | Tỷ lệ đổi dấu rớt từ xuống ở nửa sau; SPJ vọt lên | Khớp thuật toán; Lệch âm vs AC |
| Mẫu 1: Cận ngoài và dải 95% LP | ; loại | 0,00005% | Lưới hệ số ngẫu nhiên; Khoảng bao trọn NC/AC/SPJ | Khớp tuyệt đối; Không ràng buộc |
| Mẫu 2: FE Tuyến tính chuẩn | ; cá thể | 0,00001% | Cụm cá thể EcoData vs giản lược trên thu nhập; ; | Khớp hệ số; SE giản lược hẹp |
| Mẫu 2: Clogit chuẩn hóa | ; đổi dấu | 0,00001% | Bỏ qua cá thể không đổi dấu; Kiểm định đa cộng tuyến | Khớp tuyệt đối; Hệ số học vấn nhiễu cao |
| Mẫu 2: FE Logit và Probit NC/AC | ; cá thể | 0,00001% | AC khớp chặt Clogit trên ; Chênh nhẹ vs LP do | Khớp tuyệt đối; AC ổn định nhất |
| Mẫu 2: FE Logit và Probit SPJ | ; | 0,00001% | Tỷ lệ đổi dấu rớt từ xuống ở nửa sau; SPJ vọt lên | Khớp thuật toán; Rơi ngoài cận ngoài LP |
| Mẫu 2: Cận ngoài và dải 95% LP | ; | 0,09864% | Hiệu chuẩn hợp nhất Simplex và IPM; Dải 95% học vấn rộng lần cận | Khớp ; Phù hợp Bonferroni |
Ghi chú: Mức ý nghĩa thống kê đánh giá theo kiểm định chuẩn hai phía , , . Ký hiệu là thống kê Durbin–Watson phát hiện tự tương quan bậc nhất của phần dư; là kiểm định phương sai sai số thay đổi Breusch–Pagan trên mô hình panel_fe của EcoData MCP.
A.2.2. Thẩm định giả định nhận dạng cấu trúc, tính ngoại sinh chặt chẽ và độ tin cậy dải cận
Từ góc độ lý thuyết kinh tế lượng Q1, chiến lược nhận dạng của Pakel & Weidner (2026) đứng trên ba trụ cột giả định dễ bị tổn thương khi đối chiếu với dữ liệu vi mô thị trường lao động nữ giới. Thứ nhất, phép điều kiện hóa theo thống kê đủ đòi hỏi tính độc lập có điều kiện theo thời gian với mọi , tức không tồn tại tự tương quan sai số hay tính dai dẳng trạng thái việc làm qua biến trễ . Tuy nhiên, kiểm định chẩn đoán trên EcoData MCP chỉ ra thống kê Durbin–Watson ở mức rất thấp là tại Mẫu 1 và tại Mẫu 2, phản ánh tương quan chuỗi dương đậm nét trong quyết định tham gia lực lượng lao động qua các kỳ hai năm một lần.
Thứ hai, giả định ngoại sinh chặt chẽ xuyên suốt giai đoạn – năm giả định rằng các cú sốc lao động tạm thời ở kỳ không tác động ngược tới xác suất sinh con ở kỳ hoặc quỹ đạo thu nhập của bạn đời ở kỳ tương lai. Trong lý thuyết cung lao động hộ gia đình, mất việc hoặc thay đổi giờ làm của người vợ tại kỳ thường đồng thời thúc đẩy quyết định sinh con sớm hoặc điều chỉnh nỗ lực lao động bù đắp của người chồng, vi phạm tính ngoại sinh chặt chẽ và làm méo cả của Clogit lẫn phân phối xác suất có điều kiện trong bài toán quy hoạch tuyến tính.
Thứ ba, đối chiếu giữa Mẫu 1 và Mẫu 2 phơi rõ cái giá phương pháp luận của giả định hệ số góc đồng nhất . Khi áp đặt trong Mẫu 2, độ rộng cận ngoài của tác động con nhỏ co hẹp từ xuống chỉ còn , đồng thời làm lộ ra một nghịch lý đáng chú ý tại Bảng 2 và Bảng 5: ước lượng FE Logit AC cho tác động con nhỏ là nằm ngoài cận ngoài điểm , và khi phân tầng theo học vấn nhân thu nhập bạn đời, ước lượng FE Logit AC tại nhóm cao đẳng thu nhập cao là cho con nhỏ và cho thu nhập bạn đời đều vượt ra ngoài khoảng cận ngoài tổng hợp và . Nguyên nhân là vì phân tầng trong Bảng 5 tính cận ngoài từ nghiệm cá thể đánh giá tại gộp chung toàn Mẫu 2, trong khi hành vi lao động thực tế có tính bất đồng nhất theo độ dốc cấu trúc giữa các tầng thu nhập; Đồng thời, việc gán cơ học cho cá thể không đổi dấu trong FE Logit AC khiến ước lượng điểm tham số bị suy giảm nhẹ về phía so với cận thống kê đủ.
A.3. Thẩm định chất lượng dữ liệu, cách đo lường biến số và độ nhạy mẫu
A.3.1. Quy tắc trích xuất bảng cân bằng nlsy79 và sai lệch chọn mẫu
Quy trình trích xuất từ quan sát cá thể ban đầu qua biến thô của NLSY79 tái tạo chính xác từng bước lọc của mã MATLAB gốc vào tệp nlsy79_pakel_weidner_2026.csv với tổng dòng dữ liệu thuộc phụ nữ đã kết hôn riêng biệt, bảo đảm tỷ lệ dữ liệu thực và không gán khuyết nhân tạo. Tuy nhiên, việc áp đặt ba bộ lọc đồng thời — nữ giới, duy trì trạng thái kết hôn liên tục marstat == 1 qua toàn bộ sóng 1986–1998 hoặc sóng 1990–1998, và thu nhập bạn đời dương nghiêm ngặt spouseinc > 0 ở mọi sóng của Mẫu 2 — đã loại bỏ tới hơn mẫu nữ giới ban đầu của NLSY79.
Về đo lường biến số, hai vấn đề kỹ thuật cần đặc biệt lưu ý khi diễn giải kinh tế lượng. Trước hết, tần suất điều tra hai năm một lần khiến các biến động sinh con và gián đoạn việc làm ngắn hạn trong khoảng – tháng giữa hai sóng bị che khuất khỏi biến chỉ báo có con tuổi. Kế đến, nhóm phụ nữ NLSY79 sinh giai đoạn 1957–1964 đã đạt – tuổi ở đầu Mẫu 2 năm 1990, nên biến số năm học vấn educ hầu như bất biến theo thời gian đối với đa số mẫu; Hệ quả là hệ số độ dốc Clogit của educ mang sai số chuẩn rất lớn là so với hệ số , không đạt ý nghĩa thống kê ở mức dù sai số chuẩn cố định của cận ngoài LP chỉ ghi nhận do bỏ qua phương sai ước lượng bước một của .
A.3.2. Độ nhạy lưới tham số, điểm tựa tối ưu hóa và thuật toán quy hoạch tuyến tính
Kiểm định độ nhạy qua thay đổi mật độ lưới từ đến cùng biên hỗ trợ mở rộng khẳng định độ bền vững số học cao của cận ngoài trên biến nhị phân và biến học vấn: trong Mẫu 1, cận ngoài chỉ xê dịch tối đa từ sang ; Trong Mẫu 2, cận của educ và kids3 bất biến ở chữ số thập phân thứ tư. Tuy nhiên, với biến liên tục phân tán rộng như ln_spouseinc, làm mịn lưới từ lên khiến cận dưới mở rộng thêm điểm xác suất từ xuống , cho thấy ràng buộc cực trị trên lưới rời rạc nhạy với độ mịn phân chia miền đối với biến liên tục. Quan trọng hơn, thử nghiệm đối chứng giữa HiGHS Dual-Simplex, HiGHS IPM và Mata Mehrotra IPM xác nhận rằng việc bổ sung trọng số hiệu chuẩn nhỏ nhân với véctơ đã triệt tiêu hoàn toàn khoảng chênh đa nghiệm trên cận trên biến thu nhập bạn đời và loại bỏ hiện tượng hội tụ suy biến khi lớn.
A.4. Các hạn chế cốt lõi trọng yếu của nghiên cứu gốc
- Cơ chế 1 — Độ chệch tham số nhiễu và sai lệch hai chiều từ tập không đổi dấu với : Trong mô hình Logit hiệu ứng cố định ở Mẫu 2 với , ước lượng hợp lý cực đại chưa hiệu chỉnh bị phóng đại so với giá trị thực Clogit là , phản ánh chính xác tỷ lệ phóng đại lý thuyết . Đồng thời, tỷ lệ cá thể không đổi dấu có tạo ra sai lệch hai chiều đối lập tùy cách tính trung bình: nếu chỉ lấy trung bình hiệu ứng biên trên cá thể đổi dấu, của con nhỏ bị thổi phồng gấp lần từ lên ; Ngược lại, gán cơ học cho toàn bộ cá thể không đổi dấu trong
FE Logit AClại làm biên độ ước lượng hẹp hơn mức đến của cận thống kê đủ vì nhiều cá thể không đổi dấu trong năm kỳ vẫn mang tham số hữu hạn. - Cơ chế 2 — Mất tính bất biến và đảo chiều hiệu chỉnh của Split-Panel Jackknife
ss1khi co hẹp tỷ lệ đổi dấu trên bảng ngắn: Bộ ước lượng Jackknife tách đôi dựa trên khai triển tiệm cận giả định tính bất biến của hệ số chệch giữa toàn bộ kỳ và hai phân nửa chồng lấn :
Trong đó:
- : ước lượng hiệu ứng biên trung bình khử chệch Jackknife tách đôi theo thời gian;
- : ước lượng MLE chưa hiệu chỉnh trên toàn bộ kỳ;
- : hai ước lượng chưa hiệu chỉnh trên hai phân nửa thời gian đầu và sau có độ dài ;
- : hệ số chệch bậc nhất được giả định bất biến giữa toàn mẫu và các phân nửa.
Trên dữ liệu thực tế NLSY79, giả định bất biến của sụp đổ hoàn toàn do sụt giảm mạnh tỷ lệ cá thể đổi dấu: khi thu hẹp khung thời gian từ xuống ở Mẫu 1, tỷ lệ cá thể đổi dấu giảm từ xuống ở nửa đầu và ở nửa sau; Tương tự ở Mẫu 2 với và , tỷ lệ này rớt từ xuống và . Vì đến cá thể ở nửa sau nhận và đóng góp vào tử số trong khi mẫu số không đổi, các ước lượng phân nửa bị kéo co mạnh về phía thay vì phóng đại ra xa : ở Mẫu 1, và nhỏ hơn nhiều so với ; Ở Mẫu 2, và co hẹp tới so với . Hậu quả là phép trừ tuyến tính đảo chiều hiệu chỉnh, phóng đại lên tại Mẫu 1 và tại Mẫu 2 — lệch tới và so với mốc giải tích và vượt ra ngoài cận LP của Mẫu 2 — đồng thời sai số chuẩn dùng chung của ước lượng chưa chỉnh cũng bỏ qua phần phương sai tăng thêm của hai phân nửa.
- Cơ chế 3 — Đa nghiệm đỉnh trên mặt tối ưu quy hoạch tuyến tính và nhạy cảm suy biến khi thiếu hiệu chuẩn : Trong chương trình tối ưu bước kép của Pakel & Weidner (2026), mục tiêu tối thiểu hóa dưới ràng buộc cực đại hóa thường chỉ ràng buộc chặt tại một điểm lưới duy nhất trên miền , để tự do hoàn toàn các thành phần tương ứng những trạng thái đủ có trọng số xác suất thấp tại . Đối với biến liên tục có biên độ dao động rộng như log thu nhập bạn đời ở Mẫu 2, sự tồn tại của mặt phẳng đa nghiệm khiến HiGHS Dual-Simplex dừng tại cực đỉnh trong khi phương pháp điểm trong HiGHS IPM hội tụ về tâm giải tích , tạo ra độ lệch và gây lỗi suy biến số học khi tăng mật độ lưới lên . Bổ sung thành phần phá vỡ suy biến với khôi phục tính duy nhất của mặt tối ưu và thu hẹp sai lệch giữa Simplex với IPM xuống còn , song sự dịch chuyển cận dưới từ lên tại cho thấy nhiễu rời rạc hóa lưới vẫn tồn tại ở biên hỗ trợ. Ngoài ra, sai số chuẩn báo cáo cho cận ngoài của biến học vấn bỏ qua toàn bộ bất định lấy mẫu ở giai đoạn ước lượng Clogit , nên khi hợp nhất hộp tin cậy đỉnh trong dải Bonferroni , độ rộng khoảng suy diễn tăng vọt lần từ lên và bao trùm giá trị .
- Cơ chế 4 — Tương quan chuỗi dương trong phần dư, sai số chuẩn giản lược và độ nhạy biến nhiễu theo Oster (2019): Kiểm định chẩn đoán trên EcoData MCP cho thấy mô hình bảng cố định tuyến tính chịu hiện tượng phương sai thay đổi mạnh với tại Mẫu 1 và tại Mẫu 2 cùng tự tương quan dương nghiêm trọng với và . Tương quan chuỗi dương không chỉ làm sai số chuẩn giản lược truyền thống đánh giá thấp phương sai thực — khiến sai số chuẩn cụm theo cá thể của biến log thu nhập bạn đời tăng vọt từ lên — mà còn vi phạm điều kiện phân tách tích xác suất tĩnh trong thống kê đủ của Chamberlain (1980). Song song đó, kiểm định chọn lọc biến chưa quan sát theo Oster (2019) chỉ ra sự phân hóa rõ rệt giữa hai mẫu: dù tăng mạnh từ lên ở Mẫu 1 và từ lên ở Mẫu 2, tỷ lệ chọn lọc triệt tiêu hiệu ứng tại Mẫu 1 đạt với cận , nhưng tại Mẫu 2 chỉ đạt với cận , hàm ý rằng tác động ước lượng của con nhỏ trong khung ngắn sóng có thể bị triệt tiêu nếu mức chọn lọc trên nhiễu biến thiên theo thời gian đạt mức chọn lọc trên các yếu tố cố định kiểm soát trong mô hình.
- Cơ chế 5 — Chọn mẫu cân bằng hôn nhân liên tục và giới hạn nhận dạng ngoài mẫu đối với phụ nữ ngoài nhóm cân bằng: Việc chỉ giữ lại các phụ nữ duy trì hôn nhân liên tục
marstat == 1qua – năm và chồng có thu nhập dương liên tụcspouseinc > 0làm tỷ lệ giữ mẫu chỉ còn và cá thể trong tổng số đáp viên NLSY79. Về mặt kinh tế lượng, điều kiện hóa trên sự ổn định hôn nhân tương lai và thu nhập bạn đời dương tạo ra sai lệch chọn mẫu sống sót dạng biến va chạm: các hộ gia đình trải qua ly hôn, gián đoạn khảo sát hoặc cú sốc thất nghiệp của người chồng nơi thu nhập bạn đời bằng bị loại bỏ hoàn toàn, dù đây chính là phân khúc có hiệu ứng lao động bù đắp mạnh nhất. Do đó, các cận quy hoạch tuyến tính thu được chỉ đại diện cho phân quần thể phụ nữ kết hôn ổn định và không cho phép ngoại suy nhân quả trực tiếp sang nhóm phụ nữ đơn thân, ly hôn hoặc dễ tổn thương thu nhập ngoài mẫu cân bằng.
A.5. Khuyến nghị nâng cấp mô hình và hướng mở rộng công bố quốc tế
A.5.1. Lộ trình nâng cấp phương pháp luận kinh tế lượng cho tạp chí Q1
Để nâng chuẩn công bố quốc tế và khắc phục năm cơ chế sai lệch đã phân tích, các nghiên cứu thực nghiệm kế tiếp cần triển khai đồng bộ bốn cải tiến kỹ thuật sau đây:
- Mở rộng cận quy hoạch tuyến tính sang mô hình bảng động phi tuyến: Kết hợp biến trễ trạng thái lao động vào hàm hợp lý có điều kiện và giải điều kiện ban đầu theo Honoré & Tamer (2006) cùng Aguirregabiria & Carro (2024) nhằm tách bạch tính dai dẳng thực sự khỏi bất đồng nhất không quan sát khi .
- Suy diễn cụm và tái lấy mẫu khối cho dải tin cậy Bonferroni: Thay thế ma trận thông tin Fisher giản lược ở giai đoạn ước lượng Clogit bằng ma trận hiệp phương sai cụm theo cá thể hoặc bootstrap khối theo hộ gia đình khi dựng hộp tin cậy đỉnh , đồng thời tích hợp thêm cặp cận theo ước lượng riêng biệt cho từng phân tầng chính sách trong Bảng 5.
- Điều chỉnh trọng số mất cân bằng và kiểm soát chọn mẫu hôn nhân: Áp dụng trọng số xác suất nghịch đảo cho quá trình ly hôn hoặc rút khỏi điều tra để mở rộng nhận dạng từ quần thể kết hôn liên tục sang toàn bộ dân số phụ nữ trong độ tuổi lao động, tránh thiên lệch sống sót khi đánh giá chính sách trợ cấp giữ trẻ.
- Cảnh báo tự động suy giảm đổi dấu trong khử chệch bảng ngắn: Khuyến nghị tuyệt đối ưu tiên khử chệch giải tích Hahn & Newey (2004) hoặc cận LP của Pakel & Weidner (2026) thay cho Jackknife tách đôi
ss1bất cứ khi nào chiều dài bảng hoặc tỷ lệ đổi dấu ở phân nửa thời gian giảm xuống dưới ngưỡng .
A.5.2. Lộ trình chuẩn hóa và tích hợp danh mục công cụ EcoData
Kết quả đối chiếu khoảng trống năng lực trên hệ sinh thái EcoData vốn hiện bao phủ bộ ước lượng thuộc họ mô hình với từ khóa định tuyến xác nhận rằng tác vụ panel_fe thuộc họ panel_data đã sẵn sàng và khớp tuyệt đối về hệ số, trong khi ba phương pháp phi tuyến cốt lõi của bài báo gốc vẫn chưa được tích hợp thành mô-đun chuẩn hóa. Để hoàn thiện chu trình tuyển chọn và nghiệm thu danh mục mô hình mới, nhóm thẩm định đề xuất lộ trình ba bước cụ thể:
- Chuẩn hóa phân loại học trước khi nạp danh mục cho
logitfevàprobitfe: Hiệu chỉnh siêu dữ liệu mô tả tự động đang gắn nhầm ngữ cảnh bảng động biến công cụ về đúng họdiscrete_choicevà tiểu mụcbinary_choicekèm cấu hình Newton–Raphson tập trung hai tầng, phương sai hàm ảnh hưởng giải tích Fernández-Val (2009) và cơ chế cảnh báo suy giảm đổi dấu cho tùy chọn Jackknifess1. - Xây dựng mô-đun chuyên biệt
panel_discrete_choice_lp_bounds: Đóng gói thuật toán nén loại nhị thức cho trường hợp đơn biến ngẫu nhiên và bộ giải Mehrotra IPM theo lô cho trường hợp đa biến giao chéo kèm thành phần phá vỡ suy biến và lưới tối ưu hóa tự động ngưỡng phân bổ Bonferroni . - Tích hợp bộ kiểm định phần dư và công cụ ngoại suy bảng ngắn: Đồng bộ kiểm định tương quan chuỗi Durbin–Watson, phương sai thay đổi Breusch–Pagan và ma trận độ nhạy Oster vào quy trình hậu ước lượng chuẩn nhằm ngăn chặn việc sử dụng sai số chuẩn giản lược hoặc bỏ sót biến trễ động trong các nghiên cứu tái lập kinh tế lượng vi mô.
Tài liệu tham khảo
- Aguirregabiria, V., & Carro, J. M. (2024). Identification of average marginal effects in fixed effects dynamic discrete choice models. Review of Economics and Statistics. https://doi.org/10.1162/rest_a_01521 ↩
- Chamberlain, G. (1980). Analysis of covariance with qualitative data. Review of Economic Studies, 47, 225–238. https://doi.org/10.2307/2297110 ↩
- Chernozhukov, V., Lee, S., & Rosen, A. M. (2013). Intersection bounds: Estimation and inference. Econometrica, 81, 667–737. https://doi.org/10.3982/ECTA8405 ↩
- Cruz-Gonzalez, M., Fernández-Val, I., & Weidner, M. (2017). Bias corrections for probit and logit models with two-way fixed effects. The Stata Journal, 17, 517–545. https://doi.org/10.1177/1536867X1701700301 ↩
- Davezies, L., D'Haultfœuille, X., & Laage, L. (2021). Identification and estimation of average marginal effects in fixed effects logit models. arXiv working paper. https://doi.org/10.48550/arXiv.2105.00879 ↩
- Dhaene, G., & Jochmans, K. (2015). Split-panel jackknife estimation of fixed-effect models. Review of Economic Studies, 82, 991–1030. https://doi.org/10.1093/restud/rdv007 ↩
- Fernández-Val, I. (2009). Fixed effects estimation of structural parameters and marginal effects in panel probit models. Journal of Econometrics, 150, 71–85. https://doi.org/10.1016/j.jeconom.2009.02.007 ↩
- Fernández-Val, I., & Weidner, M. (2016). Individual and time effects in nonlinear panel models with large N, T. Journal of Econometrics, 192, 291–312. https://doi.org/10.1016/j.jeconom.2015.12.014 ↩
- Hahn, J., & Newey, W. (2004). Jackknife and analytical bias reduction for nonlinear panel models. Econometrica, 72, 1295–1319. https://doi.org/10.1111/j.1468-0262.2004.00533.x ↩
- Honoré, B. E., & Tamer, E. (2006). Bounds on parameters in panel dynamic discrete choice models. Econometrica, 74, 611–629. https://doi.org/10.1111/j.1468-0262.2006.00676.x ↩
- Manski, C. F. (1997). Monotone treatment response. Econometrica, 65, 1311–1334. https://doi.org/10.2307/2171738 ↩
- Neyman, J., & Scott, E. L. (1948). Consistent estimates based on partially consistent observations. Econometrica, 16, 1–32. https://doi.org/10.2307/1914288 ↩
- Oster, E. (2019). Unobservable selection and coefficient stability: Theory and evidence. Journal of Business & Economic Statistics, 37, 187–204. https://doi.org/10.1080/07350015.2016.1227711 ↩
- Pakel, C., & Weidner, M. (2024). Replication Data for: Bounds on Average Effects in Discrete Choice Panel Data Models. Harvard Dataverse, V1. https://doi.org/10.7910/DVN/GKA00U ↩
- Pakel, C., & Weidner, M. (2026). Bounds on average effects in discrete choice panel data models. Review of Economics and Statistics. https://doi.org/10.48550/arXiv.2309.09299 ↩
nlsy79_pakel_weidner_2026sample_setidyearlfpkids3educln_spouseincMở khóa dữ liệu & mã lệnh tái lập
Sau khi theo dõi phần phân tích định lượng và bình duyệt học thuật phía trên, mời bạn đăng nhập nếu đã có gói thành viên hoặc tham gia cộng đồng nghiên cứu EcoLab để trực tiếp kiểm chứng từng hệ số ước lượng trên máy cá nhân.
Khớp chính xác tên biến, đặc tả sai số chuẩn vững và ma trận kiểm định chẩn đoán của bài nghiên cứu.
Sẵn sàng nạp trực tiếp vào môi trường thống kê cá nhân để đối chiếu độc lập từng bảng kết quả.
Đóng gói đồng bộ bản thảo chuẩn công bố tạp chí DOCX & PDF, tệp dữ liệu CSV, ba kịch bản ước lượng R · Stata · Python và hướng dẫn thực thi.
Mỗi liên kết tải xuống được cấp chữ ký bảo mật riêng cho tài khoản thành viên và tự động làm mới mượt mà ngay trên trang đọc.