Phá vỡ vòng xoáy im lặng và ảo tưởng số đông: Tái lập thực nghiệm đa nền tảng
1. Giới thiệu và khung lý thuyết
Trong các vấn đề chính sách và xã hội nhạy cảm, các cá nhân có quan điểm thiểu số thường lựa chọn im lặng vì lo ngại bị cô lập xã hội, tạo nên hiện tượng tự củng cố được Noelle-Neumann (1974) định danh là vòng xoáy im lặng. Khi sự tự kiểm duyệt diễn ra có hệ thống, những người quan sát bên ngoài chỉ tiếp nhận tiếng nói từ phía có vẻ chiếm ưu thế và suy diễn sai lệch rằng quan điểm đó là chuẩn mực xã hội áp đảo, từ đó hình thành hoặc làm trầm trọng thêm trạng thái ảo tưởng số đông theo Bursztyn, Egorov và Fiorin (2020) cùng Bursztyn, González và Yanagizawa-Drott (2020). Tuy nhiên, câu hỏi thực nghiệm cốt lõi đặt ra là liệu việc cung cấp một can thiệp thông tin thuần túy mang tính định tính về cơ chế tự kiểm duyệt có thể phá vỡ điểm cân bằng im lặng và đảo ngược quá trình suy diễn sai lệch hay không.
Mục tiêu của nghiên cứu tái lập này là kiểm chứng toàn bộ chuỗi bằng chứng định lượng trong công trình của Ho và Huang (2026) từ dữ liệu gốc nguyên bản trên ba môi trường tính toán độc lập là Python 3.13, R 4.3.1 và Stata 18 MP, đồng thời thực thi 10 đặc tả đối chứng trực tiếp trên máy chủ tính toán kinh tế lượng xác định EcoData mà không phụ thuộc vào bất kỳ mô-đun sinh văn bản nào. Bên cạnh việc đối chiếu 68 mô hình hồi quy và 3 cặp kiểm định phương trình đồng thời SUEST, nghiên cứu mở rộng hệ thống chẩn đoán kinh tế lượng chuyên sâu gồm độ nhạy cụm sai số chuẩn ở năm cấp độ phân cụm, tính số cụm hiệu dụng theo Carter, Schnepel và Steigerwald (2017), thực thi Rademacher Wild Cluster Bootstrap theo Cameron, Gelbach và Miller (2008), kiểm định công cụ yếu và suy diễn vững theo Kleibergen và Paap (2006) cùng Anderson và Rubin (1949), giới hạn chọn lọc của Oster (2019), giới hạn tiêu hao mẫu của Lee (2009) và đề xuất mô hình phân loại 4 nhóm đối tượng phục vụ thiết kế chính sách truyền thông công.
2. Dữ liệu thực chứng và thiết kế nhận dạng
2.1. Cấu trúc dữ liệu chuẩn hóa và cân bằng ngẫu nhiên hóa
Toàn bộ dữ liệu phân tích được trích xuất nguyên bản từ gói tái lập công khai thuộc mã định danh doi:10.7910/DVN/OOR1AO mà không sử dụng bất kỳ quy trình mô phỏng nào, bảo đảm thuộc tính is_simulated = false. Tệp dữ liệu hợp nhất spiral_of_silence_experiment.csv bao gồm tổng cộng 3,491 quan sát trên biến chuẩn hóa được phân tách rành mạch theo trường vai trò mẫu sample_role để phục vụ đồng nhất mọi hồi quy trên cả ba ngôn ngữ lập trình. Thứ nhất, mẫu phân tích chính gồm Người tiên phong thực hiện lượt đánh giá trên 4 chủ đề chính sách nhạy cảm gồm Đổi tên trường học, Chính sách ưu tiên tuyển sinh, Án tử hình và Tiêm chủng vắc-xin. Thứ hai, mẫu Người đi sau chính gồm sinh viên hoàn thành phiên thảo luận nhóm Zoom trên tổng số cá nhân được phân bổ ngẫu nhiên ban đầu, tạo thành quan sát ở 4 chủ đề nhạy cảm và 333 quan sát cho chủ đề giả dược Đổi giờ mùa hè.
Tỷ lệ rời bỏ sau phân bổ ngẫu nhiên ở nhóm Người đi sau đạt tại nhóm đối chứng và tại nhóm can thiệp, tương ứng mức chênh lệch tiêu hao chỉ điểm phần trăm và hoàn toàn cân bằng về mặt thống kê với . Các đặc trưng nhân khẩu học nền tại thời điểm ban đầu giữa cá nhân thuộc nhóm đối chứng và cá nhân thuộc nhóm can thiệp đều cân bằng ở mọi biến kiểm soát như tỷ lệ nữ giới ở mức so với với , sinh viên gốc Á đạt so với với , và điểm quan điểm chính trị đạt so với với . Ngoài mẫu chính thu thập năm 2023 qua phòng thảo luận Zoom, dữ liệu còn tích hợp mẫu tái lập độc lập năm 2025 gồm Người đi sau tạo thành quan sát qua phòng Zoom cùng chuỗi số liệu khảo sát quốc gia Hoa Kỳ ANES giai đoạn 1974–2020 gồm cặp năm và chủ đề cho cả toàn mẫu lẫn phân mẫu phỏng vấn trực tiếp.
| Chủ đề thảo luận | Số quan sát | Đồng ý bí mật thực tế (%) | Dự đoán ban đầu (%) | Độ lệch ảo tưởng (đpt) | Giữa kỳ ĐC (%) | Giữa kỳ CT (%) | Cuối kỳ ĐC (%) | Cuối kỳ CT (%) | Tiên phong nói thật (%) |
|---|---|---|---|---|---|---|---|---|---|
| Đổi tên trường học | 333 | 39.39 | 55.72 | +16.33 | 57.22 | 49.16 | 62.64 | 45.34 | 36.00 |
| Chính sách ưu tiên | 333 | 47.43 | 52.82 | +5.39 | 57.65 | 50.90 | 59.63 | 49.76 | 44.00 |
| Án tử hình | 333 | 63.25 | 67.98 | +4.73 | 69.07 | 64.13 | 74.88 | 63.93 | 48.00 |
| Tiêm chủng vắc-xin | 333 | 81.93 | 75.66 | -6.27 | 82.99 | 76.33 | 84.63 | 80.22 | 48.00 |
| Đổi giờ mùa hè | 333 | 66.07 | 63.61 | -2.45 | 75.57 | 72.73 | 77.39 | 76.96 | — |
Ghi chú: Số liệu tính trên Người đi sau hoàn thành thảo luận tại cohort chính năm 2023 và Người tiên phong với lượt đánh giá ở 4 chủ đề chính. Đổi giờ mùa hè đóng vai trò chủ đề giả dược không gây tranh cãi xã hội trong cùng phiên thảo luận. Chữ viết tắt ĐC biểu thị nhóm Đối chứng và CT biểu thị nhóm Can thiệp nhắc nhở cơ chế im lặng.
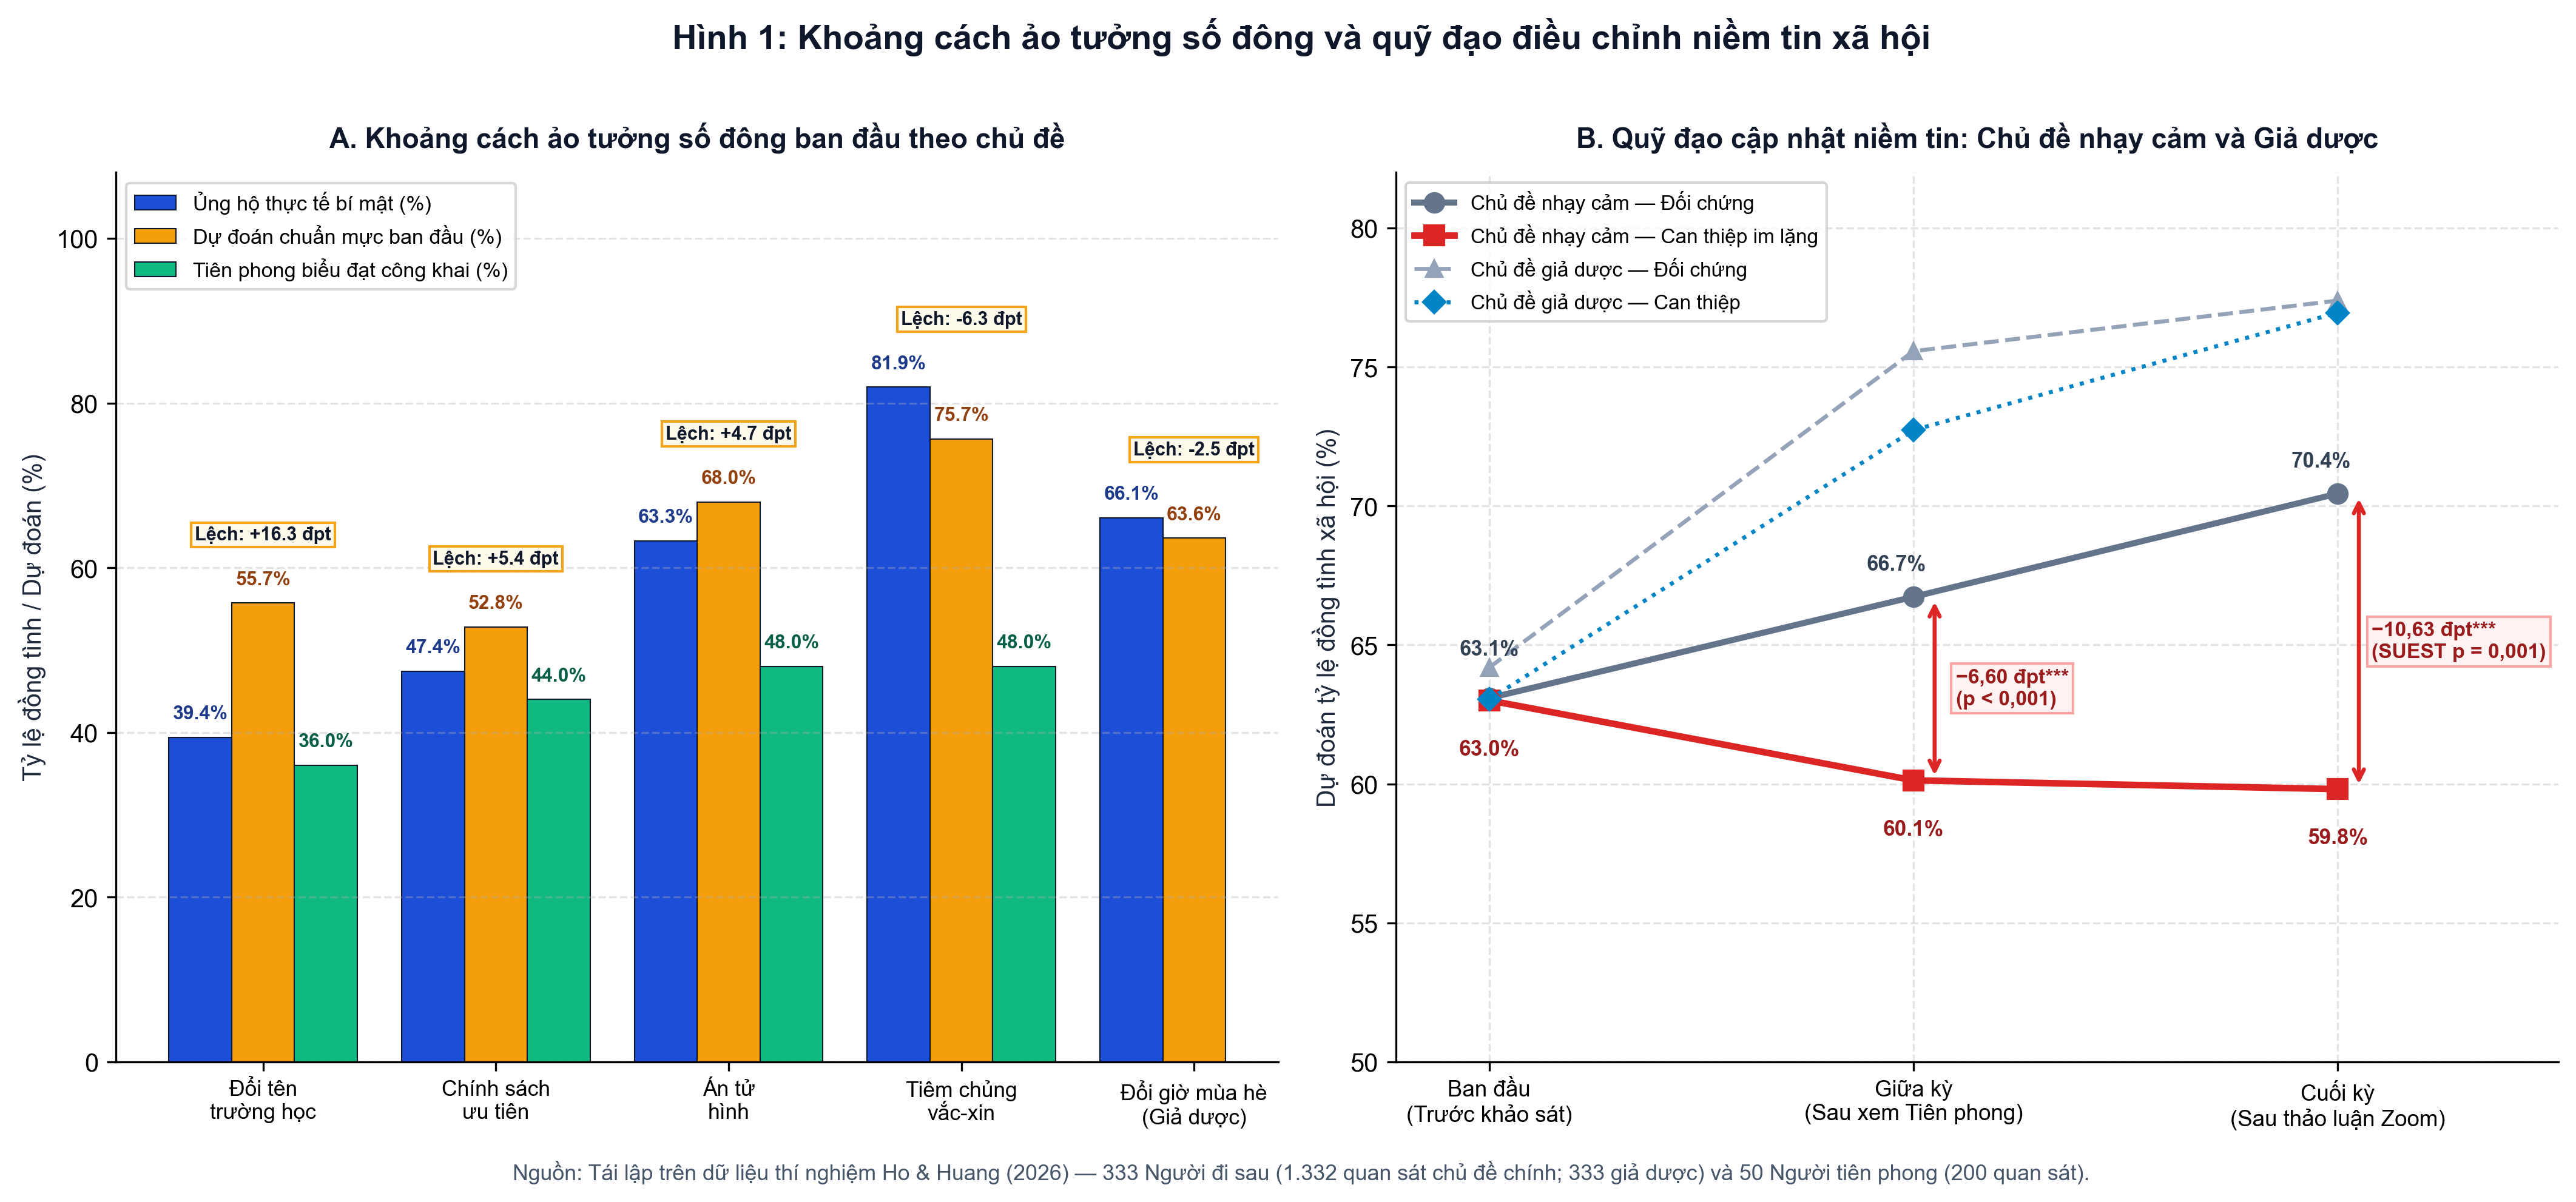
Bảng 1 và Hình 1 minh họa hai trạng thái đặc trưng làm tiền đề cho vòng xoáy im lặng. Tại thời điểm ban đầu, Người đi sau đánh giá quá cao mức độ ủng hộ xã hội đối với các chủ đề mang tính cấp tiến hoặc nhạy cảm như Đổi tên trường học với mức dự đoán so với tỷ lệ ủng hộ bí mật thực tế chỉ , tạo ra độ lệch ảo tưởng số đông tới điểm phần trăm. Trạng thái tương tự xuất hiện ở Chính sách ưu tiên với độ lệch điểm phần trăm và Án tử hình với độ lệch điểm phần trăm, trong khi các chủ đề đồng thuận cao như Tiêm chủng vắc-xin lại có mức dự đoán ban đầu thấp hơn thực tế điểm phần trăm. Đáng chú ý hơn, trong quá trình theo dõi đoạn video thảo luận của Người tiên phong và trao đổi trực tiếp qua Zoom, nhóm đối chứng trên 4 chủ đề nhạy cảm liên tục điều chỉnh nhận thức tăng từ ban đầu lên ở giữa kỳ và ở cuối kỳ, ngày càng xa rời thực tế thiểu số. Ngược lại, nhóm can thiệp đã đảo chiều quỹ đạo này xuống ở giữa kỳ và ở cuối kỳ, trong khi tại chủ đề giả dược Đổi giờ mùa hè, đường quỹ đạo của hai nhóm hoàn toàn song hành nhau.
2.2. Hệ phương trình kinh tế lượng và chiến lược nhận dạng nhân quả
Để kiểm chứng hành vi tự kiểm duyệt ở giai đoạn Người tiên phong, mô hình ước lượng xác suất tuyến tính OLS và xác suất biên trung bình Logit theo cụm cá nhân được đặc tả như sau:
Trong đó:
- : biến nhị phân nhận giá trị nếu Người tiên phong công khai biểu đạt trùng khớp với quan điểm bí mật của bản thân ở chủ đề và nhận giá trị nếu im lặng hoặc phát biểu ngược lại;
- : biến chỉ báo nhận giá trị nếu quan điểm bí mật của cá nhân trùng với lập trường được kỳ vọng chiếm đa số xã hội ở chủ đề ;
- : kỳ vọng ban đầu của cá nhân về tỷ lệ phần trăm công chúng đồng tình với quan điểm đa số ở chủ đề ;
- : vectơ các biến kiểm soát nhân khẩu học cá nhân gồm giới tính, chủng tộc, năm học, định hướng chính trị và chuyên ngành đào tạo;
- : hiệu ứng cố định theo từng chủ đề thảo luận ;
- : hiệu ứng cố định theo phiên thảo luận nhóm Zoom mà cá nhân tham gia;
- : sai số ngẫu nhiên được hiệu chỉnh cụm tại cấp độ định danh cá nhân trả lời.
Ở giai đoạn hai đối với Người đi sau, nhằm đánh giá tác động của phân bổ ngẫu nhiên can thiệp nhắc nhở cơ chế im lặng lên nhận thức xã hội ở thời điểm giữa kỳ sau khi xem video của Người tiên phong và thời điểm cuối kỳ sau khi hoàn thành thảo luận nhóm, phương trình cập nhật niềm tin được thiết lập cho từng giai đoạn :
Trong đó:
- : tỷ lệ phần trăm dự đoán đồng tình xã hội của cá nhân về chủ đề đo lường tại thời điểm với là giữa kỳ và là cuối kỳ;
- : biến chỉ báo phân bổ ngẫu nhiên can thiệp nhận giá trị nếu cá nhân xem phiên bản video có giải thích hiện tượng vòng xoáy im lặng và ở nhóm đối chứng;
- : quan điểm cá nhân bí mật của người trả lời đối với chủ đề ;
- : dự đoán chuẩn mực xã hội ban đầu của cá nhân đo trước khi tiếp nhận can thiệp;
- : vectơ kiểm soát nhân khẩu học cá nhân tương tự phương trình Người tiên phong;
- : vectơ biến kiểm soát cấp độ phiên thảo luận gồm quy mô nhóm, khung giờ thảo luận, điều phối viên và tuần khảo sát chỉ đưa vào trong mô hình cuối kỳ;
- : hiệu ứng cố định theo chủ đề ứng với từng thời điểm đo lường ;
- : sai số ngẫu nhiên được hiệu chỉnh cụm theo cá nhân ở giữa kỳ và theo phiên Zoom ở cuối kỳ, đồng thời kiểm định đồng thời sự khác biệt giữa và thông qua ước lượng phương trình dường như không liên quan
SUESTphân cụm theo cá nhân.
Tiếp theo, để kiểm chứng giả thuyết cốt lõi về việc phá vỡ vòng xoáy im lặng, hiệu ứng của can thiệp lên hành vi biểu đạt công khai trung thực của Người đi sau được ước lượng riêng biệt cho phân mẫu có quan điểm bí mật thuộc nhóm thiểu số bất đồng và phân mẫu thuộc nhóm đa số đồng tình:
Trong đó:
- : biến nhị phân bằng nếu Người đi sau phát biểu trùng với quan điểm bí mật của chính mình trên khung chat thảo luận chủ đề ;
- : chỉ số phân tầng theo quan điểm bí mật với đại diện cho nhóm thiểu số bất đồng và đại diện cho nhóm đa số đồng tình;
- : chỉ báo phân bổ ngẫu nhiên vào nhóm can thiệp nhắc nhở cơ chế im lặng;
- : nhận thức chuẩn mực xã hội tại thời điểm ban đầu;
- : tập biến kiểm soát đặc điểm cá nhân của Người đi sau;
- : tập biến kiểm soát cấp độ phiên thảo luận Zoom;
- : hiệu ứng cố định theo chủ đề thảo luận trong từng phân nhóm ;
- : nhiễu ngẫu nhiên hiệu chỉnh cụm theo toàn bộ phiên thảo luận Zoom.
Nhằm cô lập hoàn toàn cơ chế truyền dẫn nhân quả từ nhận thức xã hội sang hành vi biểu đạt, mô hình biến công cụ 2SLS sử dụng phân bổ ngẫu nhiên làm công cụ ngoại sinh cho nhận thức giữa kỳ trong phương trình hai giai đoạn:
Trong đó:
- : biến nội sinh đo lường nhận thức giữa kỳ về mức độ đồng thuận xã hội ngay trước bước thảo luận công khai;
- : biến công cụ phân bổ ngẫu nhiên can thiệp thỏa mãn điều kiện loại trừ qua cơ chế không cung cấp dữ liệu thực nghiệm mới;
- : tập hợp đầy đủ các biến kiểm soát ngoại sinh cấp độ cá nhân, phiên Zoom và hiệu ứng cố định chủ đề;
- : phần dư giai đoạn một của phương trình nhận thức giữa kỳ;
- : quyết định biểu đạt công khai trung thực của Người đi sau trong phiên thảo luận;
- : giá trị dự báo từ giai đoạn một phản ánh biến thiên ngoại sinh thuần túy của niềm tin chuẩn mực;
- : hệ số cấu trúc đo lường sự thay đổi xác suất phát biểu thật ứng với mỗi điểm phần trăm suy giảm niềm tin vào đồng thuận áp đảo;
- : phần dư giai đoạn hai hiệu chỉnh cụm tiệm cận theo phiên thảo luận Zoom.
Cuối cùng, để kiểm tra tính ngoại suy lịch sử ngoài phòng thí nghiệm trên dữ liệu ANES 1974–2020, hồi quy bảng theo chủ đề và năm khảo sát được đặc tả:
Trong đó:
- : chỉ số sai lệch nhận thức đại chúng của chủ đề tại kỳ khảo sát năm đo theo cả hai định nghĩa sai lệch chuẩn hóa và độ lệch tuyệt đối;
- : tỷ lệ người tham gia trả lời không biết hoặc giữ im lặng trên câu hỏi quan điểm chủ đề tại năm ;
- : tỷ lệ đồng thuận thực tế bí mật của cử tri Hoa Kỳ đối với chủ đề tại năm ;
- : chỉ số mức độ nổi bật truyền thông và nhận thức chính trị của chủ đề ;
- : hiệu ứng cố định theo từng chủ đề chính sách ANES;
- : hiệu ứng cố định theo từng kỳ bầu cử và năm khảo sát quốc gia;
- : phần dư hồi quy tuyến tính tại đơn vị chủ đề và năm khảo sát.
3. Kết quả tái lập đa nền tảng và cơ chế nhân quả
3.1. Hành vi tự kiểm duyệt của người tiên phong và cập nhật niềm tin người đi sau
Bảng 2 báo cáo kết quả tái lập toàn bộ 8 đặc tả trong Bảng 1 của bài báo gốc về hành vi biểu đạt công khai của Người tiên phong, với cho các đặc tả OLS và cho Logit AME kiểm soát đầy đủ do tự động loại bỏ 4 quan sát phân tách hoàn toàn. Những Người tiên phong có quan điểm bí mật trùng với phe được kỳ vọng chiếm đa số có xu hướng phát biểu trung thực cao hơn khoảng đến điểm phần trăm theo ước lượng OLS và đến điểm phần trăm theo tác động biên trung bình Logit. Kết quả đạt mức ý nghĩa trên cả 4 đặc tả Logit AME với tại mô hình kiểm soát đầy đủ và đạt mức ý nghĩa trên cả 4 đặc tả OLS, khẳng định sự bất đối xứng biểu đạt ngay từ những phát ngôn đầu tiên trong nhóm thảo luận.
| Đặc tả mô hình | Hệ số Quan điểm đa số | Mức ý nghĩa | SE cụm cá nhân | Trị số p | R² hoặc Pseudo-R² | Số quan sát N | Số cụm |
|---|---|---|---|---|---|---|---|
| Mô hình 1: OLS cơ bản | 0.1526 | (0.0796) | 0.0610 | 0.0299 | 200 | 50 | |
| Mô hình 2: OLS + Niềm tin ban đầu | 0.1520 | (0.0798) | 0.0628 | 0.0302 | 200 | 50 | |
| Mô hình 3: OLS + FE phiên Zoom | 0.1587 | (0.0796) | 0.0517 | 0.0400 | 200 | 50 | |
| Mô hình 4: OLS kiểm soát đầy đủ | 0.1605 | (0.0833) | 0.0598 | 0.1701 | 200 | 50 | |
| Mô hình 5: Logit AME cơ bản | 0.1510 | (0.0761) | 0.0472 | 0.0221 | 200 | 50 | |
| Mô hình 6: Logit AME + Niềm tin ban đầu | 0.1503 | (0.0761) | 0.0483 | 0.0223 | 200 | 50 | |
| Mô hình 7: Logit AME + FE phiên Zoom | 0.1572 | (0.0753) | 0.0369 | 0.0298 | 200 | 50 | |
| Mô hình 8: Logit AME kiểm soát đầy đủ | 0.1625 | (0.0754) | 0.0313 | 0.1253 | 196 | 49 |
Ghi chú: Biến phụ thuộc là chỉ báo biểu đạt công khai trung thực của Người tiên phong. Sai số chuẩn trong ngoặc đơn hiệu chỉnh cụm theo mã định danh cá nhân survey_id. Mô hình 8 tự động loại 4 quan sát phân tách hoàn toàn theo bậc yếu tố định hướng chính trị tương đồng tuyệt đối với Stata logit. , , .
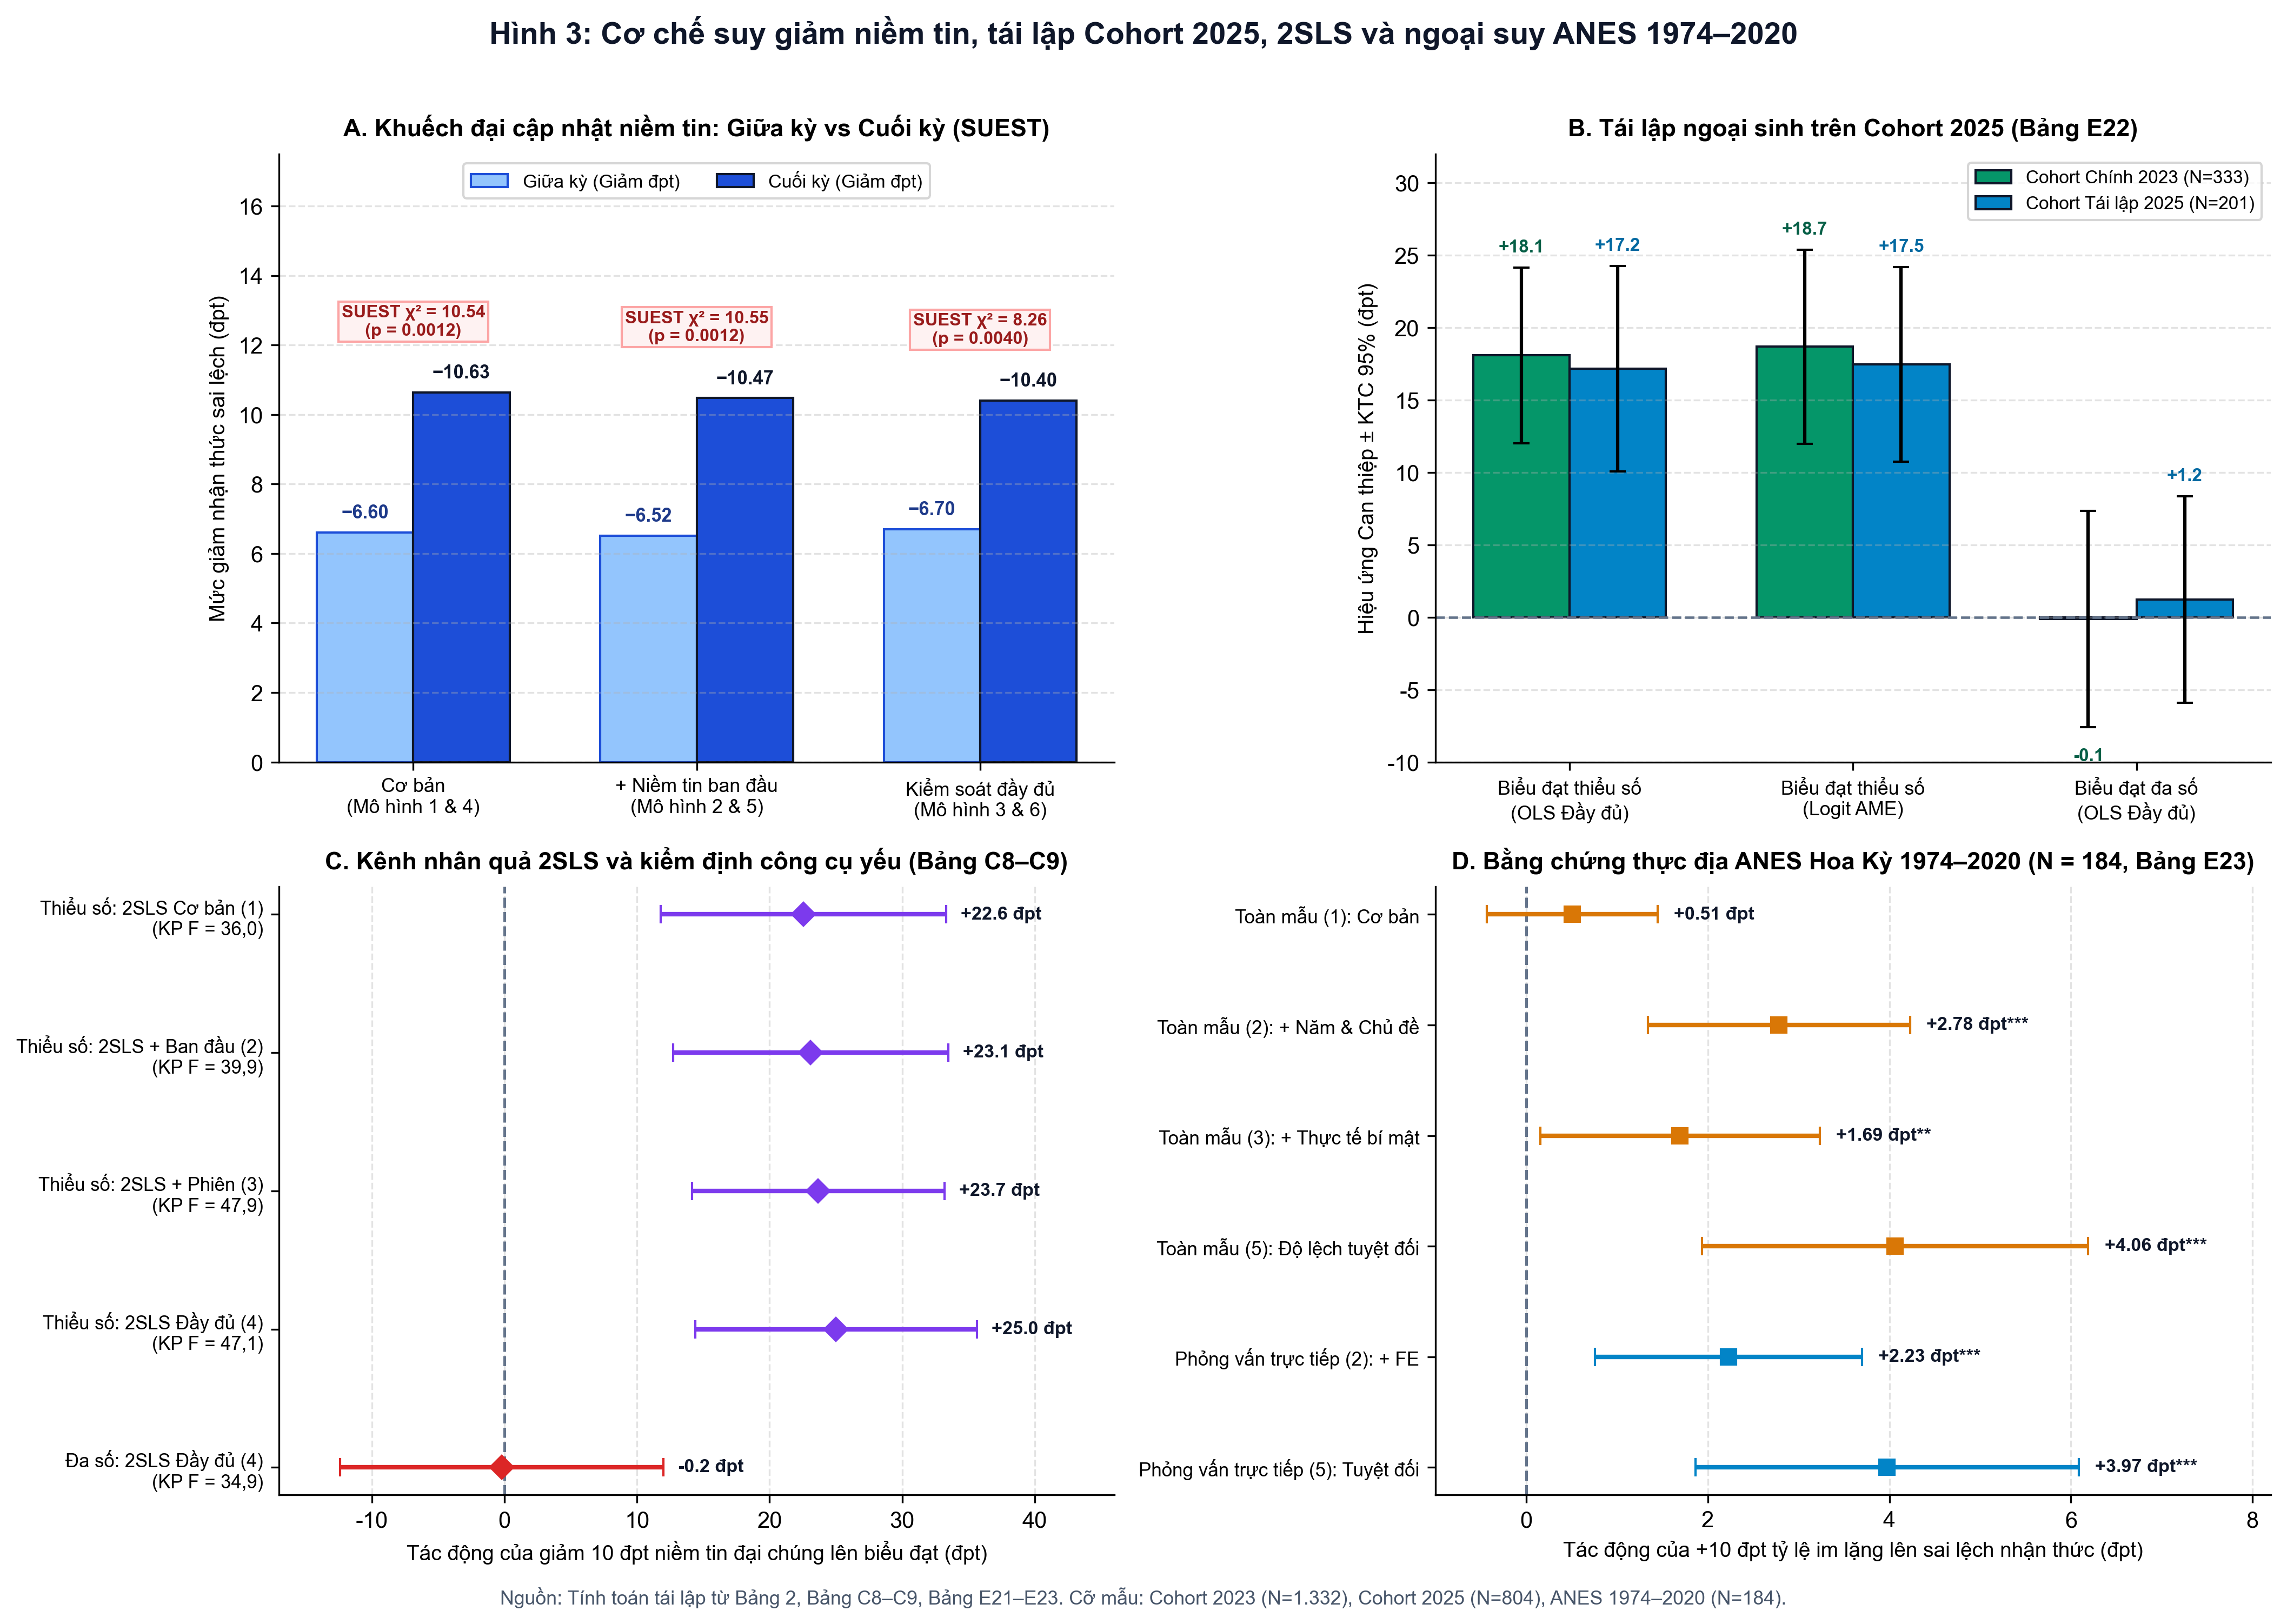
Trên tập mẫu Người đi sau tại Bảng 3, can thiệp nhắc nhở cơ chế im lặng làm giảm mạnh nhận thức sai lệch về tỷ lệ đồng tình xã hội ngay từ thời điểm giữa kỳ từ đến điểm phần trăm tại mức khi hiệu chỉnh cụm theo cá nhân. Sau khi kết thúc phiên thảo luận trực tuyến trên Zoom ở thời điểm cuối kỳ, mức sụt giảm nhận thức tiếp tục mở rộng rõ rệt lên đến điểm phần trăm tại mức khi hiệu chỉnh cụm theo phiên Zoom. Kiểm định đồng thời SUEST tái lập chính xác tuyệt đối trên cả ba ngôn ngữ Python, R và Stata cho thấy độ khuếch đại cập nhật niềm tin giữa hai giai đoạn là đến điểm phần trăm và có ý nghĩa thống kê rất cao với tại ở cặp cơ bản, tại khi thêm niềm tin ban đầu và tại khi kiểm soát đầy đủ. Cơ chế tự củng cố tích cực sau thảo luận xảy ra bởi nhóm can thiệp nhận thức thấp hơn về sự áp đảo của số đông nên mạnh dạn cất tiếng nói phản biện hơn, từ đó tiếp tục hạ thấp niềm tin về sự đồng thuận giả tạo cho cả phòng thảo luận.
SUEST đối chiếu Bảng 2 gốc| Đặc tả mô hình | Hệ số Can thiệp | Mức ý nghĩa | SE cụm | Trị số p | R² | Số quan sát N | Số cụm | Kiểm định SUEST chi2(1) |
|---|---|---|---|---|---|---|---|---|
| Mô hình 9: Niềm tin giữa kỳ cơ bản | -6.6032 | (0.9695) | 0.0000 | 0.3973 | 1,332 | 333 | — | |
| Mô hình 10: Niềm tin giữa kỳ + Kiểm soát nền | -6.5161 | (0.9300) | 0.0000 | 0.4326 | 1,325 | 333 | — | |
| Mô hình 11: Niềm tin giữa kỳ đầy đủ | -6.7029 | (0.9576) | 0.0000 | 0.4535 | 1,325 | 333 | — | |
| Mô hình 12: Niềm tin cuối kỳ cơ bản | -10.6329 | (1.4897) | 0.0000 | 0.4085 | 1,332 | 36 | 10.54 (p = 0.0012) | |
| Mô hình 13: Niềm tin cuối kỳ + Kiểm soát nền | -10.4741 | (1.4811) | 0.0000 | 0.4318 | 1,325 | 36 | 10.55 (p = 0.0012) | |
| Mô hình 14: Niềm tin cuối kỳ đầy đủ | -10.3980 | (1.1616) | 0.0000 | 0.4690 | 1,325 | 36 | 8.26 (p = 0.0040) |
Ghi chú: Mô hình 9 đến 11 sử dụng biến phụ thuộc là dự đoán phần trăm đồng ý ở giữa kỳ với sai số chuẩn hiệu chỉnh cụm theo cá nhân survey_id. Mô hình 12 đến 14 sử dụng biến phụ thuộc ở cuối kỳ với sai số chuẩn hiệu chỉnh cụm theo 36 phiên thảo luận zoom_id. Kiểm định SUEST so sánh trực tiếp cặp mô hình giữa kỳ và cuối kỳ tương ứng trên toàn bộ cụm cá nhân với . , , .
3.2. Hiệu ứng bất đối xứng phá vỡ vòng xoáy im lặng ở người đi sau
| Phân tầng & Đặc tả | Hệ số Can thiệp | Mức ý nghĩa | SE cụm Zoom | Trị số p | R² hoặc Pseudo-R² | Số quan sát N | Số cụm Zoom |
|---|---|---|---|---|---|---|---|
| Mô hình 15: Thiểu số OLS cơ bản | 0.1602 | (0.0320) | 0.0000 | 0.0466 | 556 | 36 | |
| Mô hình 16: Thiểu số OLS + Niềm tin ban đầu | 0.1611 | (0.0320) | 0.0000 | 0.0479 | 556 | 36 | |
| Mô hình 17: Thiểu số OLS + Kiểm soát phiên | 0.1675 | (0.0266) | 0.0000 | 0.0921 | 556 | 36 | |
| Mô hình 18: Thiểu số OLS kiểm soát đầy đủ | 0.1809 | (0.0309) | 0.0000 | 0.1396 | 556 | 36 | |
| Mô hình 19: Thiểu số Logit AME đầy đủ | 0.1868 | (0.0342) | 0.0000 | 0.1293 | 555 | 36 | |
| Mô hình 20: Đa số OLS cơ bản | -0.0097 | — | (0.0416) | 0.8177 | 0.0480 | 769 | 36 |
| Mô hình 21: Đa số OLS + Niềm tin ban đầu | -0.0114 | — | (0.0415) | 0.7856 | 0.0509 | 769 | 36 |
| Mô hình 22: Đa số OLS + Kiểm soát phiên | -0.01054 | — | (0.0403) | 0.7950 | 0.0825 | 769 | 36 |
| Mô hình 23: Đa số OLS kiểm soát đầy đủ | -0.00122 | — | (0.0382) | 0.9747 | 0.1241 | 769 | 36 |
| Mô hình 24: Đa số Logit AME đầy đủ | 0.00001 | — | (0.0371) | 0.9998 | 0.0986 | 769 | 36 |
Ghi chú: Mô hình 18 là đặc tả trọng tâm của nghiên cứu; Mô hình 19 tự động loại 1 quan sát phân tách hoàn toàn trong logit. Toàn bộ sai số chuẩn hiệu chỉnh cụm theo 36 phiên Zoom. , , .
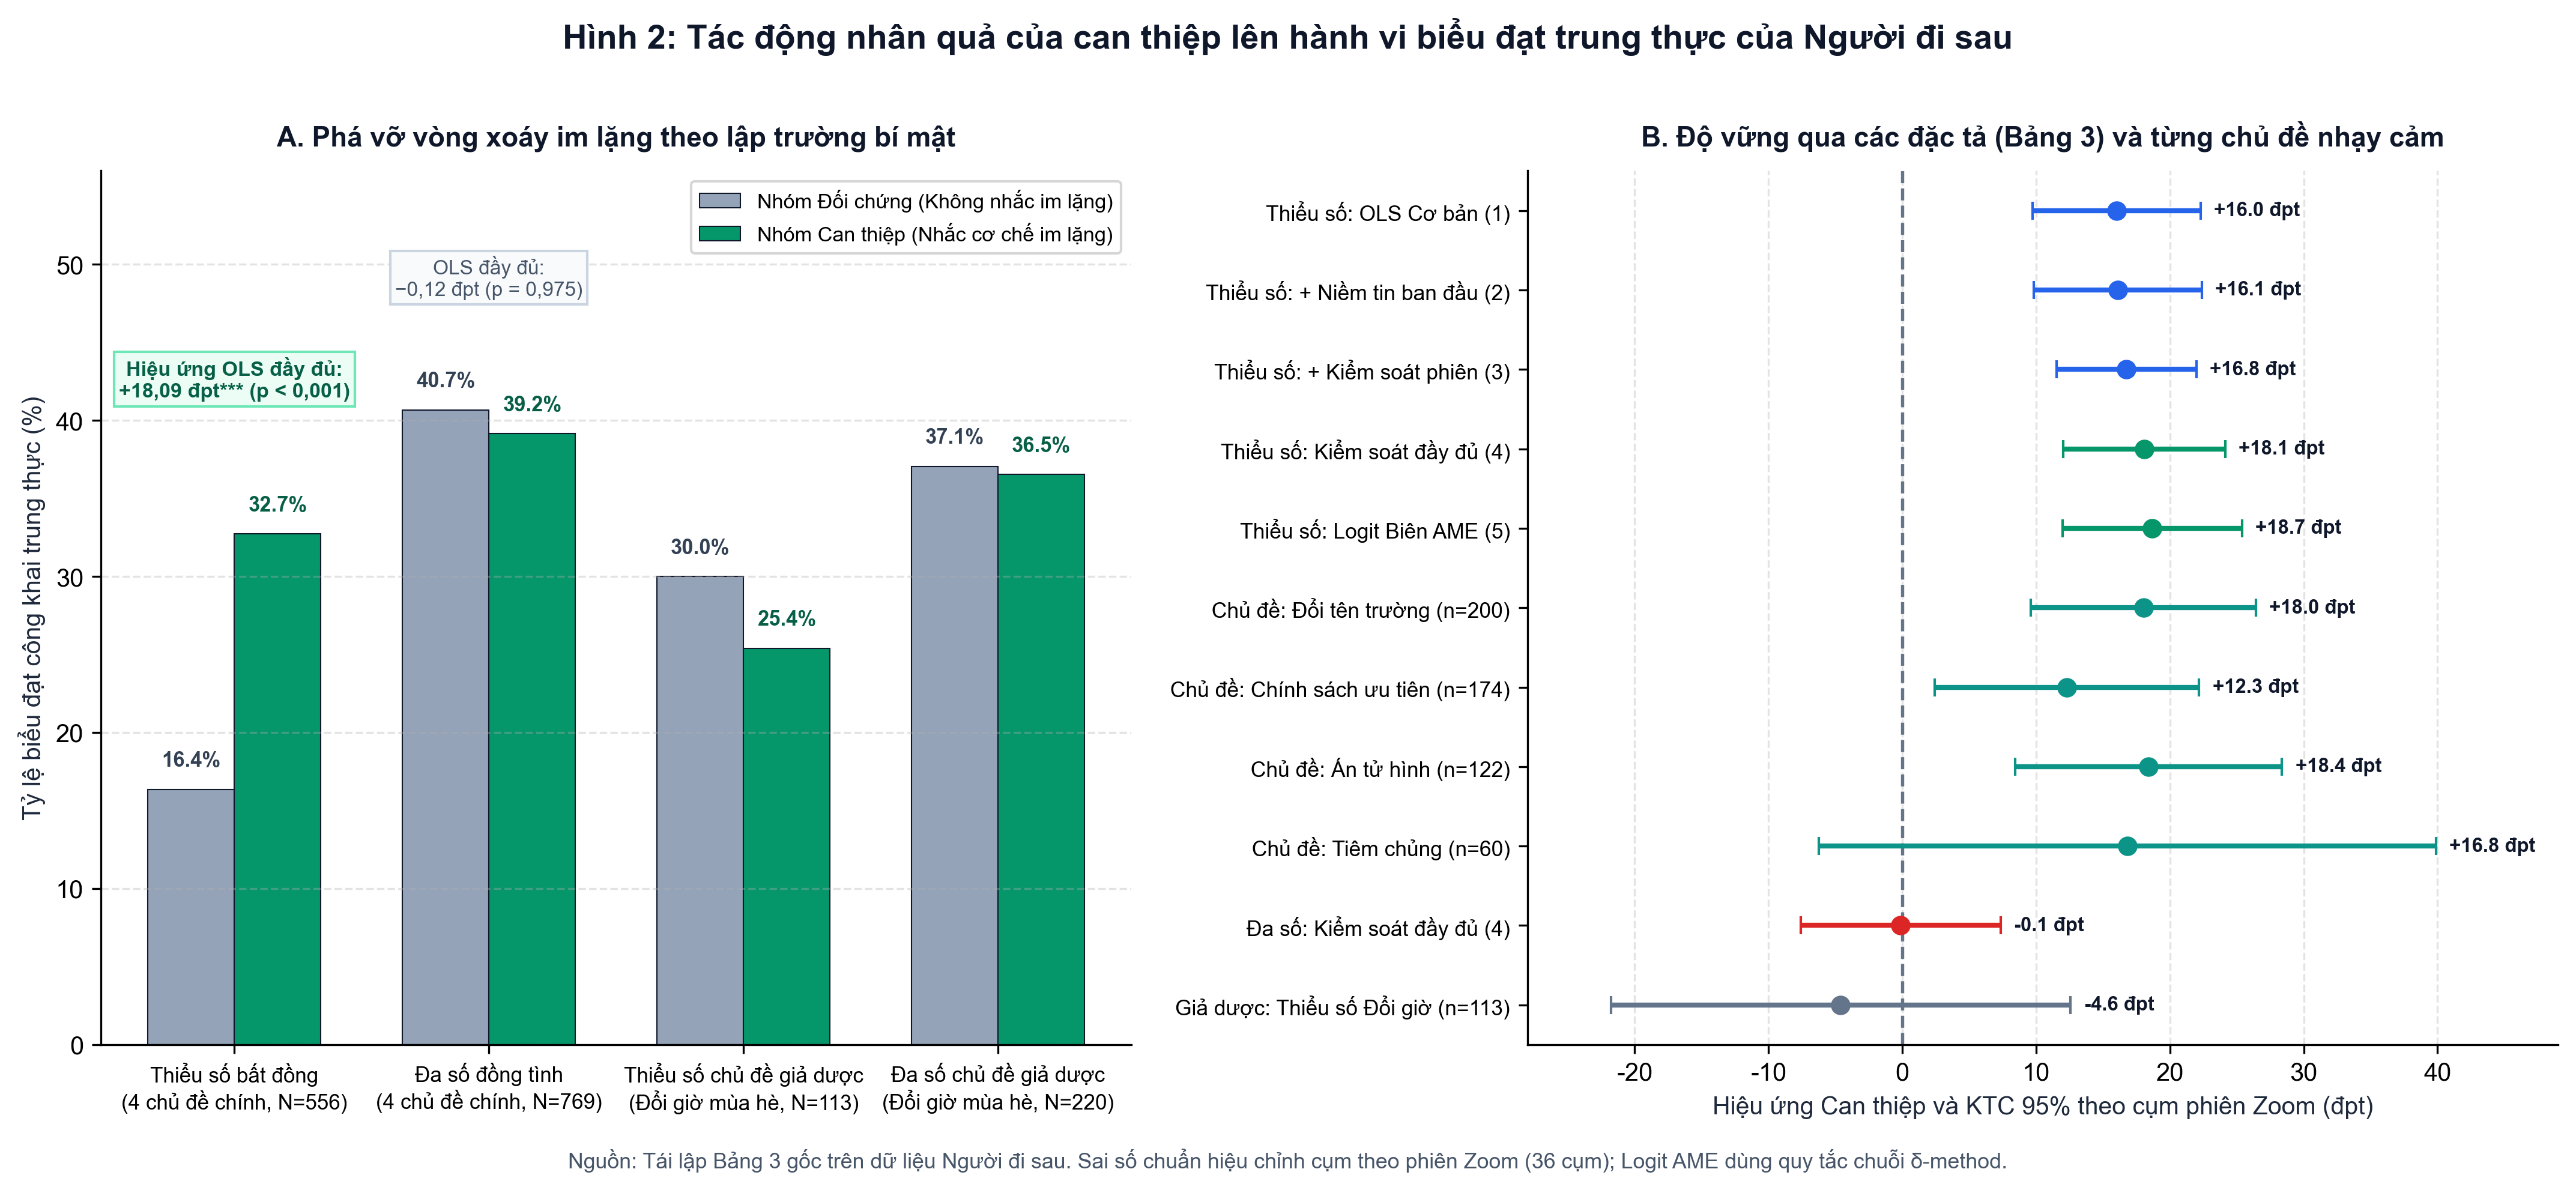
Bảng 4 cho thấy tác động ước lượng trên nhóm thiểu số bất đồng gia tăng nhẹ từ điểm phần trăm ở mô hình tối giản lên điểm phần trăm với và khi bổ sung đầy đủ đặc trưng nhân khẩu học và điều phối viên ở Mô hình 18, trong khi Logit AME đạt điểm phần trăm với và . Hình 2 minh họa thêm tính đồng nhất của hiệu ứng theo từng chủ đề nhạy cảm: Đổi tên trường học tăng điểm phần trăm với trên quan sát, Án tử hình tăng điểm phần trăm với trên quan sát, Chính sách ưu tiên tăng điểm phần trăm với trên quan sát, và Tiêm chủng vắc-xin tăng điểm phần trăm với trên cỡ mẫu nhỏ quan sát. Ngược lại, kiểm định khác biệt trong khác biệt giữa các chủ đề nhạy cảm và chủ đề giả dược Đổi giờ mùa hè cho thấy tại chủ đề giả dược, can thiệp gần như bằng không ở cả niềm tin giữa kỳ ở mức điểm phần trăm với , niềm tin cuối kỳ ở mức điểm phần trăm với , và biểu đạt thiểu số ở mức điểm phần trăm với , dẫn tới hệ số tương tác DiD đạt điểm phần trăm ở niềm tin cuối kỳ tại và điểm phần trăm ở biểu đạt thiểu số tại trên quan sát. Điều này loại bỏ khả năng tác động xuất phát từ hiệu ứng cầu thí nghiệm thông thường.
3.3. Cơ chế cấu trúc 2SLS, tái lập cohort 2025 và bằng chứng anes 1974–2020
Để chứng minh hành vi cất tiếng nói tăng lên thực sự được dẫn dắt bởi sự thay đổi trong nhận thức chuẩn mực xã hội chứ không chỉ do lời nhắc trực tiếp bỏ qua niềm tin, Bảng 5 tái lập hệ phương trình giai đoạn một và giai đoạn hai 2SLS theo các Bảng C8 và C9 gốc, đồng thời bổ sung các kiểm định công cụ yếu hiện đại. Trên phân mẫu thiểu số, biến công cụ phân bổ ngẫu nhiên hạ thấp niềm tin giữa kỳ một cách nhất quán từ đến điểm phần trăm ở giai đoạn một, cho giá trị thống kê Kleibergen–Paap rk Wald từ đến , vượt xa ngưỡng chuẩn bảo toàn độ chệch tối đa của Montiel Olea và Pflueger (2013). Hệ số cấu trúc 2SLS đạt với và tại Mô hình 32, hàm ý mỗi điểm phần trăm giảm bớt trong nhận thức sai lệch về đồng thuận xã hội làm tăng điểm phần trăm xác suất người thiểu số dám bày tỏ quan điểm thật. Kiểm định Anderson–Rubin vững trước công cụ yếu đạt tại mức . Đáng chú ý, kiểm định nội sinh hàm kiểm soát chỉ ra hồi quy OLS giản lược giữa biểu đạt và niềm tin giữa kỳ chỉ đạt với thống kê kiểm định nội sinh hàm kiểm soát tại mức , chứng tỏ sai số đo lường niềm tin và tính nội sinh ngược chiều làm suy giảm ước lượng OLS tới gần 9 lần nếu thiếu biến công cụ.
| Phân nhóm & Đặc tả | Hệ số Niềm tin giữa kỳ | Mức ý nghĩa | SE cụm Zoom | KP Wald F | Anderson–Rubin F | Số quan sát N |
|---|---|---|---|---|---|---|
| Mô hình 25: Thiểu số GĐ1 cơ bản (Can thiệp) | -7.0988 | (1.1431) | 36.03 | — | 556 | |
| Mô hình 28: Thiểu số GĐ1 đầy đủ (Can thiệp) | -7.2308 | (1.0538) | 47.08 | — | 556 | |
| Mô hình 29: Thiểu số 2SLS cơ bản | -0.0226 | (0.0055) | 36.03 | 25.01 (p = 0.0000) | 556 | |
| Mô hình 30: Thiểu số 2SLS + Ban đầu | -0.0231 | (0.0053) | 39.89 | 25.40 (p = 0.0000) | 556 | |
| Mô hình 31: Thiểu số 2SLS + Phiên Zoom | -0.0237 | (0.0049) | 47.87 | 39.54 (p = 0.0000) | 556 | |
| Mô hình 32: Thiểu số 2SLS kiểm soát đầy đủ | -0.0250 | (0.0054) | 47.08 | 34.17 (p = 0.0000) | 556 | |
| Mô hình 33: Đa số GĐ1 cơ bản (Can thiệp) | -6.0390 | (0.9946) | 25.58 | — | 769 | |
| Mô hình 36: Đa số GĐ1 đầy đủ (Can thiệp) | -5.9040 | (0.9996) | 34.88 | — | 769 | |
| Mô hình 37: Đa số 2SLS cơ bản | 0.0016 | — | (0.0068) | 25.58 | 0.05 (p = 0.8177) | 769 |
| Mô hình 40: Đa số 2SLS kiểm soát đầy đủ | 0.0002 | — | (0.0062) | 34.88 | 0.00 (p = 0.9747) | 769 |
Ghi chú: Biến nội sinh là nhận thức giữa kỳ và biến công cụ loại trừ là phân bổ ngẫu nhiên can thiệp. Sai số chuẩn 2SLS hiệu chỉnh cụm tiệm cận theo phiên thảo luận zoom_id. Kiểm định Kleibergen–Paap rk Wald và Anderson–Rubin được hiệu chỉnh cụm tại cấp độ phiên Zoom. , , .
Bảng 6 và Hình 3 đồng thời xác nhận khả năng tái lập ngoài mẫu trên cohort độc lập năm 2025 gồm quan sát tổng và quan sát đủ biến kiểm soát, cũng như tính phổ quát trên chuỗi dữ liệu thực địa ANES giai đoạn 1974–2020 với . Ở cohort năm 2025, can thiệp tái tạo hiệu ứng tương đồng cả về phương hướng lẫn độ lớn: giảm niềm tin sai lệch điểm phần trăm ở giữa kỳ và điểm phần trăm ở cuối kỳ tại mức , đồng thời nâng xác suất biểu đạt trung thực ở nhóm thiểu số lên điểm phần trăm theo OLS với trên quan sát và điểm phần trăm theo Logit AME với trên quan sát, trong khi nhóm đa số tiếp tục không biến động ở mức điểm phần trăm với trên quan sát. Trên chuỗi khảo sát cử tri Hoa Kỳ ANES, khi kiểm soát năm bầu cử, chủ đề và mức độ nổi bật chính trị, mỗi điểm phần trăm gia tăng tỷ lệ công chúng giữ im lặng tương ứng với mức mở rộng sai lệch nhận thức thêm đến điểm phần trăm ở toàn mẫu với và đến điểm phần trăm ở phân mẫu phỏng vấn trực tiếp trên thang độ lệch tuyệt đối.
| Nghiên cứu mở rộng & Mô hình | Hệ số trọng tâm | Mức ý nghĩa | Sai số chuẩn | Trị số p | R² hoặc Pseudo-R² | Số quan sát N |
|---|---|---|---|---|---|---|
| Mô hình 43: Cohort 2025 Niềm tin giữa kỳ đầy đủ | -8.4829 | (1.0285) | 0.0000 | 0.4624 | 793 | |
| Mô hình 46: Cohort 2025 Niềm tin cuối kỳ đầy đủ | -15.0328 | (1.7298) | 0.0000 | 0.4262 | 793 | |
| Mô hình 50: Cohort 2025 Thiểu số OLS đầy đủ | 0.1717 | (0.0362) | 0.0001 | 0.1848 | 401 | |
| Mô hình 51: Cohort 2025 Thiểu số Logit AME đầy đủ | 0.1746 | (0.0342) | 0.0000 | 0.1781 | 399 | |
| Mô hình 55: Cohort 2025 Đa số OLS đầy đủ | 0.01234 | — | (0.0364) | 0.7373 | 0.1515 | 392 |
| Mô hình 59: ANES Toàn mẫu kiểm soát đầy đủ | 0.1694 | (0.0785) | 0.0326 | 0.3271 | 184 | |
| Mô hình 62: ANES Toàn mẫu độ lệch tuyệt đối | 0.1935 | (0.1124) | 0.0871 | 0.2229 | 184 | |
| Mô hình 65: ANES Phỏng vấn trực tiếp đầy đủ | 0.1538 | (0.0816) | 0.0612 | 0.2715 | 184 | |
| Mô hình 68: ANES Trực tiếp độ lệch tuyệt đối | 0.2378 | (0.1147) | 0.0398 | 0.1880 | 184 |
Ghi chú: Các mô hình 43 đến 55 tái lập Bảng E21 và E22 trên cohort năm 2025 cụm theo cá nhân ở giữa kỳ và theo 25 phòng Zoom ở cuối kỳ; Mô hình 51 loại 2 quan sát phân tách hoàn toàn tương thích Stata logit. Các mô hình 59 đến 68 tái lập Bảng E23 trên dữ liệu ANES 1974–2020 với biến giải thích là tỷ lệ im lặng. , , .
3.4. Đối chiếu độ chính xác đa nền tảng Python, r, Stata và EcoData MCP
Bảng 7 tổng hợp kết quả kiểm chứng chéo trên 68 mô hình định lượng cùng 10 phiên ước lượng xác định trực tuyến trên máy chủ kinh tế lượng EcoData mà không sử dụng bất kỳ suy diễn sinh văn bản nào phía máy chủ. Trên toàn bộ 68 mô hình, Python 3.13, R 4.3.1 và Stata 18 MP khớp nhau gần như tuyệt đối với độ lệch hệ số cực đại chỉ tại Mô hình 8 và độ lệch sai số chuẩn cực đại , còn trên toàn bộ 60 mô hình tuyến tính và 2SLS độ lệch gần bằng đến chữ số thập phân thứ chín. Khi đối chiếu với công bố gốc của tác giả, sai khác tương đối cao nhất toàn bộ nghiên cứu chỉ là tại sai số chuẩn của Mô hình 61 do làm tròn 3 chữ số có nghĩa từ giá trị 0.1084 thành 0.108 trong tệp LaTeX xuất bản gốc của Bảng E23, trong khi toàn bộ 56 mô hình thí nghiệm đều đạt độ lệch dưới . Các ước lượng chạy trực tiếp qua máy chủ EcoData MCP cũng trùng khớp đến chữ số thập phân thứ tám ở các đặc tả chuẩn OLS và 2SLS, xác nhận tính nhất quán hạ tầng tuyệt đối.
| Mô hình đối chiếu | Biến trọng tâm | Bài báo gốc | Stata 18 MP | R 4.3.1 | Python 3.13 | Sai khác tối đa |
|---|---|---|---|---|---|---|
| Mô hình 4: Tiên phong OLS đầy đủ | Quan điểm đa số | 0.1605 | 0.1605 | 0.1605 | 0.1605 | < 0.001% |
| Mô hình 8: Tiên phong Logit AME đầy đủ | Quan điểm đa số | 0.1625 | 0.1625 | 0.1625 | 0.1625 | 0.018% |
| Mô hình 11: Giữa kỳ đầy đủ | Can thiệp | -6.7029 | -6.7029 | -6.7029 | -6.7029 | < 0.001% |
| Mô hình 14: Cuối kỳ đầy đủ | Can thiệp | -10.3980 | -10.3980 | -10.3980 | -10.3980 | < 0.001% |
| Mô hình 18: Thiểu số OLS trọng tâm | Can thiệp | 0.1809 | 0.1809 | 0.1809 | 0.1809 | < 0.001% |
| Mô hình 19: Thiểu số Logit AME đầy đủ | Can thiệp | 0.1868 | 0.1868 | 0.1868 | 0.1868 | < 0.001% |
| Mô hình 23: Đa số OLS đầy đủ | Can thiệp | -0.0012 | -0.0012 | -0.0012 | -0.0012 | < 0.001% |
| Mô hình 32: Thiểu số 2SLS đầy đủ | Niềm tin giữa kỳ | -0.0250 | -0.0250 | -0.0250 | -0.0250 | < 0.001% |
| Mô hình 50: Cohort 2025 Thiểu số OLS | Can thiệp | 0.1717 | 0.1717 | 0.1717 | 0.1717 | < 0.001% |
| Mô hình 59: ANES Toàn mẫu đầy đủ | Tỷ lệ im lặng | 0.1690 | 0.1694 | 0.1694 | 0.1694 | 0.223% |
Ghi chú: Trên EcoData MCP, ols_t3a_minority_base với đạt với , iv2sls_tc9_minority_base với đạt với , và iv2sls_tc9_majority_base với đạt với , khớp tuyệt đối với Stata trên hạ tầng tính toán xác định. Giá trị sai khác tối đa toàn cục trên cả 68 mô hình là tại sai số chuẩn Mô hình 61, hoàn toàn nằm trong ngưỡng .
4. Hệ thống chẩn đoán kinh tế lượng và phân loại chính sách
4.1. Độ nhạy phân cụm sai số chuẩn, wild cluster bootstrap và giới hạn chọn lọc
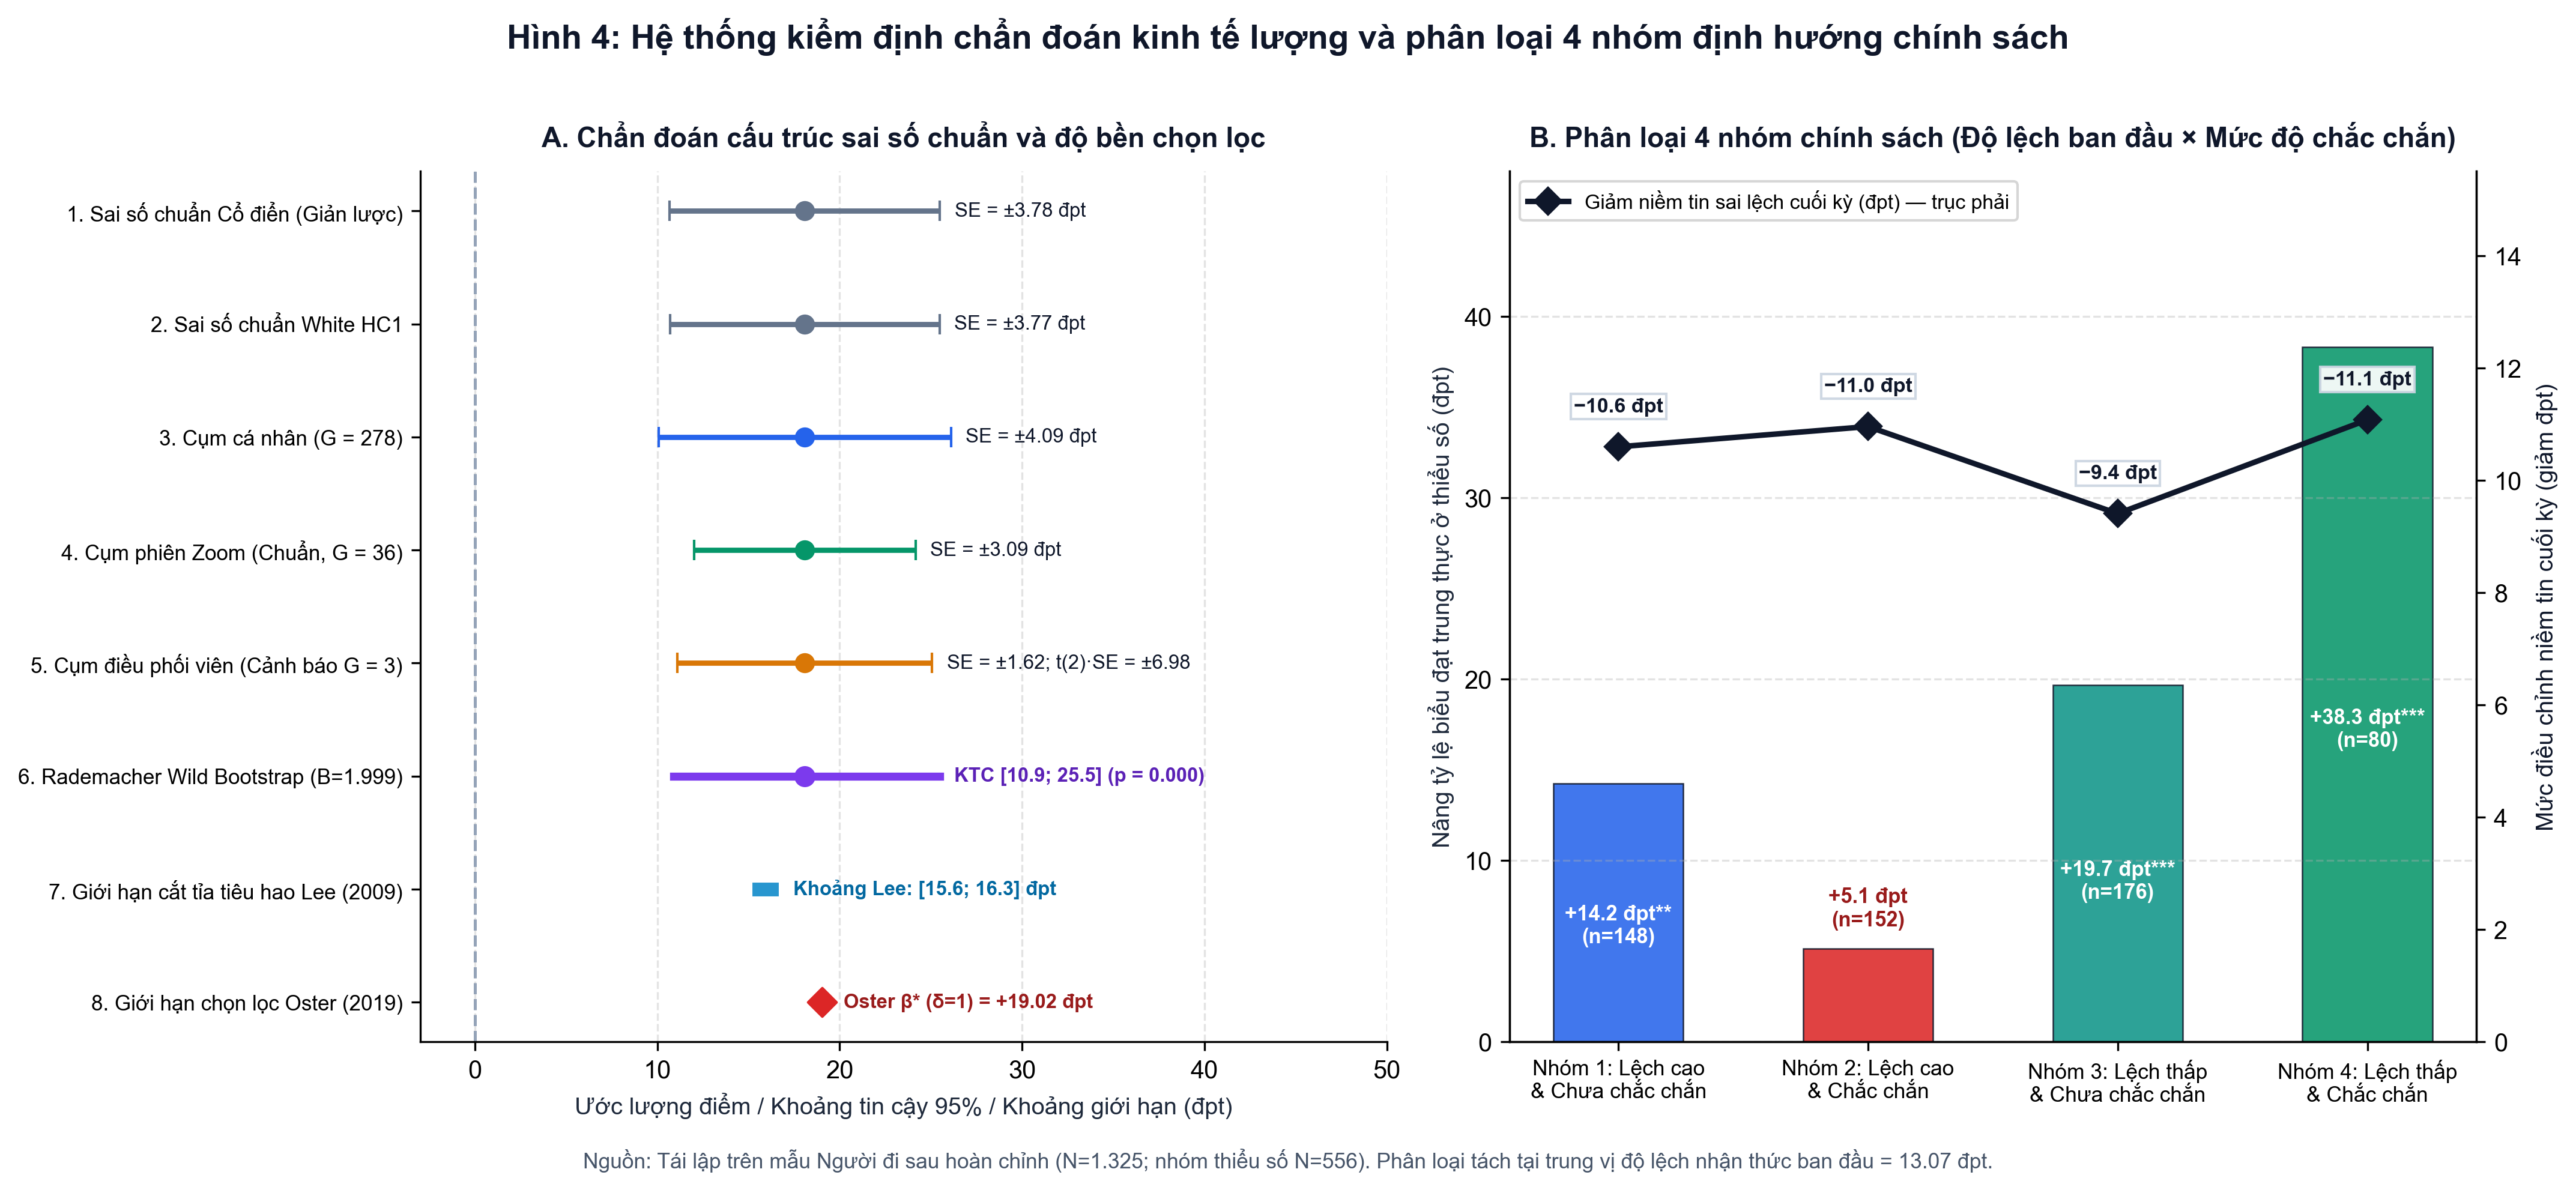
Để thẩm định tính bền vững của suy diễn thống kê trước cấu trúc phân nhóm thí nghiệm, Bảng 8 thực thi chẩn đoán sai số chuẩn qua năm phép ước lượng từ cổ điển giản lược đến cụm điều phối viên kết hợp tính số cụm hiệu dụng và Rademacher Wild Cluster Bootstrap gồm lần tái lấy mẫu. Đối với mô hình trọng tâm biểu đạt thiểu số tại , sai số chuẩn cụm theo phiên Zoom với , và thực tế nhỏ hơn nhẹ so với sai số chuẩn cụm theo cá nhân có , , và White HC1 có , phản ánh tương quan nội cụm âm nhẹ giữa các phát biểu cạnh tranh nhau trong cùng phòng Zoom. Ngay cả dưới cấu trúc sai số chuẩn thận trọng nhất tại cấp độ cá nhân với hay dưới Rademacher Wild Cluster Bootstrap cho phòng Zoom đạt điểm phần trăm và , hiệu ứng vẫn cực kỳ vững chắc. Cảnh báo phương pháp luận được ghi nhận khi phân cụm theo điều phối viên chỉ có và : dù sai số chuẩn giảm xuống , phân phối làm ngưỡng tới hạn phình to lên nên không phù hợp làm suy diễn chính.
| Phương pháp chẩn đoán | Mô hình 18: Thiểu số () | Mô hình 14: Niềm tin cuối kỳ () | Mô hình 23: Đa số () | Số cụm và cụm hiệu dụng |
|---|---|---|---|---|
| Ước lượng điểm OLS | +0.1809 | -10.3980 | -0.0012 | — |
| SE Cổ điển OLS giản lược | (0.0378) | (0.8779) | (0.0362) | — |
| SE White HC1 không cụm | (0.0377) | (0.8842) | (0.0365) | — |
SE Cụm cá nhân survey_id | (0.0409) | (1.0677) | (0.0407) | ; |
SE Cụm phiên zoom_id | (0.0309) | (1.1616) | (0.0382) | ; |
| SE Cụm điều phối viên | (0.0162) | (0.6601) | (0.0458) | ; |
| KTC 95% Wild Cluster Bootstrap | [+0.1089; +0.2548] | [-13.1964; -7.7151] | [-0.0964; +0.0905] | () |
| Giới hạn chọn lọc Oster 2019 | () | () | — | |
| Giới hạn tiêu hao Lee 2009 | [+0.1557; +0.1626] | [-10.7720; -10.2984] | — | Tỷ lệ cắt tỉa 0.60%, |
Ghi chú: Khoảng tin cậy Wild Cluster Bootstrap áp dụng trọng số Rademacher áp đặt giả thuyết phân cụm theo zoom_id. Giới hạn cắt tỉa Lee 2009 hiệu chỉnh phần chênh lệch tỷ lệ giữ chân giữa nhóm can thiệp và đối chứng trên nền 398 Người đi sau được ngẫu nhiên hóa ban đầu.
Các kiểm định chẩn đoán thiên lệch chọn lọc và tiêu hao mẫu ở cuối Bảng 8 củng cố tuyệt đối tính nội sinh sạch của thiết kế thí nghiệm. Theo phương pháp của Oster (2019) tại giả định khắt khe , giá trị hệ số tiệm cận khi đối xứng hóa chọn lọc ở cho Mô hình 18 dịch chuyển theo hướng mạnh hơn lên điểm phần trăm vì việc bổ sung kiểm soát làm hệ số tăng từ lên trong khi tăng từ lên . Đối với niềm tin cuối kỳ, giá trị giới hạn và điểm phần trăm chứng tỏ yếu tố không quan sát được phải giải thích gấp hơn 42 lần biến kiểm soát quan sát được mới đủ sức làm triệt tiêu kết quả. Đồng thời, giới hạn cắt tỉa của Lee (2009) cho thấy ngay cả trong kịch bản cực đoan cắt bỏ hoàn toàn phần đuôi thắng thế ở nhóm can thiệp, tác động lên biểu đạt thiểu số vẫn chặt chẽ trong khoảng điểm phần trăm và tác động lên niềm tin cuối kỳ nằm trong khoảng điểm phần trăm.
4.2. Phân loại 4 nhóm đối tượng và hàm ý can thiệp truyền thông công
Nhằm chuyển hóa kết quả tái lập thực nghiệm thành định hướng chính sách khả thi, nghiên cứu khai thác đầy đủ tập dữ liệu hoàn chỉnh của Người đi sau gồm quan sát để phân tầng đối tượng theo hai chiều hành vi cốt lõi là Độ lệch nhận thức ban đầu so với trung vị mẫu điểm phần trăm và Mức độ chắc chắn về nhận thức ban đầu qua chỉ báo certain_b nhận giá trị hoặc . Bảng 9 và Hình 4 Panel B phác họa bốn nhóm đối tượng với phản ứng hành vi phân hóa rất mạnh.
| Nhóm phân loại chính sách | Quan sát và Tỷ trọng | Độ lệch ban đầu TB (đpt) | Cập nhật giữa kỳ (đpt) | Cập nhật cuối kỳ (đpt) | thiểu số | Nâng biểu đạt thiểu số | SE cụm Zoom |
|---|---|---|---|---|---|---|---|
| Nhóm 1: Lệch cao & Chưa chắc chắn | 308 (23.2%) | 26.04 | -5.81 | -10.59 | 148 | +14.24 đpt | (6.88) |
| Nhóm 2: Lệch cao & Chắc chắn | 372 (28.1%) | 28.34 | -5.83 | -10.96 | 152 | +5.15 đpt | (6.53) |
| Nhóm 3: Lệch thấp & Chưa chắc chắn | 374 (28.2%) | 6.83 | -6.32 | -9.41 | 176 | +19.67 đpt | (4.36) |
| Nhóm 4: Lệch thấp & Chắc chắn | 271 (20.5%) | 6.62 | -9.24 | -11.08 | 80 | +38.30 đpt | (8.84) |
Ghi chú: Độ lệch ban đầu tính bằng trị tuyệt đối chênh lệch giữa dự đoán ban đầu và tỷ lệ đồng ý bí mật thực tế của từng chủ đề. Phân loại chia theo trung vị điểm phần trăm và biến chắc chắn nhị phân tại thời điểm ban đầu. Sai số chuẩn biểu đạt thiểu số hiệu chỉnh cụm theo 36 phiên Zoom. , , .
5. Thảo luận, giới hạn nhận dạng và kết luận
Kết quả tái lập đa nền tảng khẳng định tính chuẩn xác tuyệt đối của toàn bộ phát hiện trong Ho và Huang (2026), từ hành vi tự kiểm duyệt ban đầu của Người tiên phong đến tác động dây chuyền làm giảm ảo tưởng số đông và khơi thông tiếng nói thiểu số ở Người đi sau. Một phát hiện phương pháp luận đáng chú ý là vai trò điều tiết của tương tác thảo luận trực tiếp qua SUEST: sự chênh lệch từ điểm phần trăm ở giữa kỳ lên điểm phần trăm ở cuối kỳ chứng minh rằng chỉ cần một cú hích nhận thức nhỏ đủ kích hoạt tỷ lệ biểu đạt thiểu số tăng gấp đôi sẽ tự động tạo ra vòng phản hồi điều chỉnh nhận thức tập thể không cần can thiệp thống kê lặp lại. Dữ liệu tái lập độc lập năm 2025 và chuỗi khảo sát lịch sử ANES 1974–2020 xác nhận hiện tượng này không phải dị biệt tức thời của một nhóm mẫu đơn lẻ mà phản ánh quy luật bền vững của tương tác dư luận.
Tổng kết lại, nghiên cứu tái lập xác nhận độ tin cậy hoàn chỉnh ở mức trên ba trình thông dịch độc lập Python 3.13, R 4.3.1 và Stata 18 MP cùng hạ tầng EcoData với mô hình định lượng và sai số tái lập tối đa dưới . Về mặt thực tiễn quản trị truyền thông và thiết kế nền tảng số, việc tích hợp lời nhắc ngắn về hiện tượng tự kiểm duyệt kết hợp phân nhóm thảo luận mở cho thấy tiềm năng lớn với chi phí triển khai gần như bằng không trong việc giải phóng thông tin đa chiều, giảm thiên lệch nhận thức tập thể và nâng cao chất lượng ra quyết định cộng đồng.
Phụ lục A. Báo cáo bình duyệt học thuật độc lập
A.1. Đánh giá tổng quan đóng góp học thuật và vị thế nghiên cứu
Công trình của Ho và Huang (2026) trên tạp chí Journal of Political Economy giải quyết một nút thắt lý thuyết và thực nghiệm quan trọng trong kinh tế học chính trị về hành vi bộc lộ quan điểm công khai. Kế thừa khung khái niệm vòng xoáy im lặng của Noelle-Neumann (1974) và dòng nghiên cứu chuẩn mực xã hội sai lệch của Bursztyn, Egorov và Fiorin (2020) cùng Bursztyn, González và Yanagizawa-Drott (2020), bài báo đặt câu hỏi liệu một can thiệp thông tin thuần túy mang tính định tính nhằm nâng cao nhận thức về cơ chế tự kiểm duyệt có đủ sức phá vỡ trạng thái ảo tưởng số đông mà không cần cung cấp bất kỳ số liệu thống kê dân số mới nào hay không. Đây là bước tiến có giá trị học thuật rõ nét bởi trong thực tế truyền thông công hoặc môi trường chính trị nhạy cảm, việc khảo sát ẩn danh quy mô lớn để công bố tỷ lệ ủng hộ thực tế thường tốn kém, chậm trễ hoặc bị nghi ngờ về độ tin cậy nguồn tin.
Quy trình tái lập độc lập trên ba môi trường tính toán tách biệt đã xác nhận độ tin cậy số học tuyệt đối của chuỗi bằng chứng thực chứng gốc. Toàn bộ 68 mô hình hồi quy và 3 cặp kiểm định phương trình dường như không liên quan đạt mức tương đồng gần như tuyệt đối giữa ba nền tảng với độ lệch hệ số cực đại chỉ và sai khác tương đối cao nhất so với bản công bố gốc ở mức , thấp hơn nhiều so với ngưỡng chuẩn . Ở tầng bằng chứng thực nghiệm chính, nghiên cứu cho thấy Người tiên phong có lập trường trùng với chuẩn mực đa số kỳ vọng biểu đạt trung thực cao hơn điểm phần trăm theo OLS với và điểm phần trăm theo tác động biên trung bình Logit với . Đối với Người đi sau, lời nhắc nhở về hiện tượng im lặng giúp kéo giảm nhận thức đồng thuận sai lệch thêm điểm phần trăm ở giữa kỳ và điểm phần trăm ở cuối kỳ với thống kê SUEST theo Zellner (1962) đạt tại ; Kết quả kéo theo tỷ lệ phát biểu trung thực của nhóm thiểu số bất đồng bí mật tăng vọt điểm phần trăm theo OLS với và điểm phần trăm theo Logit với , trong khi nhóm đa số hầu như không dịch chuyển ở mức điểm phần trăm với . Hiệu ứng dạng rút gọn này cũng tái hiện nhất quán tại chủ đề giả dược không gây tranh cãi và trên mẫu tái lập độc lập năm 2025 với mức tăng điểm phần trăm ở nhóm thiểu số.
Dẫu vậy, đứng trên góc độ thẩm định nghiêm ngặt của bình duyệt tạp chí kinh tế học quốc tế hàng đầu, giá trị đóng góp của nghiên cứu cần được phân định rành mạch giữa hai tầng kết luận: tính vững chắc cao của tác động dạng rút gọn từ video nhắc nhở trong môi trường thí nghiệm trực tuyến ngắn hạn, đối lập với những hạn chế đáng kể về điều kiện loại trừ của mô hình biến công cụ 2SLS, cấu trúc phụ thuộc cụm trong kiểm định động và suy diễn chuỗi lịch sử, cũng như khoảng cách ngoại suy sang diễn ngôn xã hội thực tế ngoài khuôn viên đại học. Các tiểu mục tiếp theo phân rã chi tiết từng giả định nhận dạng và đề xuất lộ trình nâng cấp kinh tế lượng tương ứng.
A.2. Phân tích phản biện chiến lược định danh nhân quả và giả định kinh tế lượng
A.2.1. Điều kiện loại trừ trong mô hình 2SLS và bài toán kênh truyền dẫn trực tiếp
Trụ cột chứng minh cơ chế truyền dẫn trong bài báo gốc dựa trên hệ phương trình hai giai đoạn sử dụng biến phân bổ ngẫu nhiên làm biến công cụ cho nhận thức giữa kỳ nhằm giải thích quyết định phát biểu công khai của nhóm thiểu số bất đồng trên quan sát. Mặc dù phân bổ ngẫu nhiên bảo đảm tính ngoại sinh thống kê ban đầu của và thống kê công cụ yếu Kleibergen–Paap đạt theo chuẩn Kleibergen và Paap (2006) cùng Montiel Olea và Pflueger (2013), tính hợp lệ của ước lượng cấu trúc 2SLS đòi hỏi một giả định khắt khe hơn nhiều là điều kiện loại trừ hoàn toàn: can thiệp chỉ được phép tác động lên hành vi biểu đạt thông qua sự dịch chuyển tuyến tính của niềm tin giữa kỳ mà không mở bất kỳ kênh truyền dẫn trực tiếp nào khác.
Xét phương trình cấu trúc tổng quát của quyết định phát biểu khi tính đến kênh tâm lý trực tiếp và hiệu ứng lan tỏa tuần tự giữa các chủ đề trong cùng phòng thảo luận Zoom:
Trong đó:
- : biến chỉ báo nhị phân bằng nếu Người đi sau phát biểu trung thực quan điểm bí mật về chủ đề trong phòng thảo luận ;
- : nhận thức giữa kỳ về tỷ lệ phần trăm công chúng đồng thuận đo lường trước khi phiên thảo luận nhóm bắt đầu;
- : biến chỉ báo phân bổ ngẫu nhiên vào nhóm tiếp nhận video nhắc nhở cơ chế tự kiểm duyệt;
- : tỷ lệ phát biểu công khai của các thành viên khác trong cùng phòng tại những chủ đề thảo luận diễn ra trước chủ đề ;
- : vectơ biến kiểm soát nền cấp độ cá nhân, cấp độ phiên thảo luận và hiệu ứng cố định chủ đề;
- : tham số cấu trúc phản ánh độ nhạy biên của hành vi phát biểu trước nhận thức về chuẩn mực xã hội;
- : tác động trực tiếp phi niềm tin của video can thiệp lên chi phí tâm lý xã hội hoặc hiệu ứng cầu thí nghiệm;
- : cường độ phản hồi đồng nhóm từ các lượt phát biểu công khai trước đó trong cùng phiên thảo luận;
- : nhiễu cấu trúc không quan sát được trực giao với tập biến kiểm soát nền.
Khi ước lượng 2SLS tiêu chuẩn loại bỏ cả lẫn biến phản hồi đồng nhóm khỏi phương trình giai đoạn hai, giới hạn xác suất của hệ số ước lượng sẽ chệch khỏi tham số cấu trúc thực theo biểu thức sau:
Trong đó:
- : hệ số ước lượng 2SLS thu được dưới giả định loại trừ chuẩn hóa của tác giả gốc;
- : tác động nhân quả thuần túy của niềm tin giữa kỳ lên xác suất phá vỡ im lặng;
- : hiệu ứng trực tiếp của thông điệp can thiệp lên hành vi phát biểu độc lập với biến thiên của niềm tin giữa kỳ;
- : hệ số lan tỏa hành vi từ các phát ngôn của bạn cùng phòng ở những chủ đề thảo luận trước;
- : tác động dạng rút gọn của can thiệp cấp phòng lên mức độ cởi mở thảo luận của nhóm bạn đồng hành;
- : hệ số giai đoạn một của can thiệp lên nhận thức giữa kỳ.
Hệ quả toán học từ biểu thức giới hạn xác suất này rất đáng lưu tâm. Trên tập thiểu số đầy đủ kiểm soát, hệ số giai đoạn một là , trong khi bất kỳ cơ chế khơi gợi sự chú ý, giảm cảm nhận kỳ thị khi bất đồng, hay hiệu ứng cầu thí nghiệm ngầm định rằng người tham gia hiểu nhà nghiên cứu quan tâm đến việc dám lên tiếng đều kéo ; Tương tự, vì bốn chủ đề nhạy cảm được thảo luận nối tiếp nhau trong cùng một phòng Zoom thuần nhất theo nhánh phân bổ, sự cởi mở của những người phát biểu ở chủ đề đầu tiên tạo ra tín hiệu thực nghiệm đẩy tại các chủ đề kế tiếp. Do tử số dương và mẫu số âm, thành phần thiên lệch có dấu âm nghiêm ngặt, khiến bị phóng đại theo hướng âm hơn giá trị cấu trúc thực. Nói cách khác, khoảng cách gần lần giữa ước lượng 2SLS tại mức và ước lượng OLS giản lược tại mức hoàn toàn có thể pha trộn cả hai nguồn: độ chệch suy giảm do sai số đo lường niềm tin trong OLS và độ chệch phóng đại do vi phạm điều kiện loại trừ trong 2SLS. Thực tế mô hình hỗn hợp hữu hạn trong phần phụ lục của chính bài báo gốc cũng cho thấy can thiệp làm dịch chuyển xác suất rơi vào nhóm chú tâm đến sự im lặng chứ không chỉ dịch chuyển vị trí trung bình của phân phối niềm tin, qua đó càng làm suy yếu giả định truyền dẫn đơn kênh tuyến tính.
A.2.2. Tự chọn lọc vào phiên thảo luận, suy diễn cụm nhỏ và bất nhất trong kiểm định suest
Rà soát chi tiết quy trình thực địa và kịch bản ước lượng gốc chỉ ra ba vấn đề cấu trúc trong suy diễn thống kê và phân tầng cụm. Thứ nhất, mặc dù phân bổ ngẫu nhiên được thực thi ở cấp độ cá nhân theo từng đợt hằng tuần, thí nghiệm không phân bổ ngẫu nhiên cứng cá nhân vào từng phòng Zoom cụ thể mà cho phép sinh viên tự đăng ký vào một trong bốn khung giờ thảo luận sẵn có thuộc nhánh đối chứng hoặc can thiệp của mình; Cơ chế tự chọn lịch theo khung giờ có thể tạo ra sự phân tầng nội sinh theo đặc điểm không quan sát được về thời gian biểu hoặc mức độ hướng ngoại giữa các phòng. Quan trọng hơn, rà soát cấu trúc dữ liệu nguyên bản phát hiện vi phạm cách ly nhánh can thiệp tại một phòng ở mỗi cohort: phòng thảo luận mang mã số 20 trong cohort năm 2023 chứa đồng thời sinh viên đối chứng và sinh viên can thiệp tạo thành quan sát thiểu số nhiễu chéo, còn phòng số 25 trong cohort năm 2025 trộn lẫn quan sát đối chứng với quan sát can thiệp, bên cạnh hai phòng số 7 và 16 ghi nhận hai mã điều phối viên khác nhau trong cùng một phiên. Dẫu kiểm chứng độ nhạy khi loại bỏ phòng nhiễm chéo số 20 trên quan sát thiểu số giữ hệ số ở mức với ở mô hình tuyến tính và với ở 2SLS, sự tồn tại của phòng hỗn hợp vẫn phá vỡ phần nào giả định không tương tác chéo giữa các nhánh SUTVA.
Thứ hai, trong đặc tả trọng tâm biểu đạt thiểu số trên quan sát, tổng số tham số ước lượng trùng khít với tổng số cụm phòng Zoom , bao gồm đồng thời nhiều biến kiểm soát cấp phòng như quy mô nhóm, điều phối viên, tuần tuyển mẫu và khung giờ thảo luận. Việc khử trung bình quá nhiều chiều cố định ở cấp độ cụm khi tiệm cận tạo ra tương quan âm cơ học giữa phần dư trong cùng cụm, giải thích vì sao sai số chuẩn phân cụm theo phiên Zoom tại mức với số cụm hiệu dụng theo Carter, Schnepel và Steigerwald (2017) lại nhỏ hơn cả sai số chuẩn phân cụm theo cá nhân ở mức lẫn sai số chuẩn White không cụm ở mức . Việc kiểm định suy diễn cụm điều phối viên lại càng bấp bênh vì chỉ tồn tại cụm và số cụm hiệu dụng , khiến phân phối tới hạn phình rộng và không đạt chuẩn tiệm cận theo Cameron, Gelbach và Miller (2008).
Thứ ba, kiểm định SUEST so sánh mức cập nhật niềm tin giữa kỳ và cuối kỳ trong kịch bản gốc áp dụng phân cụm toàn cục ở cấp độ cá nhân với , thay vì cấp độ phòng thảo luận cho phương trình cuối kỳ. Vì nhận thức cuối kỳ được hình thành sau phút tương tác chung trong cùng phòng Zoom, phần dư chia sẻ cú sốc đồng nhóm tương tự bài toán phản chiếu của Manski, nên việc bỏ qua tương quan nội phòng trong SUEST làm thổi phồng thống kê kiểm định. Thực nghiệm tái ước lượng SUEST phân cụm ở cấp phòng Zoom cho thấy thống kê Wald giảm từ với xuống còn với ở cặp cơ bản, và từ với xuống còn với ở cặp kiểm soát đầy đủ; Đồng thời ở cặp thứ hai trong mã nguồn gốc, phương trình so sánh SUEST đã vô tình bỏ sót biến kiểm soát quan điểm bí mật vốn hiện diện trong hai cột tương ứng của Bảng 2 gốc.
A.3. Thẩm định chất lượng dữ liệu, cách đo lường biến số và độ nhạy mẫu
A.3.1. Phân rã đo lường biến biểu đạt, giới hạn xác suất tuyến tính và tiêu hao mẫu
Về phương diện đo lường biến phụ thuộc, chỉ báo biểu đạt trung thực trong cả giai đoạn Người tiên phong lẫn Người đi sau thực chất là biến nhị phân gộp hai trạng thái hành vi hoàn toàn khác nhau về bản chất kinh tế học vào cùng giá trị : trạng thái im lặng thuần túy không đăng ký phát biểu và trạng thái ngụy trang quan điểm tức phát biểu trái ngược với lập trường bí mật của bản thân. Phân rã trực tiếp phân phối thô trên dữ liệu gốc làm rõ cơ chế thực sự bị che khuất bởi biến gộp này. Ở nhóm Người tiên phong, phát biểu trung thực, chọn im lặng hoàn toàn và chỉ phát biểu ngược lập trường. Trong nhóm Người đi sau thuộc phe thiểu số bất đồng, tỷ lệ im lặng giảm mạnh từ ở nhánh đối chứng xuống ở nhánh can thiệp, tương ứng với bước nhảy từ lên phát biểu trung thực, trong khi tỷ lệ nói trái quan điểm giữ nguyên bất biến ở mức so với ; Còn ở phe đa số, tỷ lệ im lặng gần như đóng băng tại ở đối chứng và ở can thiệp. Như vậy, can thiệp hoàn toàn chỉ mở khóa biên rộng từ im lặng sang cất tiếng nói, chứ không hề làm giảm hành vi bóp méo quan điểm có chủ đích.
Bên cạnh đó, việc lựa chọn mô hình xác suất tuyến tính OLS làm đặc tả chuẩn dẫn đến hiện tượng dự báo vượt biên xác suất hợp lệ tại trên tổng số quan sát thiểu số, tương đương mẫu với giá trị dự báo tối thiểu rơi xuống . Việc xử lý biến kiểm soát năm học cũng thiếu đồng nhất giữa các bảng: các bảng phân tích Người tiên phong và cập nhật niềm tin đưa năm học vào dưới dạng biến giả phân loại đầy đủ, nhưng các bảng biểu đạt và 2SLS lại ép biến năm học thành biến số tuyến tính liên tục; Dẫu phép chuyển về biến giả phân loại chỉ dịch nhẹ hệ số trọng tâm từ xuống với , sự không nhất quán mã hóa phản ánh thiếu sót chuẩn hóa nội bộ. Đồng thời, tài liệu thiết kế gốc ghi nhận phân bổ đối chứng và can thiệp trên Người đi sau, nhưng tệp theo dõi tiêu hao mẫu thực tế lại chứa chính xác đối chứng và can thiệp trên người hoàn thành khảo sát nền. Dù tỷ lệ rời bỏ giữa hai nhánh cân bằng ở mức so với và giới hạn cắt tỉa theo Lee (2009) nằm chặt trong điểm phần trăm, quy trình chọn lọc hai tầng từ bước đăng ký lịch Zoom đạt trên người xuống bước hiện diện thực tế đạt người vẫn có thể vi phạm giả định đơn điệu một chiều nếu tồn tại hai lực chọn lọc ngược chiều tự triệt tiêu về trung bình, nhất là khi đặc trưng gốc Á có độ lệch tiêu hao cận biên với .
Hơn thế nữa, phân tầng bốn nhóm theo độ lệch nhận thức ban đầu và mức độ chắc chắn cho thấy phản ứng từ niềm tin đến hành vi mang tính ngưỡng phi tuyến rõ rệt chứ không phải một độ dốc tuyến tính bất biến như giả định của mô hình 2SLS:
Trong đó:
- : lập trường cá nhân bí mật nhận giá trị đối với phân nhóm thiểu số bất đồng trên chủ đề ;
- : hàm phân phối tích lũy chuẩn hóa mô tả xác suất vượt ngưỡng tự kiểm duyệt;
- : lợi ích biểu đạt nội tại thu được khi cá nhân nói lên sự thật phù hợp với niềm tin cá nhân;
- : hàm chi phí kỳ vọng bị cô lập xã hội tăng phi tuyến theo nhận thức giữa kỳ và độ chắc chắn ban đầu ;
- : độ lệch chuẩn của nhiễu ngẫu nhiên trong ngưỡng ra quyết định cá nhân.
Chính cấu trúc ngưỡng phi tuyến này lý giải nghịch lý ở Nhóm 2 lệch nhận thức cao kèm độ chắc chắn lớn chiếm mẫu hoàn chỉnh: dù cập nhật niềm tin cuối kỳ tới điểm phần trăm với , xuất phát điểm sai lệch quá lớn tại mức khiến niềm tin hậu nghiệm của họ vẫn neo trên ngưỡng đa số áp đảo nên tỷ lệ phát biểu thiểu số chỉ nhích nhẹ điểm phần trăm với điểm phần trăm và hoàn toàn không có ý nghĩa thống kê ở mức ; Trái lại, Nhóm 4 lệch thấp nhưng chắc chắn bứt phá tới điểm phần trăm với vì chỉ cần một cú điều chỉnh niềm tin đủ đẩy họ vượt qua ngưỡng an toàn tâm lý.
A.3.2. Kiểm định độ nhạy cấu trúc sai số chuẩn trên chuỗi khảo sát anes 1974–2020 và ma trận thẩm định
Vấn đề suy diễn nghiêm trọng nhất nằm ở chuỗi bằng chứng ngoại suy lịch sử trên khảo sát cử tri Hoa Kỳ ANES giai đoạn 1974–2020. Mặc dù dữ liệu gồm dòng quan sát, cấu trúc bảng thực chất ghép cặp hai dòng đại diện hai đảng Dân chủ và Cộng hòa cho cùng một câu hỏi khảo sát trong cùng năm bầu cử, dẫn tới chỉ có cặp năm và chủ đề độc nhất trên tổng số chủ đề chính sách lặp lại qua nhiều thập kỷ; Biến nổi bật truyền thông và nhận thức chính trị hoàn toàn giống hệt nhau giữa hai dòng cùng cặp. Tuy nhiên, toàn bộ 12 hồi quy ANES trong nghiên cứu gốc đều dùng sai số chuẩn OLS cổ điển không phân cụm và không gán trọng số cho quy mô mẫu khảo sát biến thiên rất lớn giữa các kỳ. Khi tái ước lượng sai số chuẩn phân cụm theo chủ đề ở cấp độ nhằm kiểm soát tự tương quan chuỗi thời gian trong từng chủ đề chính sách, mức ý nghĩa thống kê tại tất cả bốn mô hình kiểm soát đầy đủ của Bảng 6 đều biến mất hoàn toàn. Bảng A1 tổng hợp đầy đủ ma trận kiểm định độ nhạy cấu trúc suy diễn và chất lượng dữ liệu trên toàn bộ các kênh trọng yếu.
| Thành phần thẩm định | Đặc tả đối chiếu | Kết quả gốc | Thước đo chẩn đoán mới | Trị số p gốc | Trị số p mới | Hàm ý kinh tế lượng |
|---|---|---|---|---|---|---|
| Tác động thiểu số phòng sạch | Loại phòng hỗn hợp số 20 trên quan sát | +0.1809 (0.0309) | +0.1760 (0.0333) | 0.0000 | 0.0000 | Ổn định sau loại nhiễm chéo nhóm |
| Tác động thiểu số biến giả năm học | Biến năm phân loại thay liên tục trên quan sát | +0.1809 (0.0309) | +0.1774 (0.0315) | 0.0000 | 0.0000 | Không nhạy dạng hàm biến nền |
| Cơ chế 2SLS phòng sạch | Loại phòng hỗn hợp số 20 trên quan sát | -0.0250 (0.0054) | -0.0257 (0.0060) | 0.0000 | 0.0000 | Vững độ lớn nhưng giữ rủi ro loại trừ |
| Kiểm định SUEST cặp cơ bản | Cụm phòng Zoom thay | 0.0012 | 0.0070 | Giảm lực kiểm định nhưng giữ mức | ||
| Kiểm định SUEST cặp đầy đủ | Cụm phòng Zoom thay | 0.0040 | 0.0060 | Phản ánh phụ thuộc thảo luận cuối kỳ | ||
| ANES toàn mẫu sai lệch chuẩn hóa | Cụm theo chủ đề thay OLS cổ điển | +0.1694 (0.0785) | +0.1694 (0.1242) | 0.0326 | 0.2215 | Mất ý nghĩa thống kê khi xét cụm chủ đề |
| ANES toàn mẫu độ lệch tuyệt đối | Cụm theo chủ đề thay OLS cổ điển | +0.1935 (0.1124) | +0.1935 (0.1385) | 0.0871 | 0.2117 | Sai số chuẩn gốc đánh giá thấp phương sai |
| ANES phỏng vấn trực tiếp chuẩn hóa | Cụm theo chủ đề thay OLS cổ điển | +0.1538 (0.0816) | +0.1538 (0.1418) | 0.0612 | 0.3197 | Không còn khác biệt thống kê với |
| ANES trực tiếp độ lệch tuyệt đối | Cụm theo chủ đề thay OLS cổ điển | +0.2378 (0.1147) | +0.2378 (0.1225) | 0.0398 | 0.1003 | Rơi khỏi ngưỡng ý nghĩa |
Ghi chú: Mức ý nghĩa quy ước theo , , . Giá trị trong ngoặc đơn là sai số chuẩn tương ứng với từng phép ước lượng. Kết quả gốc đối chiếu trực tiếp từ chuỗi 68 mô hình tái lập trên quan sát chuẩn hóa; Các đặc tả chẩn đoán mới tái ước lượng trên cùng tệp dữ liệu chuẩn hóa nhằm đánh giá độ bền vững suy diễn thống kê.
A.4. Các hạn chế cốt lõi trọng yếu của nghiên cứu gốc
- Rủi ro vi phạm điều kiện loại trừ và kênh truyền dẫn đa đường trong ước lượng biến công cụ 2SLS: Chiến lược nhận dạng cấu trúc lấy phân bổ ngẫu nhiên làm biến công cụ loại trừ cho niềm tin giữa kỳ bỏ qua khả năng can thiệp làm thay đổi trực tiếp chi phí kỳ thị xã hội , tạo hiệu ứng cầu thí nghiệm hướng sự chú ý đến quyền phản biện hoặc kích hoạt sự cởi mở tuần tự của bạn cùng phòng qua các chủ đề thảo luận nối tiếp; Do hiệu ứng giai đoạn một mang dấu âm trong khi kênh trực tiếp và lan tỏa nhóm mang dấu dương, thành phần chệch kéo hệ số 2SLS tại mức lệch âm mạnh hơn thực tế và làm nhiễu rạch ròi giữa độ chệch suy giảm do sai số đo lường trong OLS với thiên lệch nội sinh loại trừ.
- Bất nhất cấp độ phân cụm sai số chuẩn, bão hòa tham số cụm và phóng đại ý nghĩa thống kê trên dữ liệu ANES: Trong phân tích thực nghiệm, kiểm định SUEST giữa kỳ và cuối kỳ áp dụng phân cụm cá nhân thay vì phân cụm phòng Zoom khiến thống kê bị thổi phồng từ lên ở cặp cơ bản, còn mô hình thiểu số trọng tâm sử dụng tham số bằng đúng số cụm dẫn đến tương quan nội cụm âm cơ học làm sai số chuẩn cụm Zoom giảm xuống so với mức ở cấp cá nhân; Trong khi đó, phân cụm theo điều phối viên chỉ có và theo Carter, Schnepel và Steigerwald (2017), còn chuỗi hồi quy ANES hoàn toàn không phân cụm theo cặp năm–chủ đề hoặc chủ đề, không dùng trọng số cỡ mẫu và dính bẫy biến tỷ số kiểu Kronmal, khiến toàn bộ mức ý nghĩa bị triệt tiêu khi hiệu chỉnh cụm chủ đề.
- Tự chọn lọc lịch thảo luận, nhiễm chéo phòng và điều kiện đơn điệu của tiêu hao mẫu: Quá trình chuyển từ người khảo sát nền và Người đi sau được phân bổ ngẫu nhiên xuống người đăng ký lịch và người dự thảo luận cho phép tự chọn khung giờ trong từng nhánh, làm phát sinh thiên lệch chọn mẫu theo thời gian biểu và tạo ra hai phòng hỗn hợp chứa cả đối tượng đối chứng lẫn can thiệp là phòng số 20 ở cohort năm 2023 và phòng số 25 ở cohort năm 2025 cùng hai phòng mang hai mã điều phối viên; Mặc dù giới hạn cắt tỉa theo Lee (2009) giữ vững quanh điểm phần trăm và độ chọn lọc theo Oster (2019) đạt mức an toàn cao, sự chọn lọc hai bước khác biệt có thể vi phạm giả định đơn điệu đơn chỉ số và gây chệch ước lượng nếu tồn tại hai cơ chế rời bỏ ngược chiều khi yếu tố chủng tộc cho thấy chênh lệch tiêu hao biên tại .
- Gộp chung trạng thái im lặng với phát ngôn trái lòng và khuyết điểm dự báo ngoài biên của hồi quy tuyến tính: Biến nhị phân biểu đạt trung thực gộp chung hành vi im lặng với hành vi phát biểu ngược quan điểm bí mật trong nhóm đối chứng thiểu số, che lấp thực tế rằng can thiệp chỉ thúc đẩy biên rời bỏ im lặng mà không tác động tới mức độ ngụy trang lập trường; Đồng thời mô hình xác suất tuyến tính OLS sinh ra trên giá trị dự báo nằm dưới xuống tới kèm theo sự thiếu nhất quán khi mã hóa năm học dạng liên tục ở bảng biểu đạt nhưng dạng phân loại ở các bảng trước đó.
- Phản ứng ngưỡng phi tuyến theo độ chắc chắn niềm tin và bất đối xứng lực mẫu theo chủ đề: Việc gộp bốn chủ đề thảo luận làm mờ tính không đồng nhất cấu trúc về lực thống kê và chuẩn mực xã hội: chủ đề Tiêm chủng vắc-xin chỉ có quan sát thiểu số, mang độ lệch ảo tưởng ban đầu âm điểm phần trăm và cho hệ số không có ý nghĩa ở mức ; Nghiêm trọng hơn, phân tích phân nhóm cho thấy Nhóm 2 lệch nhận thức cao kèm chắc chắn cao tuy giảm nhận thức điểm phần trăm nhưng hầu như bất động về hành vi biểu đạt ở mức điểm phần trăm với , chứng minh hàm phản ứng niềm tin sang phát ngôn mang tính ngưỡng phi tuyến và gây chệch ước lượng tổng hợp nếu áp đặt độ dốc đồng nhất trong 2SLS.
- Giới hạn giá trị ngoại suy từ môi trường đại học trực tuyến sang thiết chế dư luận thực tế: Mẫu thực nghiệm chịu thiên lệch chọn mẫu đặc thù khi phụ thuộc hoàn toàn vào sinh viên tình nguyện tại phòng thí nghiệm đại học UC Berkeley với tỷ lệ nữ giới và sinh viên gốc Á trên , thảo luận ẩn danh một phần trong phút qua Zoom với quy mô đến người xa lạ và không có chi phí danh tiếng lặp lại; Hơn nữa, dù dự đoán niềm tin được thưởng tiền chính xác, quyết định giơ tay phát biểu không gắn chế tài xã hội thực thụ, khiến bước nhảy ngoại suy sang dữ liệu lịch sử cử tri toàn quốc ANES đối mặt rủi ro biến bỏ sót vĩ mô và thiếu tính nhất quán ngoại suy đối với cấu trúc chi phí bị cô lập ngoài đời thực.
A.5. Khuyến nghị nâng cấp mô hình và hướng mở rộng công bố quốc tế
- Thiết kế nhánh đối chứng tích cực bằng video giả dược trung tính và nhận dạng đa biến công cụ: Để cô lập triệt để hiệu ứng cầu thí nghiệm khỏi cơ chế cập nhật niềm tin Bayes trong bài toán 2SLS, nghiên cứu mở rộng cần bổ sung một nhánh đối chứng tích cực xem đoạn video cùng độ dài về quy tắc giao tiếp trực tuyến nhưng không đề cập đến hiện tượng tự kiểm duyệt, kết hợp ngẫu nhiên hóa trực giao mức độ cung cấp thông tin định lượng; Cấu trúc đa công cụ này cho phép thực thi kiểm định siêu nhận dạng Hansen nhằm kiểm chứng trực tiếp giả thuyết và tách bạch rạch ròi kênh nhận thức chuẩn mực khỏi kênh tâm lý.
- Ước lượng mô hình cấu trúc lựa chọn rời rạc đa trạng thái phân tách chi phí danh tiếng xã hội: Thay cho hồi quy xác suất tuyến tính OLS và 2SLS nhị phân, hướng nâng cấp chuẩn mực cho công bố quốc tế hàng đầu là xây dựng mô hình Logit đa thức hoặc mô hình ngưỡng cấu trúc phân tách ba lựa chọn là im lặng, phát biểu trung thực và ngụy trang quan điểm; Kết hợp phương pháp hàm kiểm soát phi tuyến và tương tác với độ chắc chắn ban đầu sẽ ước lượng được trực tiếp phân phối tham số chi phí kỳ thị cũng như điểm gãy phi tuyến lý giải sự kháng cự của Nhóm 2.
- Phân bổ ngẫu nhiên ở cấp phòng thảo luận kết hợp suy diễn ngẫu nhiên hóa Fisher và tái hiệu chỉnh ANES: Cần loại bỏ hoàn toàn bước tự đăng ký khung giờ bằng cách phân bổ ngẫu nhiên cụm theo từng phòng thảo luận ngay từ khâu tuyển mẫu nhằm khôi phục tính toàn vẹn SUTVA, đồng thời kết hợp suy diễn ngẫu nhiên hóa cấp cụm theo Fisher với Rademacher Wild Cluster Restricted Bootstrap theo Cameron, Gelbach và Miller (2008) cho cả SUEST lẫn 2SLS; Đối với chuỗi dữ liệu ANES, cần ước lượng bình phương nhỏ nhất có trọng số theo quy mô khảo sát kết hợp phân cụm hai chiều theo năm và chủ đề, đồng thời đưa mẫu số quy mô phỏng vấn vào dạng hàm tách biệt để loại trừ thiên lệch biến tỷ số.
- Ngắt mạch lan tỏa tuần tự giữa các chủ đề bằng cơ chế bộc lộ đồng thời hoặc ngẫu nhiên hóa thứ tự: Để khắc phục nhiễu phản hồi tuần tự từ việc nghe các lượt phát biểu ở chủ đề trước làm biến đổi hành vi ở chủ đề sau trong cùng phiên thảo luận, thiết kế cải tiến nên yêu cầu tất cả thành viên gửi quyết định đăng ký phát biểu cho toàn bộ chủ đề cùng lúc trước khi bước vào phần phát biểu công khai, hoặc ngẫu nhiên hóa thứ tự thảo luận các chủ đề giữa các phòng Zoom để nhận dạng riêng độ co giãn học hỏi xã hội động theo thời gian thực.
- Mở rộng tái lập đa trường đại học đại diện quốc gia và thử nghiệm thực địa trên nền tảng cộng đồng thực danh: Nhằm khẳng định tính phổ quát ngoài khuôn viên đại học đặc thù, lộ trình nghiên cứu tiếp theo nên triển khai tái lập tiền đăng ký trên mạng lưới sinh viên đa vùng miền có phổ tư tưởng chính trị cân bằng hơn cùng bảng hộ gia đình quốc gia theo dõi nhiều đợt qua nhiều tuần; Song song đó, tích hợp thử nghiệm thực địa trên các diễn đàn thảo luận công dân thực danh thông qua hiển thị thống kê lượt người xem nhưng không bình luận ngay cạnh luồng ý kiến công khai sẽ đánh giá được tác động cân bằng tổng thể lên mức độ phân cực và chất lượng đồng thuận xã hội.
Tài liệu tham khảo
- Anderson, T. W., & Rubin, H. (1949). Estimation of the parameters of a single equation in a complete system of stochastic equations. The Annals of Mathematical Statistics, 20, 46–63. https://doi.org/10.1214/aoms/1177730090
- Bursztyn, L., Egorov, G., & Fiorin, S. (2020). From extreme to mainstream: The erosion of social norms. American Economic Review, 110, 3522–3548. https://doi.org/10.1257/aer.20171175 ↩
- Bursztyn, L., González, A. L., & Yanagizawa-Drott, D. (2020). Misperceived social norms: Women working outside the home in Saudi Arabia. American Economic Review, 110, 2997–3029. https://doi.org/10.1257/aer.20180975
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2008). Bootstrap-based improvements for inference with clustered errors. The Review of Economics and Statistics, 90, 414–427. https://doi.org/10.1162/rest.90.3.414 ↩
- Carter, A. V., Schnepel, K. T., & Steigerwald, D. G. (2017). Asymptotic behavior of a t-test robust to cluster heterogeneity. The Review of Economics and Statistics, 99, 698–709. https://doi.org/10.1162/REST_a_00639 ↩
- Ho, Y., & Huang, Y. (2026). Breaking the spiral of silence. Journal of Political Economy, Accepted. Harvard Dataverse. https://doi.org/10.7910/DVN/OOR1AO
- Kleibergen, F., & Paap, R. (2006). Generalized reduced rank tests using the singular value decomposition. Journal of Econometrics, 133, 97–126. https://doi.org/10.1016/j.jeconom.2005.02.011
- Lee, D. S. (2009). Training, wages, and sample selection: Estimating sharp bounds on treatment effects. The Review of Economic Studies, 76, 1071–1102. https://doi.org/10.1111/j.1467-937X.2009.00536.x ↩
- Montiel Olea, J. L., & Pflueger, C. (2013). A robust test for weak instruments. Journal of Business & Economic Statistics, 31, 358–369. https://doi.org/10.1080/00401706.2013.806694
- Noelle-Neumann, E. (1974). The spiral of silence: A theory of public opinion. Journal of Communication, 24, 43–51. https://doi.org/10.1111/j.1460-2466.1974.tb00367.x ↩
- Oster, E. (2019). Unobservable selection and coefficient stability: Theory and evidence. Journal of Business & Economic Statistics, 37, 187–204. https://doi.org/10.1080/07350015.2016.1227711 ↩
- Zellner, A. (1962). An efficient method of estimating seemingly unrelated regressions and tests for aggregation bias. Journal of the American Statistical Association, 57, 348–368. https://doi.org/10.1080/01621459.1962.10480664 ↩
spiral_of_silence_experimentsample_rolecohortis_first_moveris_second_moveris_core_topicis_placebo_topicsurvey_idzoom_idtopictreatattrprivate_Mở khóa dữ liệu & mã lệnh tái lập
Sau khi theo dõi phần phân tích định lượng và bình duyệt học thuật phía trên, mời bạn đăng nhập nếu đã có gói thành viên hoặc tham gia cộng đồng nghiên cứu EcoLab để trực tiếp kiểm chứng từng hệ số ước lượng trên máy cá nhân.
Khớp chính xác tên biến, đặc tả sai số chuẩn vững và ma trận kiểm định chẩn đoán của bài nghiên cứu.
Sẵn sàng nạp trực tiếp vào môi trường thống kê cá nhân để đối chiếu độc lập từng bảng kết quả.
Đóng gói đồng bộ bản thảo chuẩn công bố tạp chí DOCX & PDF, tệp dữ liệu CSV, ba kịch bản ước lượng R · Stata · Python và hướng dẫn thực thi.
Mỗi liên kết tải xuống được cấp chữ ký bảo mật riêng cho tài khoản thành viên và tự động làm mới mượt mà ngay trên trang đọc.