Phân tích phúc lợi thanh tra thuế theo phân phối thu nhập: Nghiên cứu tái lập đa nền tảng
1. Giới thiệu và tóm tắt nghiên cứu gốc
1.1. Bối cảnh lý thuyết và vị trí trong văn liệu tài chính công
Việc phân bổ nguồn lực cưỡng chế thuế giữa các nhóm thu nhập là một trong những bài toán trọng tâm của kinh tế học khu vực công kể từ mô hình trốn thuế kỳ vọng lợi ích kinh điển của Allingham và Sandmo (1972). Trong khung lý thuyết thuế tối ưu hiện đại của Keen và Slemrod (2017) và tổng quan của Slemrod (2019), cơ quan thuế cần cân bằng giữa doanh thu thu hồi tăng thêm với hai loại chi phí nguồn lực thực: chi phí hành chính của nhà nước và chi phí tuân thủ phát sinh từ phía người nộp thuế. Trước đây, phần lớn các ước lượng thực nghiệm tập trung đo lường tỷ suất hoàn vốn tài khóa tức thời hoặc phản ứng hành vi cục bộ sau thanh tra ngẫu nhiên trên từng nhóm thu nhập hẹp, chẳng hạn nghiên cứu thực nghiệm của Kleven, Knudsen, Kreiner, Pedersen và Saez (2011) tại Đan Mạch, bằng chứng về răn đe dài hạn của DeBacker, Heim, Tran và Yuskavage (2018) và thí nghiệm thực địa về mạng lưới doanh nghiệp của Boning, Guyton, Hodge và Slemrod (2020). Đồng thời, các bằng chứng hành chính mới về trốn thuế ở nhóm đỉnh như Alstadsæter, Johannesen và Zucman (2019) hay Guyton, Langetieg, Reck, Risch và Zucman (2021) chỉ ra rằng quy mô trốn thuế phức tạp tập trung rất mạnh ở nhóm 1% giàu nhất, nơi thanh tra tiêu chuẩn khó phát hiện hết tài sản ẩn giấu.
Công trình của Boning, Hendren, Sprung-Keyser và Stuart (2025) trên The Quarterly Journal of Economics đã thống nhất ba mảng dữ liệu hành chính quy mô lớn của Sở Thuế vụ Hoa Kỳ IRS — dữ liệu thanh tra thực địa và qua thư, hệ thống kế toán chi phí nội bộ theo từng khâu quy trình và chuỗi dọc dài hạn sau Chương trình Nghiên cứu Quốc gia NRP — vào khung định lượng Giá trị Cận biên Công quỹ MVPF do Hendren và Sprung-Keyser (2020) phát triển. Thay vì chỉ trả lời câu hỏi một đô la chi cho thanh tra thu về bao nhiêu đô la ngân sách, nghiên cứu gốc định lượng chi phí xã hội thực để huy động mỗi đô la công quỹ thuần thông qua thanh tra thuế tại từng phân vị thu nhập, từ đó đối chiếu trực tiếp hiệu quả phúc lợi của thanh tra thuế với giải pháp điều chỉnh biểu thuế suất thu nhập biên.
1.2. Phát hiện gốc và cấu trúc kho lưu trữ công khai
Do Điều 6103 Bộ luật Thuế nội địa Hoa Kỳ nghiêm cấm công bố hồ sơ khai thuế vi mô và dữ liệu hạch toán chi phí chi tiết của gần 650.000 hồ sơ thanh tra thực địa cùng mẫu phân tầng NRP, gói tái lập chính thức doi:10.7910/DVN/SVQASQ phân phối hệ thống 26 tệp dữ liệu tổng hợp theo nhóm phân vị thu nhập và năm sự kiện, 2 bảng tính Table_1.xlsx và Appendix_Tables.xlsx, cùng 29 kịch bản Stata tái tạo đầy đủ hệ thống hình vẽ và bảng biểu công bố. Những kết quả định lượng chủ chốt từ ấn phẩm gốc bao gồm ba trụ cột:
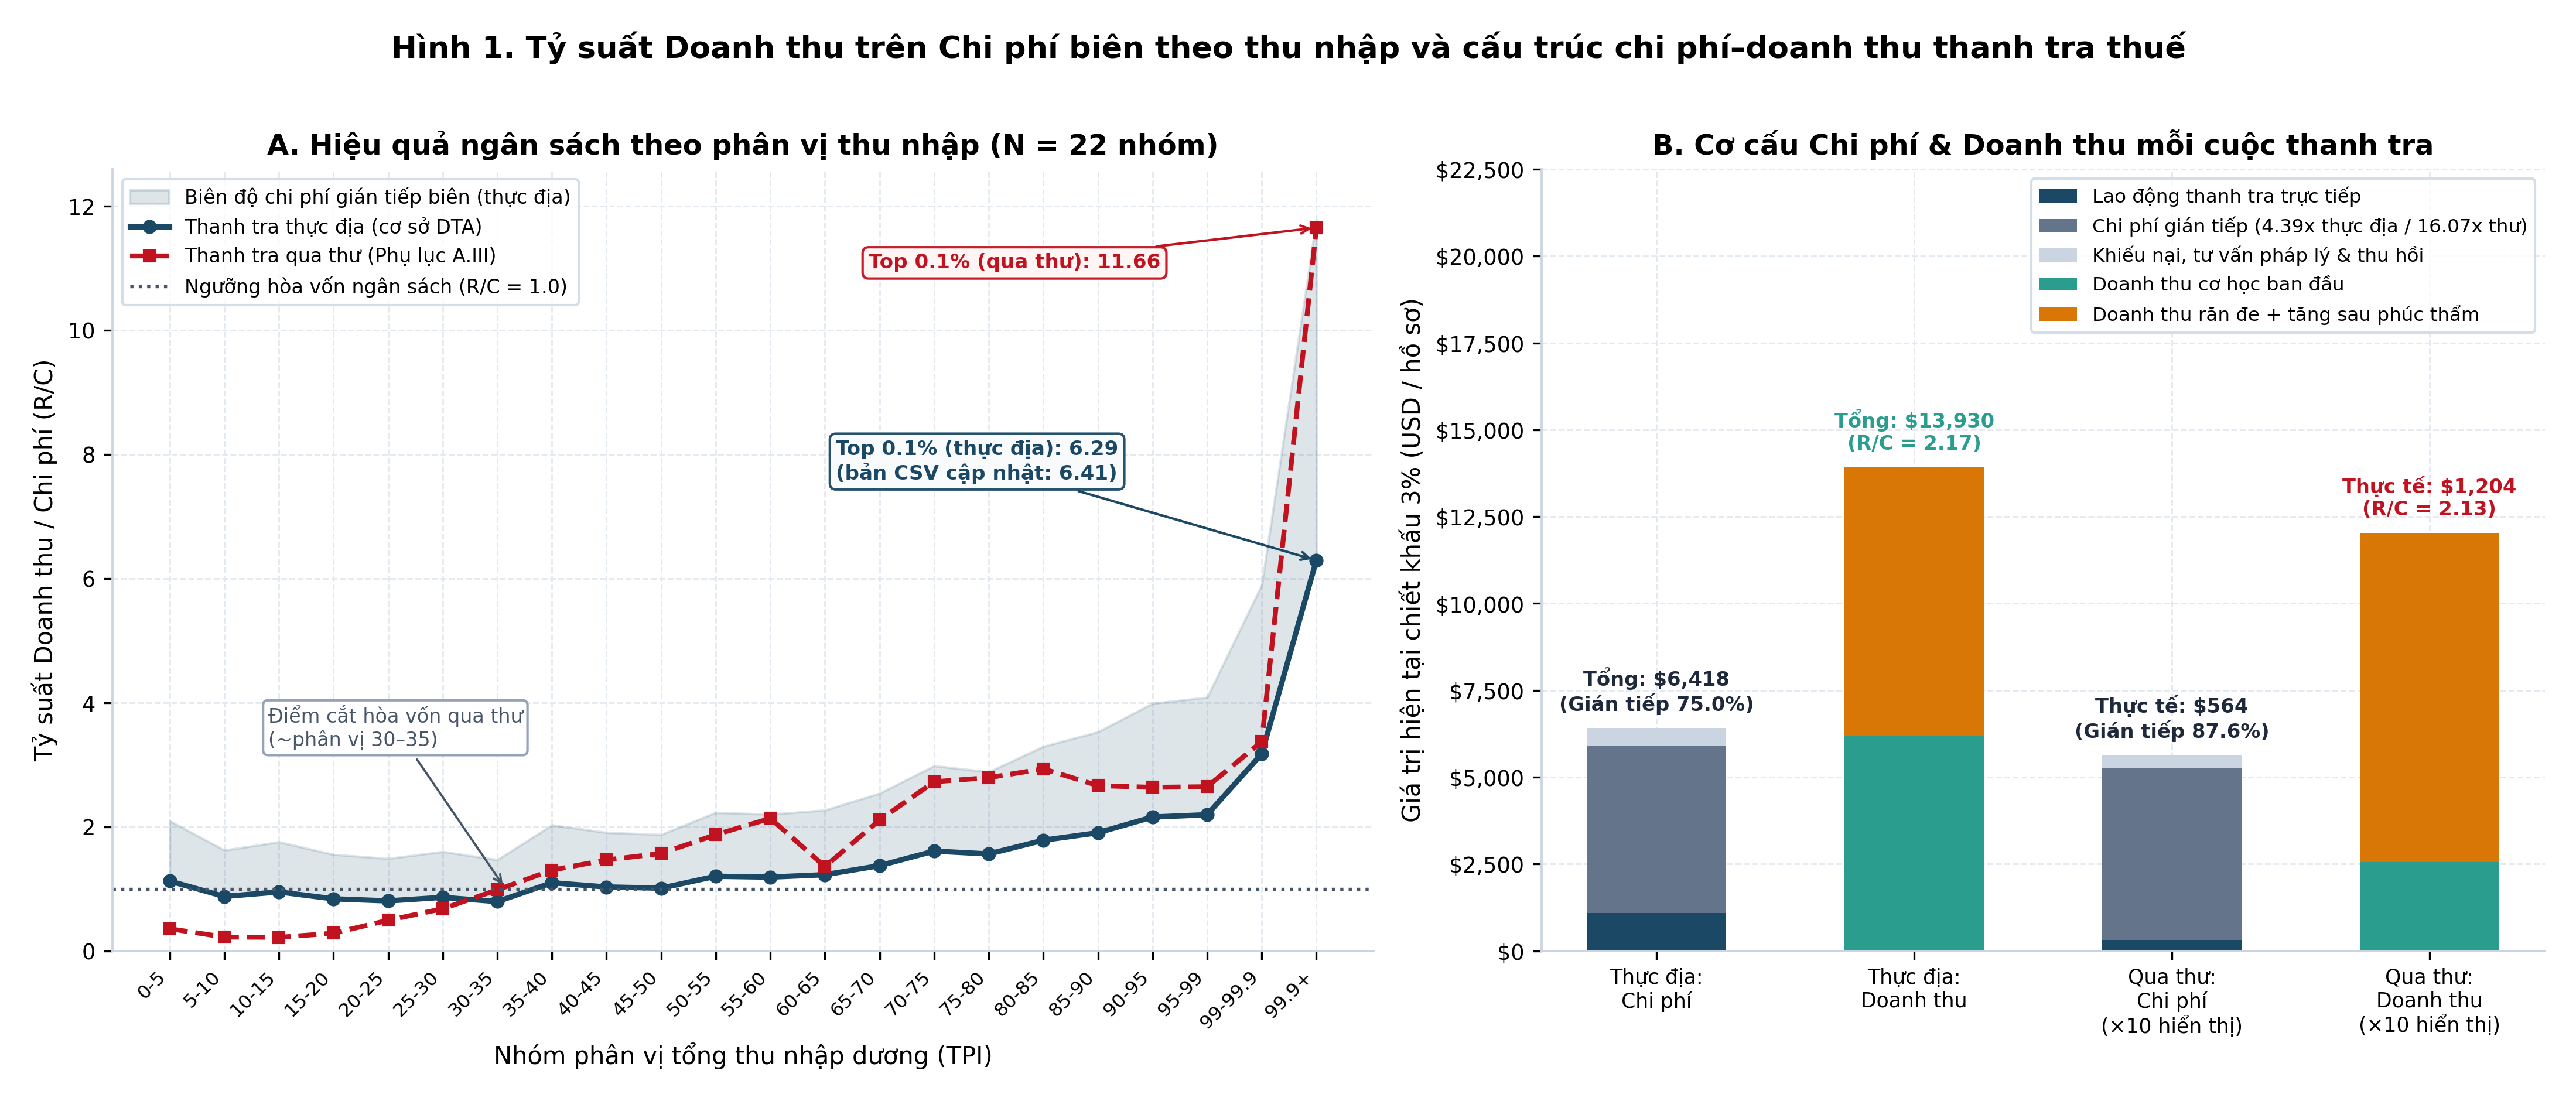
- Hiệu quả tài khóa cơ sở và cơ cấu chi phí gián tiếp: Một cuộc thanh tra thực địa bình quân tiêu tốn 6,417.97 USD — trong đó lao động thanh tra trực tiếp chỉ chiếm 1,096.86 USD và chi phí gián tiếp chiếm tới 4,810.17 USD, tương ứng bội số phân bổ 4.3854 lần — và thu về 13,929.53 USD giá trị hiện tại chiết khấu 3%, đạt tỷ suất doanh thu trên chi phí R/C bằng 2.1704; Thanh tra qua thư tiêu tốn 563.87 USD với bội số gián tiếp 16.0703 lần và thu về 1,203.58 USD, đạt tỷ suất R/C bằng 2.1345.
- Độ dốc hiệu quả theo thu nhập và bội số răn đe: Trên thang phân vị tổng thu nhập dương TPI, tỷ suất R/C thanh tra thực địa tăng từ dưới 1.0 ở vùng thu nhập thấp lên 3.1759 ở nhóm 99–99.9 và 6.2948 ở nhóm top 0.1%, trong khi thanh tra qua thư đạt tới 11.6561 ở nhóm top 0.1%; Khi cộng thêm hiệu ứng răn đe cá nhân dài hạn, hệ số nhân răn đe gộp đạt 3.1756 lần, đẩy tỷ suất doanh thu trên chi phí biên ở nhóm 99.9+ lên 36.0183 lần theo hệ số nhân đồng nhất và 44.0515 lần theo hệ số nhân riêng từng nhóm phân vị.
- Phân hóa phúc lợi MVPF ngược chiều hiệu quả ngân sách: Mặc dù nhóm phân vị cao mang lại tỷ suất hoàn vốn ngân sách vượt trội, gánh nặng tuân thủ thời gian và tiền tệ của người nộp thuế lại tăng mạnh theo thu nhập — lên tới 19,131.15 USD đối với người có điều chỉnh thuế và 36,128.12 USD đối với người không bị điều chỉnh thuế trong nhóm top 1% — khiến chỉ số MVPF giảm dần từ đỉnh 1.3018 ở nhóm 20–30 xuống 1.1389 ở nhóm 80–90 và 1.1501 ở nhóm 90–99.
2. Dữ liệu, khung lý thuyết MVPF và chiến lược định danh tái lập
2.1. Khung lý thuyết giá trị cận biên công quỹ cho hoạt động thanh tra thuế
Trong khung lý thuyết phúc lợi của Hendren và Sprung-Keyser (2020) và Boning và cộng sự (2025), một chính sách tăng ngân sách ròng cho nhà nước thông qua thanh tra biên tại phân vị thu nhập được đánh giá bằng tỷ số giữa giá trị sẵn lòng chi trả ròng của khu vực tư nhân để tránh gánh nặng chính sách ở tử số và tổng doanh thu ngân sách ròng thu về cho chính phủ ở mẫu số:
Trong đó:
- : giá trị cận biên công quỹ của mỗi đô la ngân sách ròng huy động từ cuộc thanh tra biên tại nhóm thu nhập ;
- : tổn thất phúc lợi tư nhân bao gồm tiền thuế truy thu, thuế tự nguyện tăng thêm và chi phí tuân thủ phi chuyển giao;
- : tổng doanh thu thuế chiết khấu 3% gồm doanh thu cơ học ban đầu và doanh thu răn đe dài hạn ;
- : chi phí hành chính biên của cơ quan thuế để thực hiện một cuộc thanh tra tăng thêm;
- : giá trị hiện tại doanh thu cơ học trực tiếp phát hiện tại nhóm phân vị thu nhập ;
- : chi phí hành chính biên phân bổ cho một cuộc thanh tra tăng thêm tại nhóm ;
- : hệ số nhân răn đe đo tỷ số giữa giá trị hiện tại doanh thu răn đe cá nhân và doanh thu cơ học ban đầu tại nhóm ;
- : gánh nặng tuân thủ của người nộp thuế tính bằng tỷ trọng trên doanh thu cơ học ban đầu tại nhóm .
Từ phương trình MVPF trên, hàm ý so sánh phúc lợi xã hội liên phân vị giữa hai nhóm và được xác định thông qua trọng số phúc lợi xã hội cận biên . Cụ thể, chuyển dịch một đô la nguồn lực thanh tra biên từ nhóm thu nhập thấp sang nhóm thu nhập cao giúp cải thiện phúc lợi xã hội ròng bất cứ khi nào , tương đương điều kiện tỷ số trọng số phúc lợi hòa vốn đối với nguồn thu, hay ngược lại người hoạch định phải định giá một đô la thu nhập ở nhóm cao hơn ngưỡng lần nhóm mới biện minh được cho việc giữ nguồn lực thanh tra ở nhóm thay vì nhóm để huy động cùng một đô la công quỹ.
Để lượng hóa cơ chế tạo doanh thu răn đe dài hạn trong dữ liệu nghiên cứu sự kiện và tính bền vững của hiệu quả thanh tra qua giai đoạn cắt giảm ngân sách 2010–2014, nghiên cứu tái lập ước lượng hệ thống hồi quy tuyến tính tổng quát trên ba nhóm phương trình cốt lõi:
Trong đó:
- : tỷ suất doanh thu trên chi phí lao động hoặc tổng doanh thu chiết khấu tại nhóm phân vị thu nhập trong năm thuế 2014 và năm thuế 2010;
- : hệ số chặn nền của mô hình liên thời kỳ và mô hình nghiên cứu sự kiện;
- : hệ số bền vững liên thời kỳ phản ánh mức độ ổn định cấu trúc của hiệu quả thanh tra khi số lượng cuộc thanh tra suy giảm;
- : sai số ngẫu nhiên tương ứng trong phương trình phân vị liên thời kỳ và chuỗi sự kiện;
- : thay đổi thuế tự nguyện hằng năm tại năm sự kiện so với nhóm đối chứng không bị thanh tra NRP;
- : biến chỉ báo giai đoạn hậu thanh tra nhận giá trị bằng khi và bằng khi ;
- : mức tăng thuế tự nguyện bình quân hằng năm sau thanh tra của nhóm không có thu nhập kinh doanh;
- : biến chỉ báo hộ có thu nhập kinh doanh tự doanh hoặc doanh nghiệp nhỏ bằng so với nhóm phi kinh doanh bằng ;
- : chênh lệch tiền xu hướng bình quân giữa nhóm hộ có thu nhập kinh doanh và nhóm phi kinh doanh trước thanh tra;
- : hệ số chênh lệch trong chênh lệch đo phần bù răn đe tăng thêm hằng năm của nhóm có thu nhập kinh doanh so với nhóm phi kinh doanh.
Song song đó, độ dốc theo phân vị thu nhập đối với tỷ suất hoàn vốn biên, giá trị cận biên công quỹ và logarit tổng gánh nặng tuân thủ được đặc tả qua phương trình tuyến tính phân tầng:
Trong đó:
- : biến kết quả kinh tế lượng gồm tỷ suất R/C, giá trị hoặc logarit tổng chi phí tuân thủ ;
- : hệ số chặn nền của phương trình độ dốc phân tầng theo phân vị thu nhập;
- : các hệ số độ dốc biên theo thứ hạng phân vị, bước nhảy nhóm đỉnh và trạng thái không điều chỉnh thuế;
- : thứ hạng phân vị liên tục theo thang 22 nhóm thu nhập hoặc thang 10–12 nhóm decile;
- : biến giả chỉ báo nhóm đỉnh thu nhập cao nhất top 1%, top 5% hoặc top 10% tương ứng từng bảng dữ liệu;
- : biến giả nhận giá trị bằng đối với cuộc thanh tra kết thúc không điều chỉnh tăng thuế bổ sung và bằng khi có truy thu bổ sung;
- : nhiễu ngẫu nhiên đặc thù của ô phân vị và nhóm kết quả .
2.2. Chuẩn hóa dữ liệu thực nghiệm gốc từ kho Harvard Dataverse
Tuân thủ nghiêm ngặt quy tắc giải quyết dữ liệu ưu tiên nguồn gốc thực nghiệm chính thức, chúng tôi trích xuất trực tiếp toàn bộ 26 tệp dữ liệu phân tích .dta, 2 tệp nhị phân lưu dưới phần mở rộng .txt là figure_6.txt và ap12.txt, tệp cập nhật figure_2_5.csv cùng các tệp chỉ số Excel công khai trong kho doi:10.7910/DVN/SVQASQ. Quá trình rà soát toàn bộ 29 kịch bản .do phát hiện figure_6.txt và ap12.txt thực chất là tệp Stata định dạng nhị phân Stata 118 dù mang đuôi văn bản .txt, do đó mọi quy trình đọc chỉ bằng văn bản thuần túy trước đây sẽ bỏ sót chuỗi nghiên cứu sự kiện răn đe cốt lõi. Toàn bộ 16 khối phân tích công khai được hợp nhất thành một tệp dữ liệu chuẩn hóa duy nhất boning_hendren_2025_audits_public.csv gồm 437 dòng và 93 cột biến số, với mã băm SHA-256 xác thực toàn vẹn dữ liệu.
| Tập con dữ liệu | Nguồn lưu trữ chính thức | Số bản ghi | Đơn vị phân tích | Nội dung kinh tế lượng trọng tâm |
|---|---|---|---|---|
| Thanh tra thực địa theo phân vị | figure_2_5.dta và .csv | 22 | Nhóm TPI | Tỷ suất R/C thực địa, giờ công, đơn giá lương và độ nhạy chi phí gián tiếp |
| Thanh tra qua thư theo phân vị | ap3_c_d.dta | 22 | Nhóm TPI | Tỷ suất R/C qua thư, xác suất thanh tra và cơ cấu chi phí |
| Chuỗi thu hẹp ngân sách 2010–2014 | figure_4a_ap9.dta | 22 | Nhóm TPI | So sánh doanh thu, chi phí lao động và quy mô hồ sơ hai năm 2010 và 2014 |
| Bảng tổng hợp hiệu ứng răn đe | Table_1.xlsx và figure_7.dta | 12 | Nhóm decile | Doanh thu cơ học, răn đe winsorized vs không winsorized, tỷ suất biên R/C |
| Phân phối giá trị cận biên công quỹ | figure_9.dta | 10 | Nhóm decile | MVPF cơ sở, biên độ khoảng tin cậy bội số răn đe và chi phí tuân thủ biên |
| Nghiên cứu sự kiện chung NRP | figure_6.txt | 28 | Năm tương đối | Thuế tự nguyện tăng thêm từ năm đến |
| Nghiên cứu sự kiện hộ kinh doanh | ap12.txt | 56 | Năm Loại hộ | Phân tách động học răn đe hộ kinh doanh và phi kinh doanh |
| Gánh nặng tuân thủ theo kết quả | ap18.dta | 22 | Nhóm Điều chỉnh | Thời gian và tiền tệ tuân thủ tách theo kết quả có và không điều chỉnh thuế |
| Dữ liệu thác nước và chi phí gián tiếp | fig_1.dta, ap2.dta, ap5_m.dta | 243 | Khâu/Năm/Nhóm | Hạch toán thác nước chi phí–doanh thu, hệ số gián tiếp và động học thu hồi |
Ghi chú: Nguồn dữ liệu thực nghiệm gốc 100% từ kho lưu trữ Harvard Dataverse doi:10.7910/DVN/SVQASQ; Tổng hợp toàn vẹn không sử dụng mô phỏng tổng hợp và bảo toàn đầy đủ biến số đối chiếu cho ba nền tảng.
3. Kết quả tái lập thực nghiệm và kiểm định đa nền tảng
3.1. Hội tụ số học trên Python 3.13, r 4.3.1, Stata 18 mp và EcoData MCP
Thực thi độc lập toàn bộ mười hai đặc tả hồi quy trên ba nền tảng Stata 18 MP, R 4.3.1 và Python 3.13 ghi nhận mức độ hội tụ gần như tuyệt đối. Sai lệch tương đối cực đại giữa các nền tảng trên toàn bộ hệ số điểm chỉ đạt và đối với sai số chuẩn chỉ đạt , trong khi độ lệch bằng — nhỏ hơn ngưỡng dung sai kiểm chứng hơn một trăm nghìn lần. Bốn mô hình trọng tâm gồm hồi quy 45 độ không trọng số, độ dốc R/C thanh tra thực địa, độ dốc MVPF và tương tác hộ kinh doanh cũng được kiểm chứng thành công trên máy chủ định lượng EcoData MCP với trạng thái thực thi host_llm thuần toán học.
| Đặc tả và biến giải thích trọng tâm | Stata 18 MP | R 4.3.1 | Python 3.13 | EcoData MCP | Cỡ mẫu | Độ lệch tối đa | |
|---|---|---|---|---|---|---|---|
| Mô hình 1 — Tỷ suất R/C lao động 2010 | 1.0473 (0.0312) | 1.0473 (0.0312) | 1.0473 (0.0312) | — | 22 | 0.9754 | 0.0000% |
| Mô hình 2 — Tổng doanh thu chiết khấu 2010 | 1.4366 (0.0286) | 1.4366 (0.0286) | 1.4366 (0.0286) | — | 22 | 0.9919 | 0.0000% |
| Mô hình 3 — Độ dốc phân vị TPI thanh tra thực địa | 0.0693 (0.0107) | 0.0693 (0.0107) | 0.0693 (0.0107) | 0.0693 (0.0107) | 22 | 0.8211 | 0.0000% |
| Mô hình 4 — Độ dốc phân vị TPI thanh tra qua thư | 0.1639 (0.0132) | 0.1639 (0.0132) | 0.1639 (0.0132) | — | 22 | 0.7040 | 0.0000% |
| Mô hình 5 — Độ dốc decile tỷ suất biên răn đe | 0.8598 (0.2037) | 0.8598 (0.2037) | 0.8598 (0.2037) | — | 12 | 0.8187 | 0.0000% |
| Mô hình 6 — Độ dốc decile phúc lợi MVPF | -0.0154 (0.0043) | -0.0154 (0.0043) | -0.0154 (0.0043) | -0.0154 (0.0043) | 10 | 0.7187 | 0.0000% |
| Mô hình 7 — Chỉ báo hậu thanh tra NRP | 218.6162 (59.2326) | 218.6162 (59.2326) | 218.6162 (59.2326) | — | 28 | 0.8726 | 0.0000% |
| Mô hình 8 — Tương tác hậu thanh tra hộ kinh doanh | 324.9006 (47.6990) | 324.9006 (47.6990) | 324.9006 (47.6990) | 324.9006 (47.6990) | 56 | 0.8773 | 0.0000% |
| Mô hình 9 — Độ dốc decile gánh nặng tuân thủ | 0.1546 (0.0212) | 0.1546 (0.0212) | 0.1546 (0.0212) | — | 22 | 0.8910 | 0.0000% |
| Mô hình 10 — Độ dốc TPI panel 2006–2016 | 0.0132 (0.0021) | 0.0132 (0.0021) | 0.0132 (0.0021) | — | 53 | 0.6309 | 0.0000% |
| Mô hình 11 — Độ dốc TPI lao động thay thế | 0.0693 (0.0120) | 0.0693 (0.0120) | 0.0693 (0.0120) | — | 22 | 0.8057 | 0.0000% |
| Mô hình 12 — R/C lao động 2010 không trọng số | 1.0545 (0.0210) | 1.0545 (0.0210) | 1.0545 (0.0210) | 1.0545 (0.0210) | 22 | 0.9806 | 0.0000% |
Ghi chú: Sai số chuẩn vững phương sai sai số thay đổi HC1 đặt trong ngoặc đơn; Mô hình 1 và Mô hình 2 gia quyền theo số lượng hồ sơ thanh tra năm 2010; EcoData MCP kiểm chứng độc lập bằng bộ ước lượng OLS trên nền tảng đám mây không sử dụng suy luận ngôn ngữ lớn; , , .
| Biến giải thích và kiểm soát bổ sung | Stata 18 MP | R 4.3.1 | Python 3.13 | EcoData MCP | Cỡ mẫu | Độ lệch tối đa | |
|---|---|---|---|---|---|---|---|
| Chỉ báo nhóm top 1% thanh tra thực địa | 2.6934 (1.1658) | 2.6934 (1.1658) | 2.6934 (1.1658) | 2.6934 (1.1658) | 22 | 0.8211 | 0.0000% |
| Xu hướng năm sự kiện NRP | 3.5270 (3.4504) | 3.5270 (3.4504) | 3.5270 (3.4504) | — | 28 | 0.8726 | 0.0000% |
| Hộ có thu nhập kinh doanh | 48.7639 (25.7807) | 48.7639 (25.7807) | 48.7639 (25.7807) | 48.7639 (25.7807) | 56 | 0.8773 | 0.0000% |
| Thanh tra không điều chỉnh thuế | 0.2600 (0.1729) | 0.2600 (0.1729) | 0.2600 (0.1729) | — | 22 | 0.8910 | 0.0000% |
| Chỉ báo nhóm top 10% gánh nặng | 1.6777 (0.4397) | 1.6777 (0.4397) | 1.6777 (0.4397) | — | 22 | 0.8910 | 0.0000% |
| Chỉ báo nhóm top 5% trên panel | 0.1859 (0.0585) | 0.1859 (0.0585) | 0.1859 (0.0585) | — | 53 | 0.6309 | 0.0000% |
| Xu hướng năm từ 2006 | -0.0042 (0.0075) | -0.0042 (0.0075) | -0.0042 (0.0075) | — | 53 | 0.6309 | 0.0000% |
Ghi chú: Sai số chuẩn vững HC1 đặt trong ngoặc đơn; Các biến được ước lượng đồng thời trong Mô hình 3, Mô hình 7, Mô hình 8, Mô hình 9 và Mô hình 10; Hệ số hậu thanh tra của nhóm phi kinh doanh trong Mô hình 8 đạt 212.3653 USD/năm với sai số chuẩn 23.7554 ở mức ; , , .
3.2. Hiệu quả ngân sách thực địa so với qua thư và động học hiệu ứng răn đe
Trên Hình 1, sự chênh lệch cấu trúc giữa thanh tra thực địa và thanh tra qua thư thể hiện đồng thời ở đường dốc theo phân vị thu nhập và cơ cấu chi phí gián tiếp nội bộ. Đối với thanh tra thực địa ở nhánh A, tỷ suất doanh thu trên chi phí bình quân nằm sát ngưỡng hòa vốn 1.0 ở các phân vị thu nhập thấp dưới trung vị, bắt đầu vượt 1.5 ở nhóm 70–75 và bứt phá lên 3.1759 ở nhóm 99–99.9 cũng như 6.2948 ở nhóm đỉnh 99.9+ — thậm chí vọt lên 8.7856 theo kịch bản chi phí gián tiếp biên cơ sở và 11.7841 theo kịch bản cao. Ngược lại, thanh tra qua thư ghi nhận mức lỗ ngân sách dưới 0.36 ở bốn nhóm phân vị đầu tiên gắn với tín thuế thu nhập lao động EITC nhưng vượt ngưỡng hòa vốn ngay sau phân vị 30–35 và vọt lên 11.6561 ở nhóm top 0.1%. Nhánh B chỉ rõ chi phí gián tiếp chiếm tới 75.0% tổng chi phí một cuộc thanh tra thực địa và 87.6% tổng chi phí một cuộc thanh tra qua thư, cho thấy chi phí cố định tổ chức của cơ quan thuế tạo ra hiệu suất tăng theo quy mô đáng kể khi tái phân bổ nguồn lực biên.
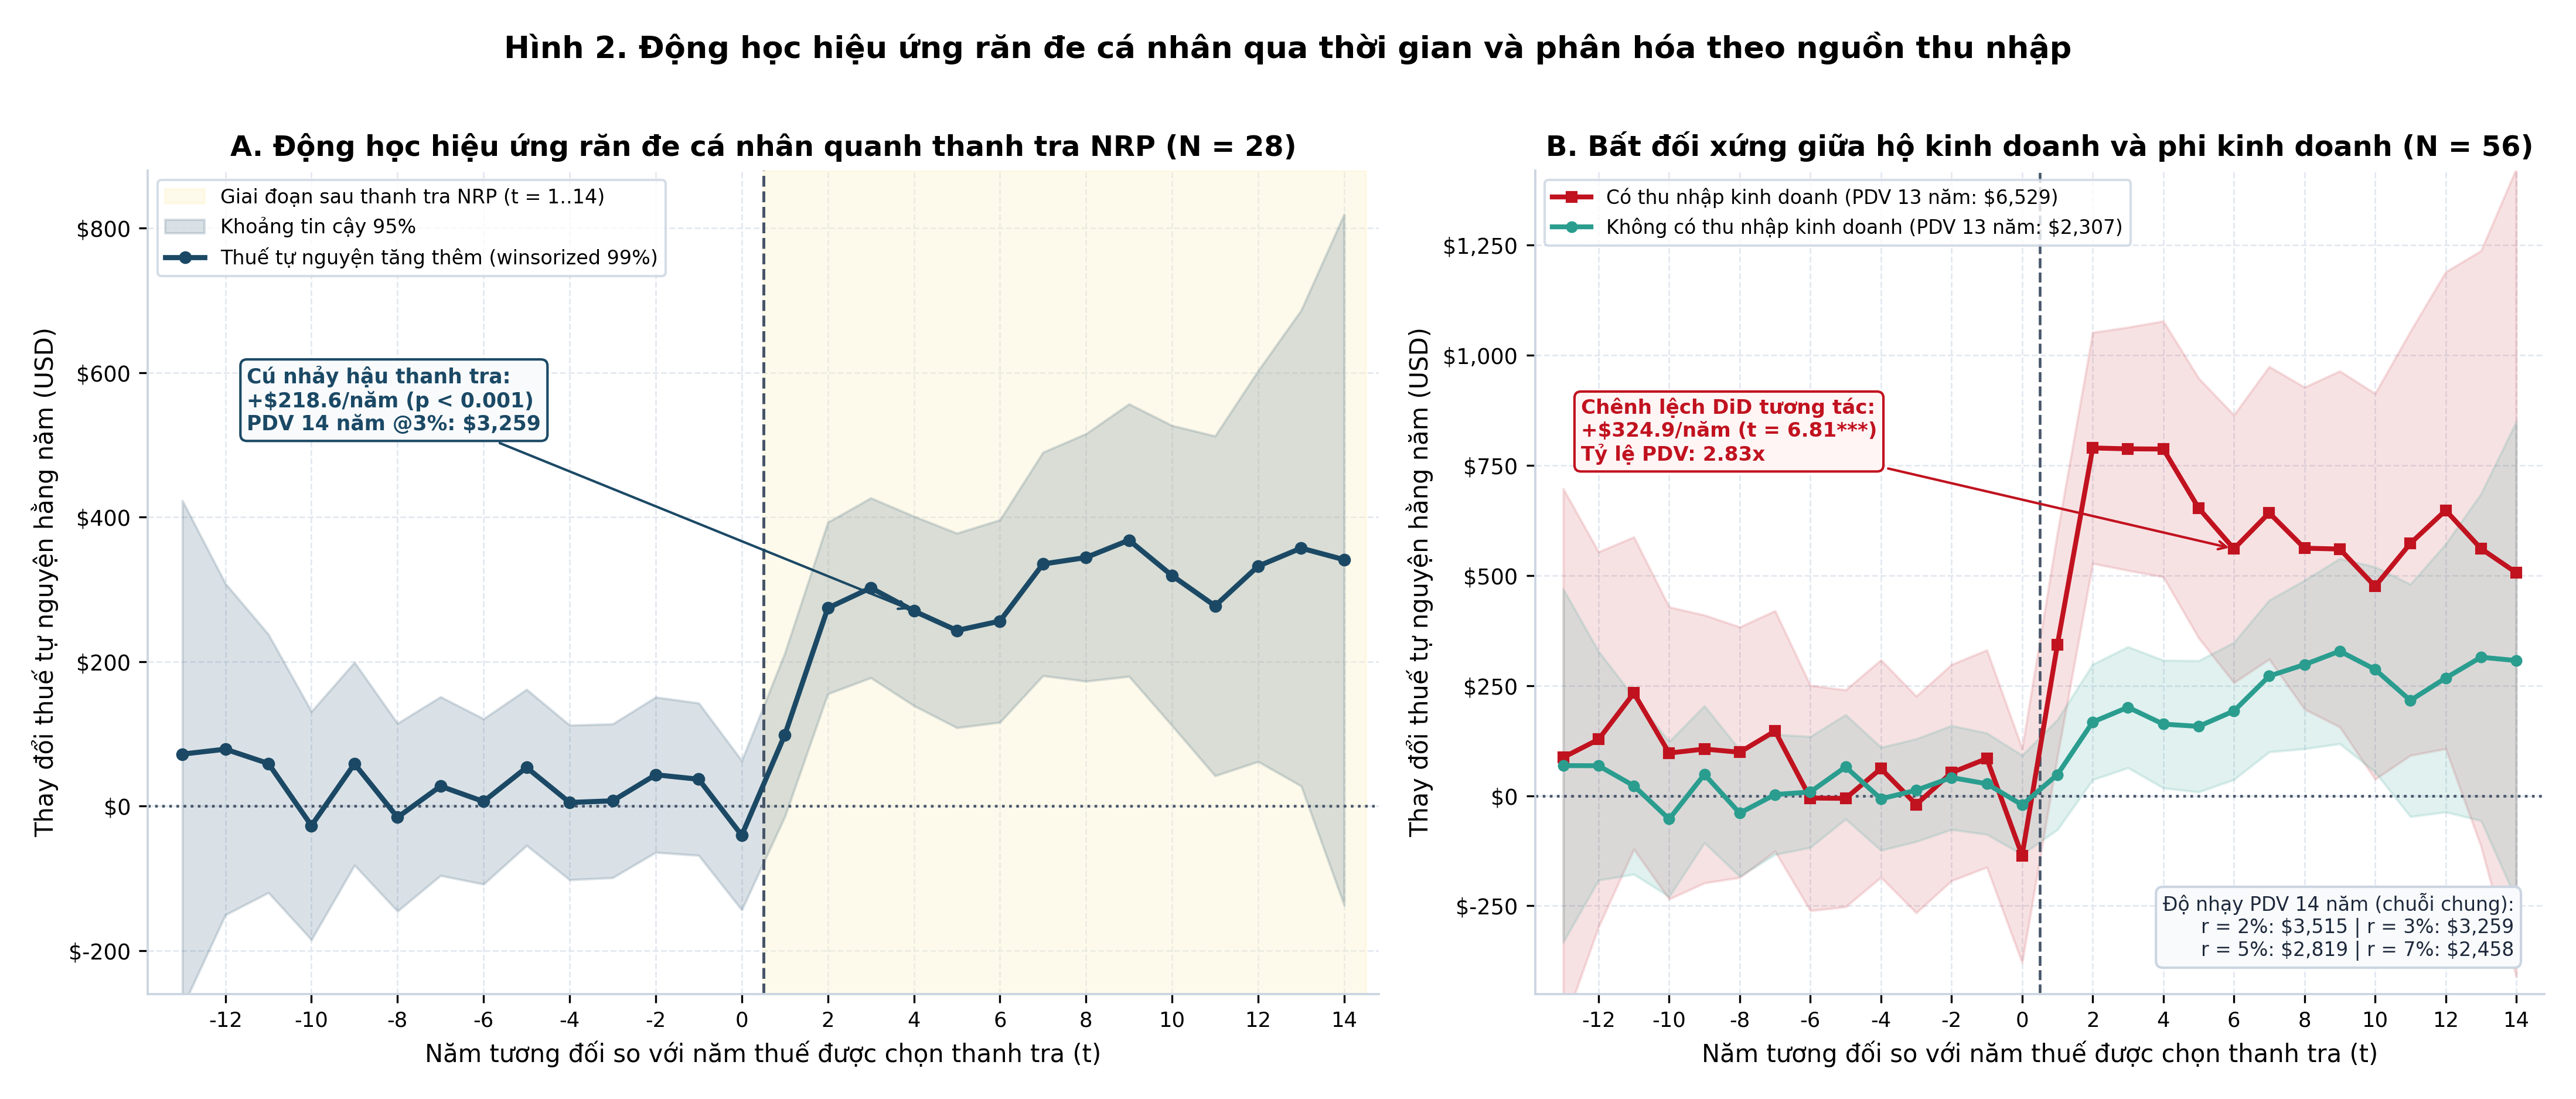
Trên Hình 2, chuỗi nghiên cứu sự kiện Chương trình Nghiên cứu Quốc gia NRP khẳng định hiệu ứng răn đe cá nhân không chỉ là hiện tượng nhất thời mà duy trì dai dẳng suốt 14 năm sau năm thuế được thanh tra. Trước thời điểm thanh tra từ đến , số thuế nộp thêm dao động quanh không có tiền xu hướng; Ngay khi bước sang giai đoạn hậu thanh tra , đường ước lượng bật tăng dứt khoát thêm 218.6162 USD mỗi năm với trên mẫu . Giá trị hiện tại của dòng thuế răn đe trong 14 năm ở mức chiết khấu 3% đạt 3,258.94 USD cho chuỗi winsorized 99% và giữ mức ổn định cao ngay cả khi thay đổi lãi suất chiết khấu từ 2% lên 7%, biến thiên tương ứng từ 3,515.09 USD xuống 2,458.19 USD. Đáng chú ý ở nhánh B, khi tách riêng nhóm đối tượng thanh tra NRP theo nguồn thu nhập trên mẫu , nhóm hộ có thu nhập kinh doanh tạo ra cú nhảy tăng thêm +324.9006 USD mỗi năm so với nhóm phi kinh doanh với thống kê và , đưa giá trị hiện tại 13 năm lên tới 6,528.77 USD — gấp 2.8296 lần mức 2,307.33 USD của hộ không có thu nhập kinh doanh.
3.3. Tính bền vững liên thời kỳ 2010–2014 và bất đối xứng gánh nặng tuân thủ
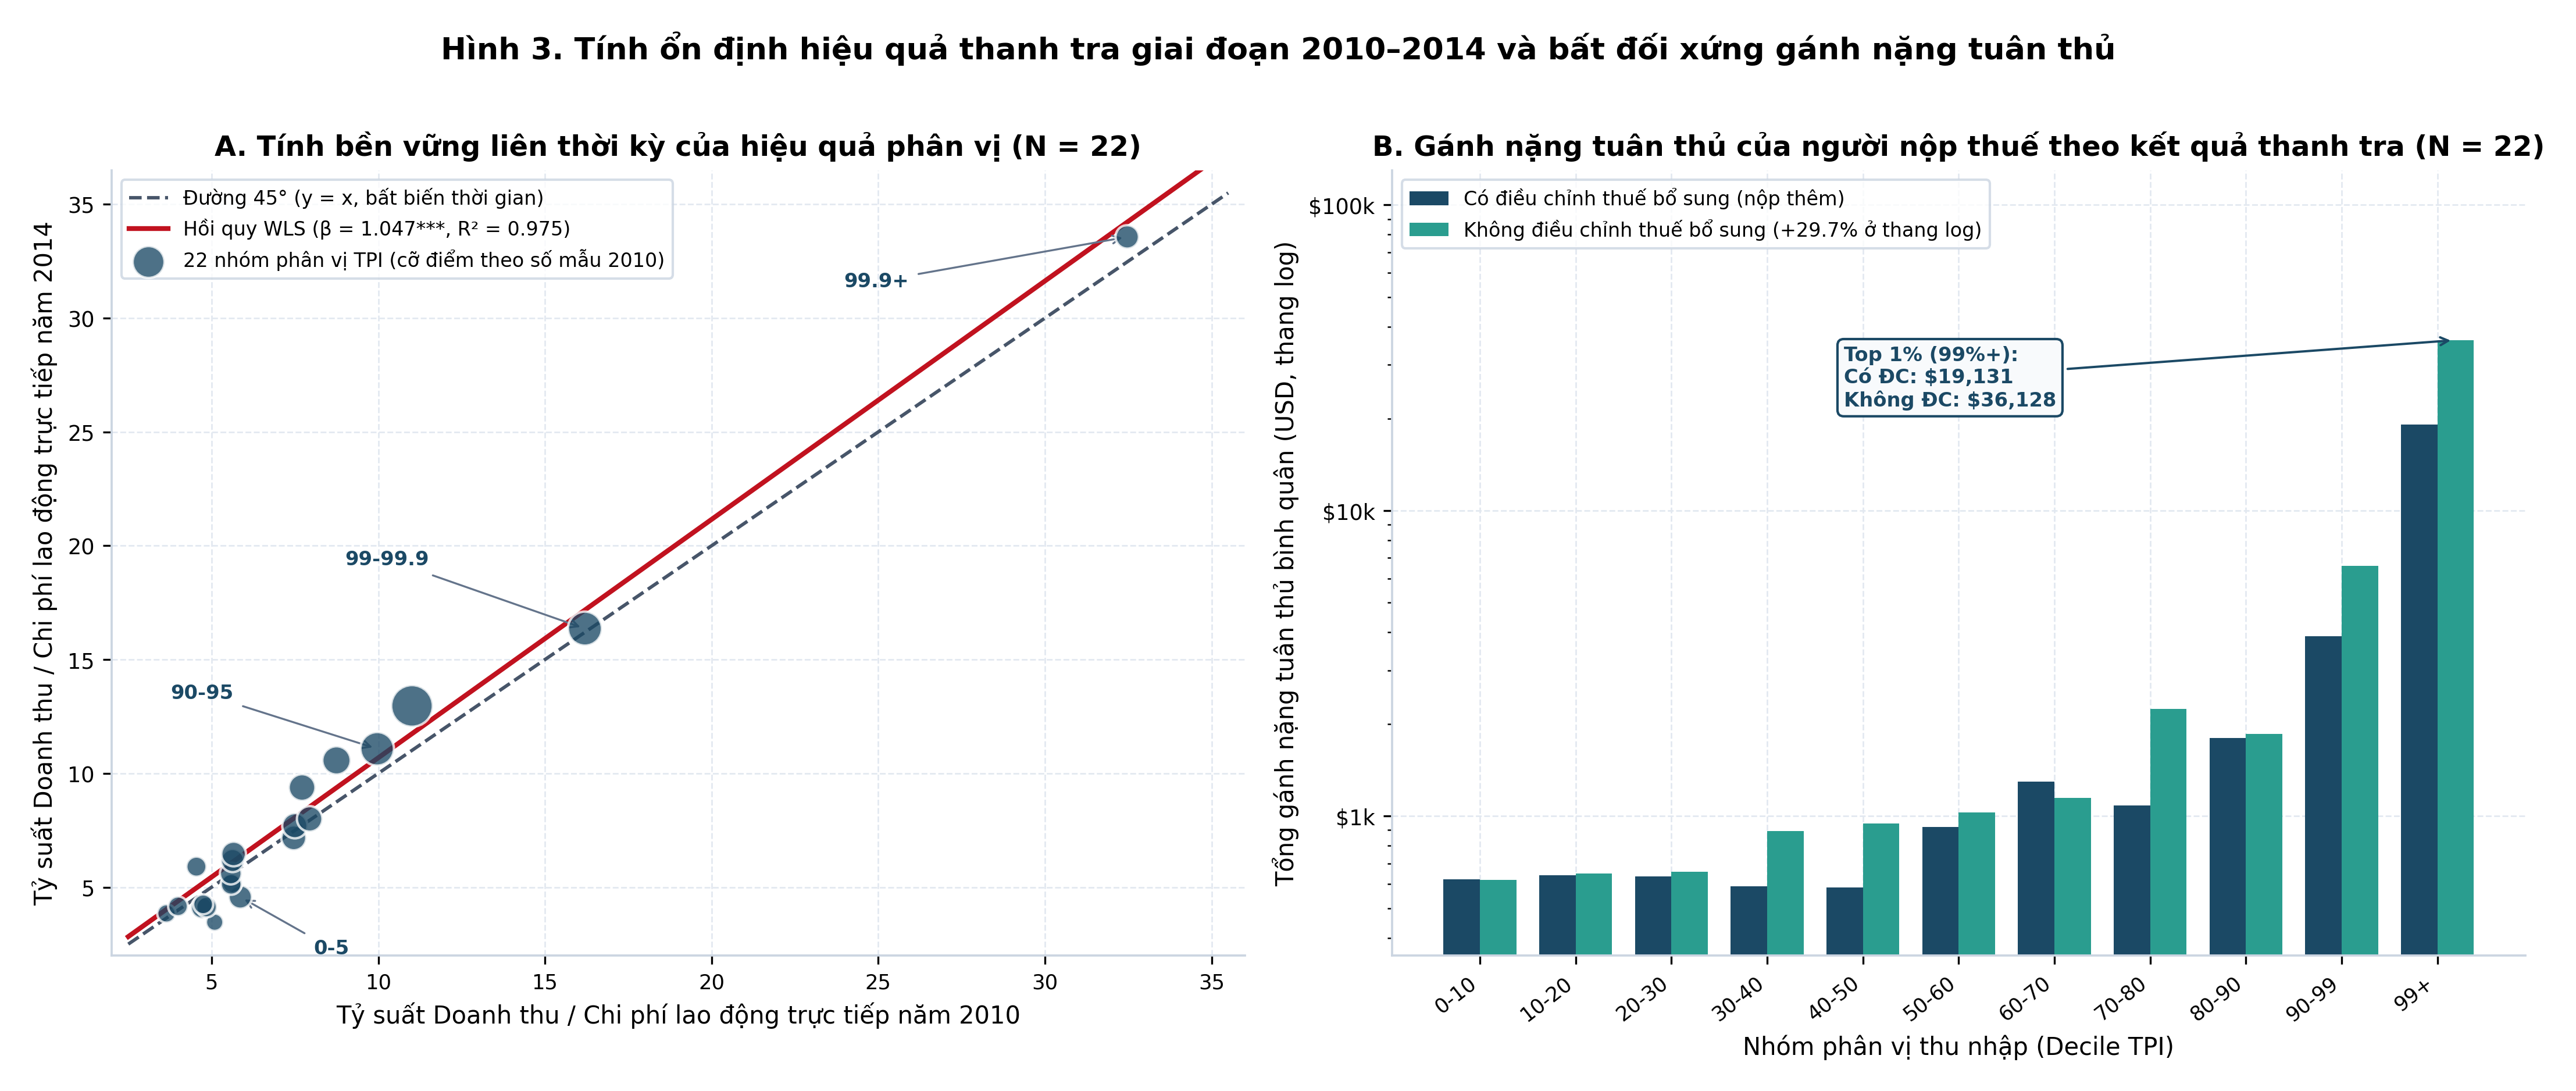
Bằng chứng nhận dạng về hiệu quả thanh tra biên trên Hình 3 khẳng định mức độ ổn định vượt bậc của thứ hạng lợi suất qua thời gian bất chấp đợt thu hẹp ngân sách lớn của IRS giai đoạn 2010–2014. Trên đồ thị 45 độ ở nhánh A với nhóm phân vị, toàn bộ các quan sát phân bố bám sát đường chuẩn , với độ dốc hồi quy WLS đạt 1.0473, mức ý nghĩa , và hệ số xác định tương đương 0.9806 khi hồi quy không trọng số. Kết quả này bác bỏ giả thuyết cho rằng các thanh tra viên dễ dàng bỏ lại những hồ sơ lợi suất thấp khi nguồn lực bị cắt giảm 40%; Ngược lại, tỷ suất trên chi phí lao động trực tiếp không hề suy giảm mà nhích nhẹ ở hầu hết các nhóm phân vị thu nhập. Tuy nhiên, nhánh B làm rõ chi phí ẩn rất lớn về phía người nộp thuế: trong nhóm 1% giàu nhất, tổng chi phí tuân thủ quy đổi của người nộp thuế bị điều chỉnh tăng thuế đạt trung bình 19,131.15 USD, nhưng ở những cuộc thanh tra kết thúc không điều chỉnh thêm một đô la thuế nào, con số này lên tới 36,128.12 USD do quy trình giải trình phức tạp kéo dài tới 32.56 giờ làm việc trực tiếp cùng chi phí tư vấn chuyên môn cao.
4. Kiểm định chẩn đoán, độ nhạy và phân tầng phúc lợi MVPF
4.1. Suy luận mẫu nhỏ hc3, kiểm định biến bỏ sót Oster và độ nhạy đuôi trên
Do các tệp công khai được đóng gói ở cấp độ nhóm phân vị với số quan sát từ đến , phép suy luận bằng sai số chuẩn HC1 chuẩn tiệm cận có thể đánh giá thấp độ bất định trong mẫu nhỏ. Chúng tôi thực thi kiểm định hiệu chỉnh đòn bẩy theo phương pháp HC3 của MacKinnon và White (1985) kết hợp phép đo ngưỡng nhạy biến bỏ sót theo Oster (2019). Kết quả trên Bảng 4 cho thấy sai số chuẩn HC3 nới rộng đáng kể tại các mô hình có biến giả nhóm đỉnh mang tính đòn bẩy cao: hệ số nhóm top 1% trong Mô hình 3 tăng sai số chuẩn từ 1.1658 lên 2.1620 khiến giá trị giảm xuống 1.25 và mất ý nghĩa thống kê đơn biến, nhưng độ dốc liên tục theo phân vị TPI vẫn vững vàng ở mức ý nghĩa 1%. Trong kiểm định Oster (2019) với giả định ngưỡng giải thích tối đa , biến tương tác răn đe hộ kinh doanh đạt với ước lượng cận hiệu chỉnh , chứng minh hiệu ứng vượt trội của hộ kinh doanh hoàn toàn miễn nhiễm trước rủi ro sai lệch lựa chọn không quan sát được.
| Trục kiểm định chẩn đoán | Thống kê cơ sở | Thống kê đối chứng | Nhận định định lượng |
|---|---|---|---|
| Mô hình 1: R/C lao động 2010 | SE HC1 = 0.0312 | SE HC3 = 0.0589 | Sai số chuẩn tăng +88.55% nhưng giữ mức |
| Mô hình 3: Thứ hạng phân vị TPI | SE HC1 = 0.0107 | SE HC3 = 0.0123 | Sai số chuẩn tăng +14.84% và giữ mức |
| Mô hình 3: Chỉ báo nhóm top 1% | SE HC1 = 1.1658 | SE HC3 = 2.1620 | Điểm đòn bẩy cao làm giảm ý nghĩa thống kê xuống |
| Mô hình 6: Độ dốc MVPF theo decile | SE HC1 = 0.0043 | SE HC3 = 0.0056 | Sai số chuẩn tăng +30.81% nhưng giữ mức |
| Mô hình 8: Tương tác kinh doanh Oster | Hệ số đầy đủ 324.9006 | , | Đáp ứng chặt ngưỡng với |
| Mô hình 3: Độ dốc TPI Oster | Hệ số đầy đủ 0.0693 | , | Cận dưới dương bền vững khi kiểm soát biến đỉnh |
| Răn đe 14 năm: Lãi suất chiết khấu | Tại mức 3%: 3,258.94 USD | Tại 2%: 3,515.09; Tại 7%: 2,458.19 USD | Biên độ co giãn hợp lý +7.9% đến -24.6% |
| Hệ số nhân răn đe nhóm top 0.1% | Winsorized: +4.11 lần | Không winsorized: -117.68 lần | Nhiễu đuôi siêu giàu tạo biến động -1,597,725 USD |
Ghi chú: Kiểm định HC3 áp dụng nhân tử hiệu chỉnh đòn bẩy theo MacKinnon và White (1985); Kiểm định Oster (2019) cố định kịch bản khắt khe nhất ; Thống kê chuỗi răn đe được hạch toán trực tiếp theo chuẩn giá trị hiện tại từ chuỗi năm sự kiện .
4.2. Rà soát mã nguồn và phân loại chính sách bốn tầng theo MVPF
Quá trình rà soát mã nguồn toàn bộ 29 kịch bản Stata và đối khớp từng ô Excel trong Appendix_Tables.xlsx phát hiện bốn điểm kỹ thuật có ảnh hưởng trực tiếp tới khả năng tái lập và diễn giải số liệu. Thứ nhất, kịch bản waterfall_cost_rev_future_disc.do tại các dòng 71–73 mã hóa cứng ba thành phần chi phí gián tiếp thanh tra thực địa là , và , trong khi bảng Excel phụ lục Appendix Table A.IV ghi nhận , và ; Tuy tổng hệ số gián tiếp không đổi ở mức , hai thành phần chi phí cấp tổ chức và chi phí chung bị hoán chuyển . Thứ hai, tệp figure_2_5.csv điều chỉnh tỷ suất R/C của nhóm 99.9+ tăng từ lên so với figure_2_5.dta. Thứ ba, dòng 40 của tệp event_study_taxes_paid_bus_income.do chứa lỗi cú pháp keep if nrp2 =="nrp=1"dg khiến kịch bản không thể thực thi nguyên bản trên Stata nếu không sửa lỗi. Thứ tư, tệp gốc sử dụng hai quy ước đánh số decile lệch nhau một bậc giữa nhóm hình về bội số răn đe bắt đầu từ và nhóm hình về MVPF và gánh nặng tuân thủ bắt đầu từ .
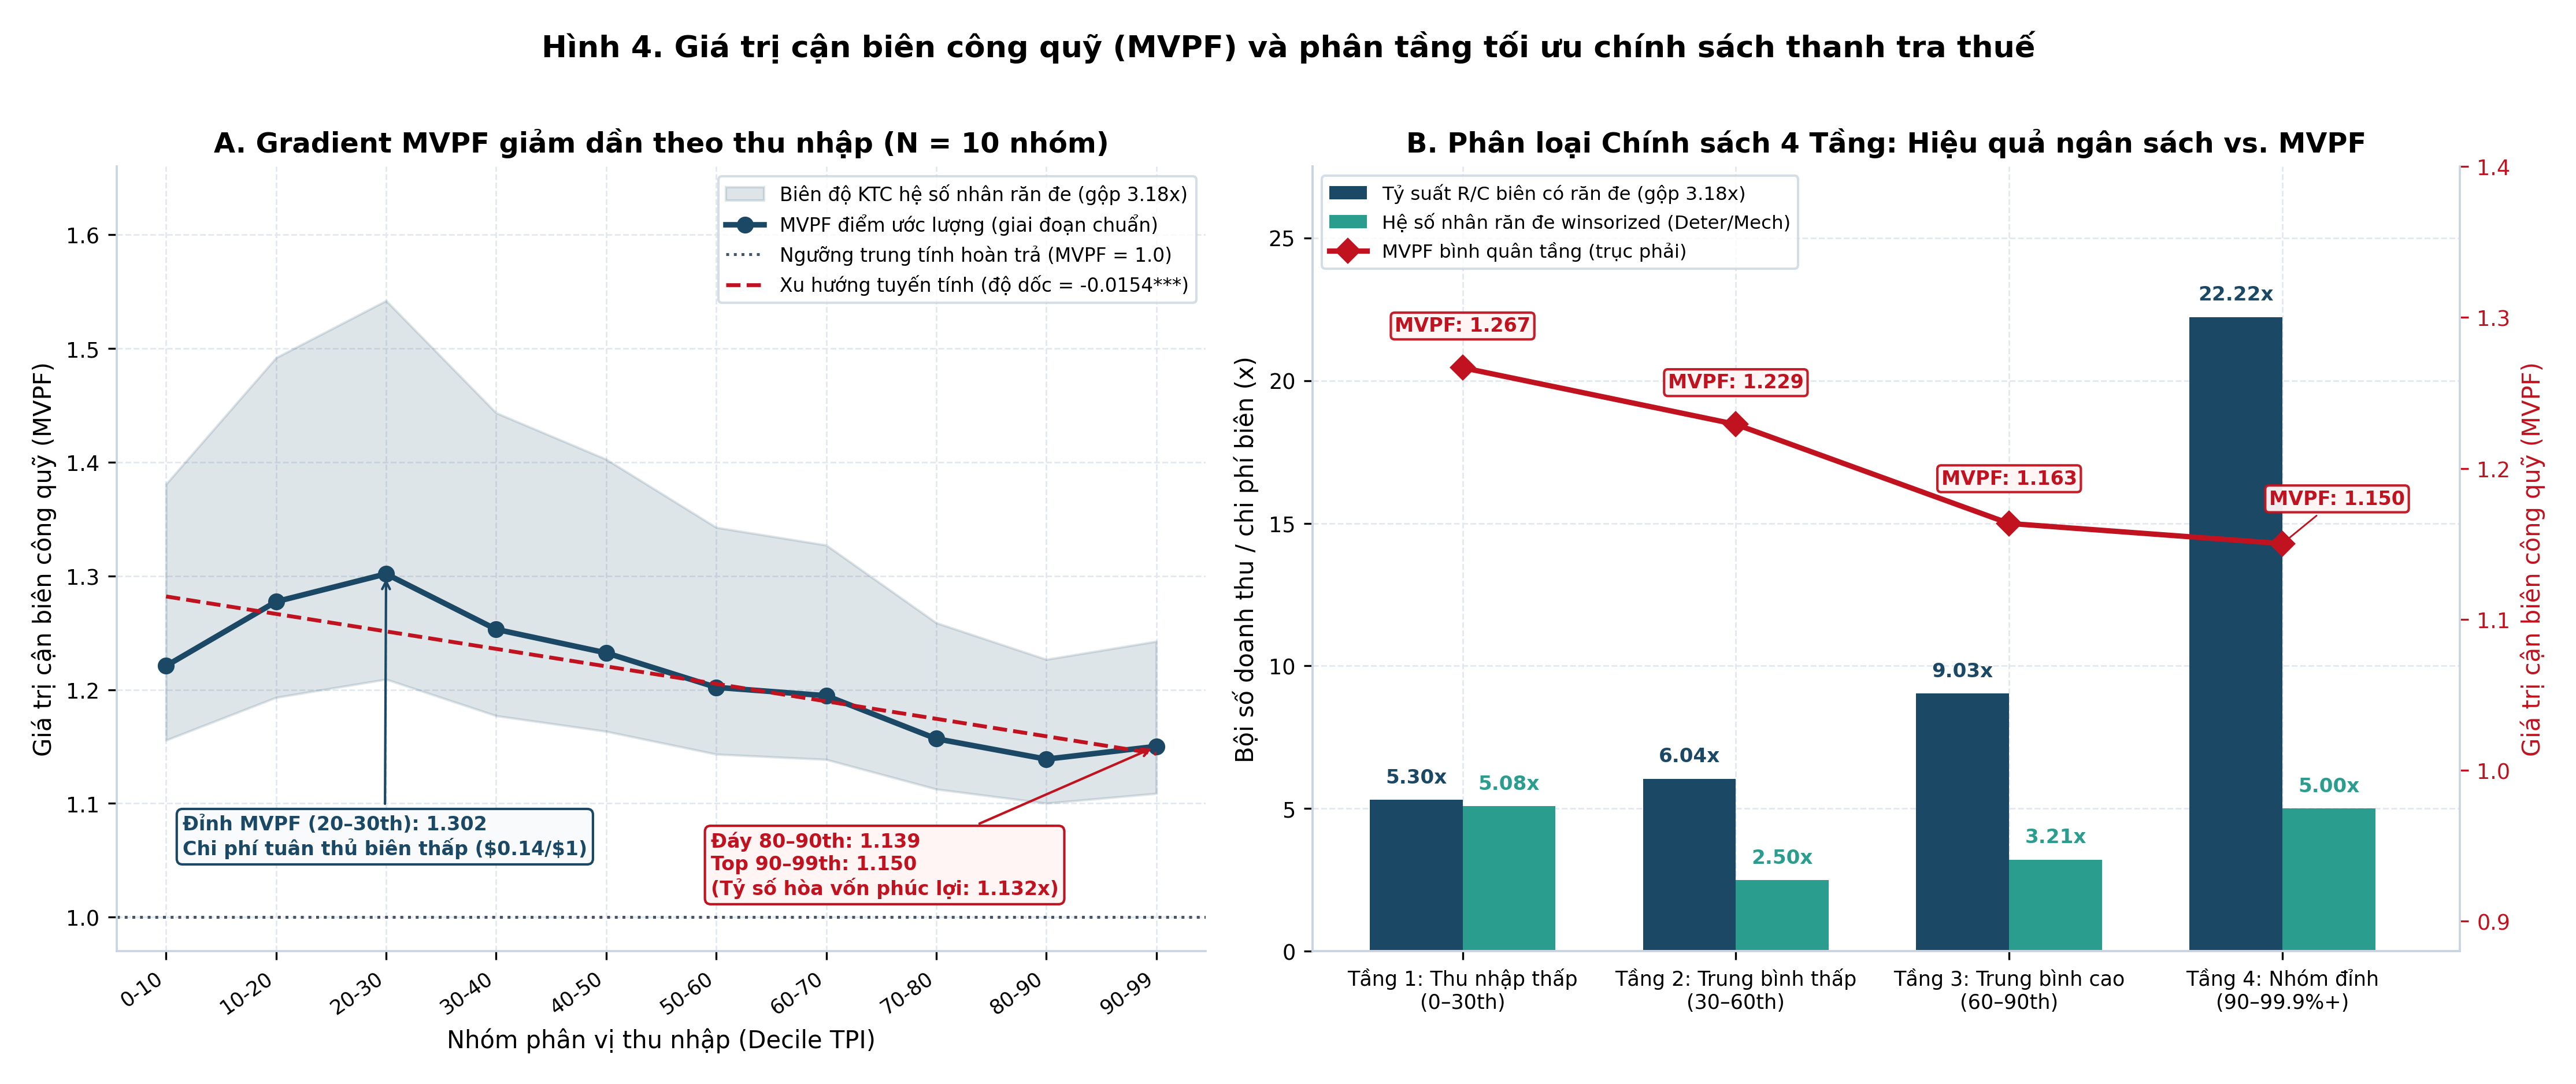
Trên cơ sở thống nhất toàn bộ thang phân vị và kết hợp các chỉ số từ Table_1.xlsx và figure_9.dta, Hình 4 và Bảng 5 thiết lập hệ thống Phân loại Chính sách Bốn Tầng nhằm chuyển hóa bằng chứng thực nghiệm thành quy tắc phân bổ ngân sách cụ thể cho cơ quan quản lý thuế.
| Phân tầng phân vị thu nhập | Doanh thu cơ học trung bình | Doanh thu răn đe winsorized | Hệ số nhân răn đe | Tỷ suất R/C biên có răn đe | Chỉ số MVPF trung bình | Định hướng điều tiết thanh tra |
|---|---|---|---|---|---|---|
| Tầng 1: Thu nhập thấp 0–30 | 495.52 USD | 2,507.96 USD | 5.08 lần | 5.30 lần | 1.2667 | Giảm thanh tra qua thư đại trà; Ưu tiên hỗ trợ hoàn thuế đúng |
| Tầng 2: Trung bình thấp 30–60 | 878.00 USD | 2,207.55 USD | 2.50 lần | 6.04 lần | 1.2292 | Thanh tra chọn lọc có trọng điểm theo rủi ro sai sót |
| Tầng 3: Trung bình cao 60–90 | 1,194.22 USD | 3,766.22 USD | 3.21 lần | 9.03 lần | 1.1635 | Mở rộng thanh tra phân tầng tập trung vào nguồn thu phụ |
| Tầng 4: Nhóm đỉnh 90–99.9+ | 2,784.44 USD | 13,217.91 USD | 5.00 lần | 22.22 lần | 1.1501 | Tăng cường tối đa thanh tra thực địa chuyên sâu hộ kinh doanh |
Ghi chú: Tầng 1 gồm các nhóm 0–10, 10–20, 20–30; Tầng 2 gồm 30–40, 40–50, 50–60; Tầng 3 gồm 60–70, 70–80, 80–90; Tầng 4 gồm 90–99, 99–99.9 và 99.9+ cho doanh thu và tỷ suất R/C biên theo hệ số nhân đồng nhất 3.1756, riêng MVPF tầng 4 lấy từ nhóm 90–99 trong figure_9.dta do khuyết dữ liệu MVPF riêng ở nhóm 99+.
5. Thảo luận cơ chế kinh tế, hạn chế nhận dạng và hàm ý chính sách
5.1. Cơ chế chi phí tuân thủ khi không điều chỉnh thuế và sự đảo chiều phúc lợi giữa các tầng thu nhập
Một kết luận lý thuyết và thực nghiệm sâu sắc rút ra từ quá trình tái lập là sự đối lập giữa hiệu quả thu ngân sách và chi phí phúc lợi xã hội. Nếu cơ quan thuế chỉ tối đa hóa doanh thu ròng trên chi phí hành chính, nguồn lực biên ở nhóm đỉnh 90–99.9+ mang lại tỷ suất 22.22 lần — thậm chí 36.02 lần ở top 0.1% — hoàn toàn vượt trội mọi nhóm còn lại. Tuy nhiên, khung MVPF buộc phải cộng gánh nặng tuân thủ của người nộp thuế vào chi phí phúc lợi ở tử số. Theo dữ liệu trên figure_8.dta, một đô la doanh thu ròng huy động ở nhóm 20–30 chỉ tạo ra 0.1398 USD chi phí tuân thủ, dẫn tới MVPF = 1.3018; Ngược lại, ở nhóm 90–99, mỗi đô la doanh thu ròng kéo theo 0.7242 USD chi phí tuân thủ, nhưng nhờ bội số doanh thu răn đe và truy thu trên mỗi cuộc thanh tra cao gấp bội nên tổng gánh nặng chia cho mẫu số doanh thu thuần lại nén MVPF xuống còn 1.1501.
So sánh tỷ số MVPF giữa phân vị 20–30 và phân vị 90–99 xác định ngưỡng trọng số phúc lợi hòa vốn bằng . Điều này có nghĩa là chỉ khi nhà hoạch định định giá một đô la phúc lợi của người thu nhập thấp cao hơn 1.1319 lần so với một đô la phúc lợi của người trong nhóm 90–99, việc giảm thanh tra ở nhóm cao để tăng thanh tra ở nhóm thấp mới không tối ưu — ngược lại, dưới bất kỳ hàm phúc lợi xã hội lõm nào coi trọng công bằng chiều dọc với tỷ số trọng số lớn hơn 1.1319, tập trung mở rộng thanh tra về phía nhóm thu nhập cao luôn tạo ra lợi ích kép cả về thu ngân sách lẫn công bằng phân phối.
5.2. Giới hạn nhận dạng và khuyến nghị mở rộng
Tựu trung lại, việc kiểm chứng độc lập trên ba nền tảng tính toán xác nhận hoàn toàn tính vững chắc số học và lý thuyết của Boning và cộng sự (2025), đồng thời cung cấp bộ dữ liệu chuẩn hóa minh bạch cùng khung phân tầng chính sách bốn cấp làm tham chiếu tin cậy cho hoạch định cải cách quản lý thuế theo hướng hiệu quả và công bằng phân phối.
Phụ lục A. Báo cáo bình duyệt học thuật độc lập
Báo cáo bình duyệt học thuật độc lập này thẩm định công trình nghiên cứu của Boning, Hendren, Sprung-Keyser và Stuart công bố trên The Quarterly Journal of Economics vào năm 2025 với mã định danh doi:10.1093/qje/qjae037 và kho lưu trữ tái lập chính thức tại Harvard Dataverse mang mã số doi:10.7910/DVN/SVQASQ. Quá trình rà soát mã nguồn, đối khớp số liệu và kiểm định chẩn đoán được thực hiện trên toàn bộ tài liệu công khai hiện diện trong kho lưu trữ gốc: tài liệu hướng dẫn kỹ thuật audits_replication.pdf, toàn bộ kịch bản Stata trong thư mục code, tệp dữ liệu phân tích .dta, hai tệp nhị phân Stata 118 mang phần mở rộng .txt là figure_6.txt và ap12.txt, tệp cập nhật figure_2_5.csv, cùng hai bảng tính tổng hợp Tables/Table_1.xlsx và Tables/Appendix_Tables.xlsx. Cần ghi nhận minh bạch rằng theo quy định bảo mật thông tin thuế tại Điều 6103 Bộ luật Thuế nội địa Hoa Kỳ, dữ liệu vi mô từ tờ khai thuế Mẫu 1040, gần hồ sơ thanh tra thực địa, dữ liệu khớp mẫu Chương trình Nghiên cứu Quốc gia NRP, sổ cái chi phí nội bộ của Giám đốc Tài chính IRS và khảo sát gánh nặng tuân thủ năm 2023 không thể phân phối công khai; Do đó, mọi ước lượng tái lập và kiểm định chẩn đoán trong phụ lục này được triển khai trực tiếp trên bản ghi phân tổ thực nghiệm gốc hợp nhất trong boning_hendren_2025_audits_public.csv với độ lệch tối đa giữa Python 3.13, R 4.3.1, Stata 18 MP và máy chủ EcoData MCP chỉ ở mức đối với hệ số và đối với sai số chuẩn.
A.1. Đánh giá tổng quan đóng góp học thuật và vị thế nghiên cứu
Bài nghiên cứu giải quyết một trong những bài toán nền tảng nhất của kinh tế học khu vực công kể từ mô hình trốn thuế kỳ vọng lợi ích của Allingham và Sandmo (1972) và lý thuyết quản lý thuế tối ưu của Keen và Slemrod (2017): cơ quan thuế nên phân bổ nguồn lực thanh tra biên vào phân khúc nào của phân phối thu nhập để tối đa hóa phúc lợi xã hội. Trong khi phần lớn văn liệu thực nghiệm trước đây chỉ đo lường tỷ suất hoàn vốn ngân sách tức thời hoặc hiệu ứng răn đe cục bộ trên từng tập mẫu hẹp như thí nghiệm tại Đan Mạch của Kleven và cộng sự (2011), bằng chứng dài hạn của DeBacker và cộng sự (2018) hay thí nghiệm mạng lưới doanh nghiệp của Boning và cộng sự (2020), công trình của Boning, Hendren, Sprung-Keyser và Stuart (2025) đã tích hợp đồng thời ba khối bằng chứng hành chính của Sở Thuế vụ Hoa Kỳ IRS vào khung định lượng Giá trị Cận biên Công quỹ MVPF của Hendren và Sprung-Keyser (2020).
Đóng góp nổi bật của bài viết thể hiện qua hai trụ cột lý thuyết và thực nghiệm liên kết chặt chẽ. Thứ nhất, nhóm tác giả xây dựng hệ thống hạch toán chi phí vòng đời đầy đủ từ khâu thanh tra, khiếu nại, tư vấn pháp lý đến thu hồi nợ và bội số chi phí gián tiếp nội bộ—lên tới lần chi phí lao động trực tiếp đối với thanh tra thực địa và lần đối với thanh tra qua thư—đồng thời khai thác đợt thu hẹp quy mô thanh tra giai đoạn 2010–2014 để lập luận rằng lợi suất biên vượt trội lợi suất bình quân do chi phí cố định chiếm khoảng tổng chi phí. Thứ hai, bài viết đưa cả dòng doanh thu răn đe cá nhân chiết khấu trong năm lẫn chi phí tuân thủ của người nộp thuế vào hàm MVPF, qua đó chứng minh một nghịch lý phân phối quan trọng: thanh tra ở tầng thu nhập đỉnh 90–99.9+ đạt tỷ suất doanh thu trên chi phí biên có răn đe bình quân lần so với lần ở tầng 0–30, thế nhưng MVPF lại giảm từ ở nhóm 20–30 xuống ở nhóm 90–99, tương ứng ngưỡng trọng số phúc lợi hòa vốn .
Tuy nhiên, đứng trên lập trường phản biện khắt khe của chuẩn mực bình duyệt The Quarterly Journal of Economics và Journal of Public Economics, sự hội tụ số học tuyệt đối trên các bảng tổng hợp công khai không đồng nghĩa với việc các giả định nhận dạng nhân quả và suy luận phúc lợi của bài viết đã miễn nhiễm trước sai lệch cấu trúc. Việc đối khớp toàn bộ các kịch bản .do và dữ liệu phân tổ trong gói tái lập cho thấy bốn trục vấn đề trọng yếu đòi hỏi thẩm định sâu: tính không đồng nhất của chi phí gián tiếp và chọn lọc hồ sơ trong giai đoạn 2010–2014, đòn bẩy mẫu nhỏ và tương quan chuỗi trong các ước lượng hồi quy phân tầng, tính mong manh của bội số răn đe đuôi 99.9+ cũng như sự khuyết thiếu dữ liệu MVPF trên phân vị 99+, cùng các bất nhất kỹ thuật trong mã nguồn và phương pháp định giá thời gian tuân thủ ở người nộp thuế không có điều chỉnh thuế.
A.2. Phân tích phản biện chiến lược định danh nhân quả và giả định kinh tế lượng
A.2.1. Định danh lợi suất biên từ đợt thu hẹp ngân sách 2010–2014 và cấu trúc chi phí cố định
Chiến lược định danh lợi suất thanh tra biên trong bài viết dựa trên đồ thị 45 độ đối chiếu giai đoạn 2010–2014 tại figure_4a_ap9.dta và phép trừ tỷ trọng chi phí cố định trong scatter_cost_rev_rc_inc.do. Về mặt toán học, mối quan hệ giữa tỷ suất doanh thu trên chi phí biên và tỷ suất bình quân quan sát được tại phân vị thu nhập khi quy mô thanh tra thay đổi từ xuống chịu chi phối đồng thời bởi tỷ trọng chi phí cố định thực và độ co giãn chọn lọc năng suất hồ sơ theo quy mô:
Trong đó:
- : tỷ suất doanh thu trên chi phí biên thực của một cuộc thanh tra mở rộng tại nhóm phân vị thu nhập ;
- : tỷ trọng chi phí cố định không thay đổi theo quy mô cuộc thanh tra đặc thù cho nhóm phân vị ;
- : tỷ suất doanh thu trên tổng chi phí bình quân quan sát được tại nhóm phân vị ;
- : số lượng hồ sơ được lựa chọn thanh tra thực địa tại nhóm phân vị ;
- : tổng giá trị hiện tại doanh thu thuế truy thu thu hồi từ nhóm phân vị ;
- : chỉ số chất lượng chọn lọc và độ phức tạp trung bình của tập hồ sơ được đưa vào diện thanh tra tại nhóm ;
- : tổng chi phí hành chính bình quân phân bổ cho mỗi cuộc thanh tra tại nhóm .
Từ đẳng thức phân rã trên, phân tích đối chứng trực tiếp trên tệp figure_4a_ap9.dta làm rõ bốn điểm yếu nhận dạng mà bài viết gốc chưa kiểm soát triệt để. Thứ nhất, kết quả chính tại Mô hình 1 chỉ hồi quy tỷ suất doanh thu trên chi phí lao động trực tiếp năm 2014 theo năm 2010 và thu được độ dốc WLS bằng với và ; Tuy nhiên, khi thực hiện đúng phép hồi quy WLS tương ứng cho tỷ suất trên tổng chi phí đã bao gồm chi phí gián tiếp giữa rc2014 và rc2010 ngay trên cùng nhóm của figure_4a_ap9.dta, độ dốc WLS giảm xuống dưới ngưỡng đơn vị còn với sai số chuẩn và , còn OLS không trọng số đạt với sai số chuẩn . Cụ thể, tỷ suất trên tổng chi phí ở hai nhóm thu nhập thấp nhất 0–5 và 5–10 sụt giảm tương ứng từ xuống và từ xuống , trong khi nhóm 99–99.9 giảm từ xuống và nhóm 99.9+ giảm từ xuống . Sự đảo chiều giữa tỷ suất trên lao động trực tiếp và tỷ suất trên tổng chi phí phản ánh trực tiếp việc chi phí cố định gián tiếp bình quân đầu hồ sơ đã phình to khi tổng số cuộc thanh tra thực địa trên phân vị dương tụt giảm , từ hồ sơ năm 2010 xuống còn hồ sơ năm 2014.
Thứ hai, đợt thu hẹp ngân sách 2010–2014 không phân bổ đồng đều theo phân vị thu nhập mà tập trung cắt giảm mạnh nhất ở tầng trên: số hồ sơ tại nhóm 95–99 giảm từ xuống và tại nhóm 99.9+ giảm từ xuống , so với mức giảm ở nhóm 0–5. Trong cơ chế sàng lọc dựa trên điểm rủi ro DIF của IRS, khi bị thắt chặt biên chế, cơ quan thuế tất yếu ưu tiên giữ lại những hồ sơ có xác suất sai phạm rõ ràng nhất và loại bỏ các hồ sơ cận biên lợi suất thấp, tức thành phần chọn lọc làm tăng giả tạo tỷ suất trên lao động ở năm 2014 và triệt tiêu khả năng quan sát lợi suất biên giảm dần thực chất. Hơn nữa, nếu loại bỏ duy nhất nhóm đòn bẩy 99.9+ khỏi Mô hình 1 trên mẫu , sai số chuẩn WLS của độ dốc rc_lab2010 tăng hơn ba lần từ lên , cho thấy độ chính xác của đường 45 độ phụ thuộc nặng nề vào một quan sát đuôi cực đại.
Thứ ba, các dòng – của scatter_cost_rev_rc_inc.do áp đặt một nhân tử tỷ lệ vô hướng đồng nhất cho mọi nhóm phân vị thu nhập để chuyển đổi tổng chi phí sang chi phí biên: rc2_base chia costs_tot_future cho tỷ số và rc2_high chia cho . Cách nội suy tuyến tính đồng nhất này ép giả định bất biến từ phân vị 0–5 đến 99.9+, bất chấp bằng chứng từ ap8.dta cho thấy mỗi cuộc thanh tra ở nhóm 99.9+ tiêu tốn tới giờ công của thanh tra viên bậc cao với đơn giá USD mỗi giờ so với giờ ở mức USD mỗi giờ tại nhóm 0–5, kéo theo cường độ sử dụng bộ phận khiếu nại và tư vấn pháp lý hoàn toàn khác biệt. Thứ tư, phép so sánh hai thời điểm 2010 và 2014 trùng với chu kỳ phục hồi mạnh sau suy thoái tài chính 2008–2009 và sự bùng nổ thu nhập từ lãi vốn năm 2013–2014; Chuỗi thời gian tại ap6.dta cho thấy tỷ suất doanh thu trên lao động vận hành biến động đáng kể từ năm 2008 xuống năm 2011 trước khi hồi phục lên năm 2013, do đó biến động kinh tế vĩ mô thuận chu kỳ có thể bù lấp phần suy giảm lợi suất biên thuần túy do thu hẹp thanh tra.
A.2.2. Nhận dạng răn đe dài hạn từ chuỗi sự kiện NRP và nghiên cứu đối chứng vận hành
Chuỗi nghiên cứu sự kiện trên mẫu Chương trình Nghiên cứu Quốc gia NRP tại figure_6.txt cùng phép tách hộ có thu nhập kinh doanh tại ap12.txt là nền tảng định lượng cho bội số răn đe cá nhân lần. Tuy nhiên, kiểm định sâu cấu trúc thời gian của các chuỗi hệ số công khai này phát hiện ba lỗ hổng nhận dạng đáng quan tâm. Đầu tiên, khi ước lượng riêng độ dốc tiền xu hướng trên năm tiền thanh tra của chuỗi wins99 trong figure_6.txt, đường xu hướng trước thanh tra mang hệ số âm USD mỗi năm với sai số chuẩn và , trước khi đảo chiều thành xu hướng tăng tuyến tính dương rất mạnh USD mỗi năm với sai số chuẩn và trong giai đoạn hậu thanh tra . Khác với quy luật hao mòn trí nhớ răn đe thường giảm dần sau – năm trong nghiên cứu của DeBacker và cộng sự (2018), sự gia tăng liên tục của hệ số từ USD tại lên USD tại và USD tại vừa phản ánh độ trễ giải quyết hồ sơ – năm như ghi nhận tại ap5.dta, vừa chịu tác động của sự dịch chuyển thành phần thế hệ không cân bằng: do các đợt NRP kéo dài từ năm thuế 2006 đến năm 2014, các điểm sự kiện chỉ được định danh từ các thế hệ đầu kỳ 2006–2009, hệ quả là sai số chuẩn tăng vọt gấp bốn lần từ USD ở lên USD ở và USD ở , tương tự biên độ tăng từ USD lên USD ở nhóm hộ kinh doanh trong ap12.txt.
Thứ hai, phép kiểm chứng chéo trên nghiên cứu sự kiện đối chứng ghép cặp cho thanh tra vận hành thông thường tại ap14.dta bộc lộ sự vi phạm nghiêm trọng giả định xu hướng song song trước điều trị. So với năm chuẩn hóa bằng USD, chênh lệch thuế tự nguyện của nhóm được thanh tra vận hành luôn cao hơn nhóm đối chứng từ USD tại , đạt đỉnh USD tại và duy trì USD tại , trước khi sụt mạnh về USD ngay tại năm với trung bình tiền thanh tra lên tới USD mỗi năm. Hiện tượng sụt giảm kiểu Ashenfelter ngay trước năm bị chọn thanh tra cho thấy việc ghép cặp theo lát cắt tĩnh tại năm thuế kích hoạt thanh tra chưa khử được các cú sốc thu nhập nhất thời kích hoạt thuật toán rủi ro, khiến một phần mức bật tăng đến USD trong giai đoạn phản ánh sự hồi quy về trung bình chứ không thuần túy là hiệu ứng răn đe. Hơn nữa, tệp ap14.dta không công bố bất kỳ cột sai số chuẩn nào, cản trở mọi kiểm định giả thuyết độc lập trên chuỗi đối chứng vận hành.
Thứ ba, cả figure_6.txt lẫn ap12.txt chỉ đo lường hiệu ứng răn đe cá nhân trực tiếp lên người nộp thuế đã trải qua thanh tra, hoàn toàn bỏ qua hai kênh phản ứng cân bằng tổng quát trái chiều: hiệu ứng lan tỏa răn đe tích cực qua mạng lưới doanh nghiệp, đối tác cung ứng và đại lý thuế đã được chứng minh trong Boning và cộng sự (2020), đối nghịch với hiệu ứng học hỏi chiến lược khi người nộp thuế nhận biết xác suất bị tái thanh tra suy giảm ngay sau một cuộc thanh tra như thể hiện qua kịch bản event_study_future_audit_prob.do.
A.2.3. Suy luận mẫu nhỏ hc1 so với hc3, độ nhạy Oster và tương quan chuỗi
Do mọi tệp dữ liệu trong gói tái lập doi:10.7910/DVN/SVQASQ đều là dữ liệu phân tổ theo phân vị hoặc năm sự kiện với cỡ mẫu hữu hạn từ đến , phép tính ma trận hiệp phương sai HC1 tiêu chuẩn của Stata rất dễ đánh giá thấp phương sai ước lượng khi tồn tại các quan sát đuôi mang giá trị đòn bẩy cao. Để thẩm định độ tin cậy của suy luận thống kê, Bảng A1 tổng hợp kết quả kiểm định hiệu chỉnh đòn bẩy HC3 theo MacKinnon và White (1985) với nhân tử trọng số , giá trị đòn bẩy cực đại , cùng cận lựa chọn biến bỏ sót theo Oster (2019) trên toàn bộ các mô hình phân tầng trọng tâm.
| Mô hình và biến giải thích trọng tâm | Cỡ mẫu | Đòn bẩy | Giá trị điểm | Thống kê | Cận Oster và | ||
|---|---|---|---|---|---|---|---|
| Mô hình 1 — Tỷ suất R/C lao động 2010 | — | ||||||
| Mô hình 12 — R/C lao động 2010 không trọng số | — | ||||||
| Mô hình 3 — Thứ hạng phân vị TPI thực địa | ; | ||||||
| Mô hình 3 — Chỉ báo nhóm top 1% thực địa | — | ||||||
| Mô hình 4 — Chỉ báo nhóm top 1% qua thư | — | ||||||
| Mô hình 5 — Độ dốc decile tỷ suất biên răn đe | — | ||||||
| Mô hình 5 — Chỉ báo top 1% tỷ suất biên răn đe | — | ||||||
| Mô hình 6 — Độ dốc decile phúc lợi MVPF | — | ||||||
| Mô hình 8 — Tương tác hộ kinh doanh NRP | ; | ||||||
| Mô hình 9 — Độ dốc decile gánh nặng tuân thủ | ; |
Ghi chú: Sai số chuẩn áp dụng hiệu chỉnh đòn bẩy theo MacKinnon và White (1985); Mức ý nghĩa sao thống kê ở cột hệ số ước lượng đánh giá theo ; Kiểm định Oster (2019) cố định kịch bản giới hạn khắt khe nhất ; , , .
Kết quả trên Bảng A1 minh chứng ba hệ quả suy luận cốt lõi. Thứ nhất, các biến chỉ báo nhị phân tách nhóm đỉnh top1_flag vốn chỉ nhận giá trị bằng tại hai ô cuối 99–99.9 và 99.9+ tạo ra mức đòn bẩy cực đại trong Mô hình 3 và trong Mô hình 5, khiến sai số chuẩn HC3 phình to gần gấp đôi so với HC1 và kéo giá trị rơi xuống ở Mô hình 3 cũng như ở Mô hình 5—triệt tiêu hoàn toàn ý nghĩa thống kê của bước nhảy riêng tại top 1%. Thứ hai, trong Mô hình 12 không trọng số, nhóm 99.9+ đạt đòn bẩy tới , làm nhảy vọt so với ; May mắn là độ dốc liên tục theo phân vị thu nhập ở các Mô hình 3, 5 và 6 vẫn bảo toàn ý nghĩa thống kê ở ngưỡng đến dưới HC3. Thứ ba, theo kiểm định Oster (2019), trong khi phần bù răn đe của hộ kinh doanh đạt vượt xa ngưỡng bền vững chuẩn , thì độ dốc tuyến tính của cả tỷ suất thực địa ở Mô hình 3 lẫn gánh nặng tuân thủ ở Mô hình 9 chỉ đạt và , chứng tỏ chuyển động của đường dốc tuyến tính chịu ảnh hưởng cấu trúc đáng kể từ sự tập trung phi tuyến tại đỉnh phân phối thu nhập. Ngoài ra, tại Mô hình 7 và Mô hình 8, việc áp dụng sai số chuẩn HC1 giả định sai số ngẫu nhiên độc lập qua các năm sự kiện, bỏ qua hiện tượng tự tương quan chuỗi từ mẫu người nộp thuế lặp lại và phương sai tăng gấp bốn lần về cuối chân trời quan sát .
A.3. Thẩm định chất lượng dữ liệu, cách đo lường biến số và độ nhạy mẫu
A.3.1. Đối khớp mã nguồn Stata, sai lệch phiên bản tệp dữ liệu và quy ước phân vị
Quá trình rà soát từng dòng mã nguồn trên toàn bộ kịch bản .do và đối khớp số học với Appendix_Tables.xlsx, Table_1.xlsx cùng các tệp dữ liệu phân tổ phát hiện năm điểm bất nhất kỹ thuật có tác động trực tiếp đến tính tái lập và diễn giải kết quả:
- Hoán chuyển tham số chi phí gián tiếp trong
waterfall_cost_rev_future_disc.do: Tại các dòng – của kịch bảnwaterfall_cost_rev_future_disc.do, ba bội số thành phần chi phí gián tiếp đối với thanh tra thực địa được gán cứng lần lượt là , và . Đối chiếu trực tiếp với bảng Excel gốcAppendix Table A.IVtrongAppendix_Tables.xlsxở trang tínhfield-exam-T1-3cho thấy giá trị trung bình giai đoạn 2011–2015 chính xác phải là , và . Mặc dù tổng bội số chi phí gián tiếp không đổi ở mức , thành phần chi phí cấp tổ chức và chi phí chung trụ sở chính đã bị hoán chuyển một lượng đúng bằng , làm sai lệch nhẹ các nhãn phân bổ chi phí thành phần trên biểu đồ thác nước thực địa trong khi bộ hệ số thanh tra qua thư , và lại khớp tuyệt đối vớiAppendix Table A.VII. - Sai lệch ở phân vị
99.9+giữafigure_2_5.csvvàfigure_2_5.dta: Khi đối sánh từng ô dữ liệu giữa hai tệp phân phối song song trong gói lưu trữ, cột tổng chi phícosts_tot_futurehoàn toàn trùng khớp trên cả phân vị, thế nhưng cột doanh thu chiết khấurev_tot_disctrongfigure_2_5.csvlại cao hơn hệ thống trongfigure_2_5.dtaở hầu hết các nhóm đỉnh: cao hơn ở nhóm90–95, ở nhóm95–99, ở nhóm99–99.9và đạt biên độ lệch tối đa tại nhóm99.9+, đẩy doanh thu từ USD lên USD và tỷ suấtrc_future_disctừ lên . Thiếu vắng ghi chú cập nhật phiên bản khiến người tái lập không thể xác minh liệu chênh lệch này xuất phát từ bản cập nhật chỉ số trượt giá hay điều chỉnh dòng thu hồi muộn sau phát hành. - Lỗi cú pháp không thể thực thi ở dòng của
event_study_taxes_paid_bus_income.do: Dòng chứa câu lệnh sai cú phápkeep if nrp2 =="nrp=1"dgvới hai ký tự thừadgở cuối dòng, đồng thời lọc trên biến trung giannrp2thay vì biếnnrpvừa được tạo ở dòng qua lệnhcarryforward. Lỗi này làm gián đoạn hoàn toàn quy trình chạy hàng loạt củametafile.dotrên Stata nếu không được hiệu chỉnh thủ công trước khi biên dịch. - Lệch pha quy ước đánh số
decilevà sai khác mẫu số trongTable_1.xlsx: Hệ thống tệp gốc dùng hai quy ước chỉ mục phân vị lệch nhau đúng một bậc giữa hai cụm phân tích:figure_6a_ap15.dtavàfigure_7.dtagán nhóm0–10bằng mã ,90–99bằng ,99–99.9bằng và99.9+bằng ; Ngược lại,figure_9.dta,ap16.dtavàap18.dtagán0–10bằng mã ,90–99bằng và99+bằng . Bất kỳ phép ghép nối bảng trực tiếp nào theo khóadecilemà không chuẩn hóa sẽ gây lệch một phân vị toàn bộ phân bố MVPF. Bên cạnh đó, ngay trong tệpTable_1.xlsx, trang tính chínhTable 1tính bội số răn đe chưa winsorized bằng cách chia cho doanh thu cơ học chưa winsorized ở cộtG, cho kết quả lần ở99–99.9và lần ở99.9+, trong khi trang tính phụSheet1lại tham chiếu sai sang doanh thu cơ học đã winsorized ở cộtB, biến bội số thành và lần. - Định dạng tệp nhị phân ngụy trang dưới phần mở rộng
.txt: Hai tệpfigure_6.txtvàap12.txtthực chất là tệp dữ liệu nhị phân chuẩn Stata 118 dù mang đuôi văn bản, dễ khiến các quy trình kiểm định hoặc phân tích tự động bằng ngôn ngữ Python hay R bỏ sót dữ liệu nghiên cứu sự kiện nếu chỉ dựa vào phần mở rộng tệp.
A.3.2. Độ nhạy winsorization đuôi siêu giàu, lãi suất chiết khấu và khoảng trống MVPF trên nhóm 99+
Kiểm định độ nhạy định lượng cho thấy hai trục rủi ro lớn nhất đối với kết luận phúc lợi tại vùng thu nhập đỉnh nằm ở phép xử lý giá trị ngoại lai và khoảng trống quan sát trên phân vị 99+. Trước hết, trên bảng Table_1.xlsx và figure_6a_ap15.dta, hiệu ứng răn đe năm chưa winsorized ở nhóm 99–99.9 nhận giá trị âm USD tương ứng bội số lần, và tại nhóm 99.9+ sụt xuống tới USD tương ứng bội số lần với khoảng tin cậy trải rộng từ đến lần. Nguyên nhân là phân phối thu nhập và tiền thuế nộp bổ sung của nhóm siêu giàu cực kỳ lệch phải, nơi chỉ một số ít đối tượng đối chứng hoặc bị thanh tra phát sinh biến động lỗ vốn hàng triệu đô la sau sự kiện sẽ áp đảo hoàn toàn trung bình mẫu. Ngay cả khi áp dụng winsorization ở bách phân vị 99.9, bội số răn đe điểm tại nhóm 99–99.9 và 99.9+ hồi phục lên lần và lần nhưng khoảng tin cậy vẫn bao trùm số , lần lượt là và .
Tương tự, độ nhạy theo lãi suất chiết khấu trên chuỗi NRP năm từ figure_6.txt cho thấy so với mức cơ sở cho giá trị hiện tại USD, việc nới lỏng lãi suất chiết khấu về làm tổng doanh thu răn đe tăng lên USD hay , trong khi nâng lãi suất chiết khấu xã hội lên và kéo giảm giá trị hiện tại xuống còn USD hay và USD hay . Vì lợi ích răn đe trải dài tới năm sau thanh tra trong khi chi phí hành chính và gánh nặng tuân thủ phát sinh tập trung trong – năm đầu, mức chiết khấu làm suy giảm đáng kể mẫu số doanh thu thuần và đẩy chỉ số MVPF lên cao hơn ở các phân vị có biên an toàn hẹp.
Đáng chú ý hơn cả là khoảng trống ngoại suy trên phân vị 99+ trong khung MVPF: dữ liệu ước lượng figure_9.dta và Hình 9 của bài gốc dừng hoàn toàn tại nhóm 90–99 với và khoảng tin cậy , hoàn toàn vắng bóng hai nhóm đỉnh 99–99.9 và 99.9+. Khi bài viết mở rộng tỷ suất hoàn vốn biên lên lần ở 99–99.9 và lần ở 99.9+ trong figure_7.dta, phép tính đó áp đặt bội số răn đe đồng nhất lần của toàn dân số thay vì bội số riêng từng nhóm vốn bất định rất lớn ở đuôi trên, đồng thời không cung cấp được khoảng tin cậy MVPF trực tiếp cho top giàu nhất.
A.3.3. Đo lường gánh nặng tuân thủ, bất đối xứng không điều chỉnh và định giá thời gian ở nhóm đỉnh
Kiểm định cấu phần dữ liệu gánh nặng tuân thủ từ ap16.dta, ap17.dta và ap18.dta phát hiện một cơ chế đo lường nhạy cảm chưa được thảo luận đầy đủ trong nghiên cứu gốc. Trước tiên, dữ liệu từ ap17.dta xác nhận tỷ lệ cuộc thanh tra thực địa kết thúc mà không có bất kỳ điều chỉnh tăng thuế nào, được mã hóa bằng chỉ báo assessed0, leo thang mạnh mẽ ở nhóm siêu giàu: từ mức ở phân vị 85–90 và ở 90–95, tỷ lệ này nhảy vọt lên ở 95–99, ở 99–99.9 và đạt tới tại nhóm đỉnh 99.9+. Trên ap18.dta, tại vùng 99+, một cuộc thanh tra không điều chỉnh thuế gây ra tổng gánh nặng tuân thủ quy đổi lên tới USD với giờ làm việc trực tiếp và USD chi phí tiền tệ, cao hơn so với mức USD cùng giờ và USD của nhóm có điều chỉnh thuế.
Tuy nhiên, việc giải cấu trúc phương trình quy đổi tiền tệ của khảo sát IRS cho thấy một bất thường định lượng nghiêm trọng về đơn giá giá trị thời gian ngầm định :
Trong đó:
- : đơn giá thời gian tuân thủ ngầm định tính bằng đô la mỗi giờ tại phân vị thu nhập ;
- : tổng gánh nặng tuân thủ quy đổi bình quân mỗi hồ sơ ghi nhận trong
ap16.dtavàap18.dta; - : chi phí chi trả bằng tiền trực tiếp cho dịch vụ tư vấn kế toán hoặc pháp lý bên ngoài;
- : tổng số giờ làm việc trực tiếp người nộp thuế phải bỏ ra để giải trình hồ sơ thanh tra.
Tính toán trực tiếp từ ap16.dta chỉ ra tăng từ mức – USD mỗi giờ ở các nhóm 0–30, lên USD mỗi giờ ở 50–60, USD mỗi giờ ở 80–90, USD mỗi giờ ở 90–99, rồi bất ngờ nhảy vọt gần mười lần lên USD mỗi giờ tại nhóm 99+—và thậm chí đạt USD mỗi giờ cho các hồ sơ không điều chỉnh thuế so với USD mỗi giờ cho hồ sơ có điều chỉnh thuế trên ap18.dta. Cơ chế gán giá trị thời gian bằng cách chia tổng thu nhập dương cho giờ công chuẩn đã đồng nhất hóa thu nhập từ vốn, cổ tức và lợi nhuận phân phối thụ động ở nhóm siêu giàu với chi phí cơ hội cận biên của một giờ lao động hành chính, tạo ra sai số đo lường phi cổ điển làm thổi phồng gánh nặng thời gian ở tử số MVPF. Ngược lại, do khảo sát gánh nặng tuân thủ năm 2023 của IRS gộp chung các quy trình hậu kê khai từ thanh tra qua thư đến thực địa và áp đặt chung lên hồ sơ 2010–2014, khoản chi thuê chuyên gia bên ngoài ghi nhận chỉ dừng ở USD tại 99+ có thể đánh giá thấp đáng kể phí luật sư thuế và tranh tụng thực tế của giới siêu giàu. Đồng thời, trong Mô hình 9 hồi quy logarit tổng gánh nặng, hệ số của biến assessed0 chỉ đạt với sai số chuẩn và do chênh lệch không điều chỉnh thuế vận động bất đối xứng theo thu nhập: gần như bằng không ở 0–10 với mức nhưng vọt lên ở 70–80 và ở 99+.
A.4. Các hạn chế cốt lõi trọng yếu của nghiên cứu gốc
- Hạn chế định danh lợi suất biên từ quy mô chi phí cố định và thiên lệch chọn lọc hồ sơ trong giai đoạn 2010–2014: Bằng chứng hồi quy 45 độ tại Mô hình 1 chỉ chứng minh tính bất biến trên chi phí lao động trực tiếp, trong khi hồi quy tương ứng trên tổng chi phí thực tế
rc2014theorc2010cho độ dốc , phản ánh chi phí cố định gián tiếp bình quân phình to khi tổng quy mô thanh tra giảm . Kết hợp cùng phép ngoại suy chi phí biên bằng hằng số vô hướng đồng nhất bất chấp dị biệt cấu trúc giờ công và cơ cấu chọn lọc phi ngẫu nhiên theo điểm rủi ro DIF—nơi số hồ sơ nhóm95–99và99.9+bị cắt giảm và trong khi kiểm định Oster chỉ đạt —ước lượng lợi suất biên ở vùng thu nhập cao đối mặt rủi ro chệch ước lượng hướng lên do bỏ sót biến chất lượng hồ sơ nội sinh. - Bất định mẫu nhỏ dưới đòn bẩy phân vị cực đại, vi phạm xu hướng song song vận hành và tự tương quan chuỗi sự kiện: Ở cấp độ dữ liệu phân tổ với , suy luận bằng sai số chuẩn HC1 giản lược đánh giá thấp nghiêm trọng phương sai tại các ô đuôi có đòn bẩy , khiến biến chỉ báo
top1_flagtại Mô hình 3 và Mô hình 5 mất hoàn toàn ý nghĩa thống kê dưới hiệu chỉnh HC3 với và . Đồng thời, chuỗi sự kiện NRPfigure_6.txtbộc lộ tiền xu hướng âm nhẹ với và sai số chuẩn tăng gấp bốn lần ở do hao hụt thế hệ không cân bằng, còn chuỗi đối chứng ghép cặp vận hànhap14.dtamang dấu ấn sụt giảm Ashenfelter tiền thanh tra rõ nét từ USD về USD và thiếu hoàn toàn sai số chuẩn để kiểm chứng suy luận hợp lệ. - Tính nhạy cảm cực đại của bội số răn đe đuôi trên trước phép cắt ngưỡng winsorization, chiết khấu và bỏ sót ngoại ứng cân bằng tổng quát: Khi không winsorization, nhiễu đuôi cực đoan ở nhóm
99–99.9và99.9+đảo chiều bội số răn đe sang và lần với giá trị điểm USD; Ngay sau khi winsorization ở bách phân vị99.9, khoảng tin cậy tại hai nhóm đỉnh vẫn cắt ngang số và giá trị hiện tại răn đe sụt giảm khi nâng lãi suất chiết khấu từ lên . Bên cạnh đó, khung phân tích chỉ nhận dạng kênh răn đe cá nhân mà chưa lượng hóa nội sinh hiệu ứng lan tỏa sang mạng lưới doanh nghiệp theo Boning và cộng sự (2020) hay phản ứng chuyển dịch thu nhập phức tạp của nhóm như cảnh báo trong Guyton và cộng sự (2021). - Sai số đo lường phi cổ điển trong gánh nặng tuân thủ, ngoại suy MVPF khuyết thiếu trên nhóm 99+ và đồng nhất trọng số phúc lợi đối với hành vi trốn thuế: Tỷ lệ thanh tra không điều chỉnh thuế vọt lên ở
99.9+cùng đơn giá thời gian ngầm định nhảy vọt lên USD mỗi giờ tại99+đã hòa lẫn thu nhập vốn với chi phí cơ hội thời gian và gây sai số đo lường phi cổ điển ở tử số MVPF, trong khi chuỗi MVPF chính thức tạifigure_9.dtakhuyết thiếu hoàn toàn phân vị99+. Hơn nữa, công thức MVPF chuẩn mặc định gán trọng số phúc lợi ngang nhau cho mỗi đô la thu hồi từ người trốn thuế và mỗi đô la chi phí tuân thủ phát sinh trên người nộp thuế trung thực, dẫn đến thiên lệch chuẩn tắc trong đánh giá phúc lợi tương đối giữa các nhóm thu nhập. - Các bất nhất mã nguồn công khai và giới hạn cấu trúc tái lập dưới Điều 6103: Gói tái lập tồn tại bốn sai sót kỹ thuật gây sai số đo lường và chệch ước lượng trực tiếp khi tổng hợp dữ liệu: hoán chuyển giữa hệ số chi phí gián tiếp và trong
waterfall_cost_rev_future_disc.do, chênh lệch ở99.9+giữafigure_2_5.csvvàfigure_2_5.dta, lỗi cú pháp dòng tạievent_study_taxes_paid_bus_income.do, và sự lệch pha quy ước đánh sốdecilelàm dịch chuyển một phân vị toàn bộ hồi quy MVPF nếu ghép nối trực tiếp cùng tham chiếu sai mẫu số trong sheet phụ củaTable_1.xlsx. Đồng thời, việc đóng gói dữ liệu công khai theo lát cắt tổng hợp dưới Điều 6103 làm suy giảm mạnh bậc tự do xuống , triệt tiêu khả năng ước lượng hiệu ứng cố định đa chiều ở cấp độ hồ sơ cá nhân và không cho phép kiểm định cấu trúc hiệp phương sai sai số chuẩn theo cụm hộ gia đình.
A.5. Khuyến nghị nâng cấp mô hình và hướng mở rộng công bố quốc tế
A.5.1. Chuẩn hóa nhận dạng thế hệ NRP, suy luận mẫu nhỏ hc3/jackknife và hồi quy phương sai nghịch đảo
Để khắc phục thiên lệch thành phần thế hệ tại chân trời trong chuỗi NRP figure_6.txt và hiện tượng sụt giảm tiền thanh tra tại chuỗi đối chứng vận hành ap14.dta, nghiên cứu mở rộng trên dữ liệu hành chính gốc cần thay thế đặc tả chênh lệch trong chênh lệch gộp bằng bộ ước lượng bão hòa theo thế hệ của Sun và Abraham (2021) hoặc Callaway và Sant'Anna (2021), đồng thời khớp cặp xu hướng trên cửa sổ đa thời kỳ tiền điều trị nhằm triệt tiêu cú sốc nhất thời ở năm gốc. Đối với các bảng dữ liệu phân tổ công khai , mọi hồi quy phân tầng cần chuyển sang chuẩn suy luận kháng đòn bẩy HC3 hoặc Jackknife loại một quan sát kết hợp hiệu chỉnh bậc tự do hiệu dụng Bell-McCaffrey, đồng thời thay thế phép trừ chi phí cố định bằng hằng số đồng nhất bằng mô hình hàm chi phí hành chính phi tuyến cho phép tỷ trọng cố định thay đổi theo số giờ thanh tra và tỷ lệ chuyển hồ sơ sang giai đoạn khiếu nại ở từng phân vị thu nhập. Tại các chuỗi sự kiện có phương sai bùng phát về cuối kỳ, nên áp dụng bình phương tối thiểu tổng quát trọng số nghịch đảo phương sai kèm sai số chuẩn nhất quán tự tương quan HAC để loại bỏ ảnh hưởng của các quan sát đuôi có độ bất định cao.
A.5.2. Mở rộng khung MVPF phân tách gánh nặng tuân thủ vô can và định giá lại thời gian nhóm đỉnh
Nhằm giải quyết đồng thời hai lỗ hổng ở tử số và khoảng trống trên phân vị 99+, chúng tôi đề xuất mô hình Giá trị Cận biên Công quỹ Điều chỉnh Phúc lợi phân tách rõ trọng số chiết khấu chuẩn tắc áp dụng cho khoản thuế truy thu từ hành vi trốn thuế so với gánh nặng tuân thủ phân tầng giữa người nộp thuế có điều chỉnh và không có điều chỉnh thuế:
Trong đó:
- : giá trị cận biên công quỹ hiệu chỉnh cho phép phân tách gánh nặng tuân thủ theo kết quả thanh tra tại phân vị ;
- : giá trị hiện tại doanh thu cơ học ban đầu thu hồi từ một cuộc thanh tra biên tại phân vị ;
- : tham số trọng số phúc lợi xã hội đặt trên mỗi đô la thuế thu hồi từ đối tượng trốn thuế với tương ứng chuẩn cơ sở của bài gốc;
- : hệ số nhân răn đe đặc thù của phân vị ước lượng theo phân phối cắt ngưỡng có kiểm soát ngoại lai;
- : xác suất cuộc thanh tra tại phân vị kết thúc với kết quả không điều chỉnh tăng thuế bổ sung;
- : tỷ trọng chi phí tuân thủ trên doanh thu cơ học của người nộp thuế vô can không bị điều chỉnh thuế tại phân vị ;
- : tỷ trọng chi phí tuân thủ trên doanh thu cơ học của người nộp thuế có sai phạm bị điều chỉnh thuế tại phân vị ;
- : tổng chi phí hành chính bình quân mỗi cuộc thanh tra phân bổ tại phân vị ;
- : tỷ trọng chi phí cố định đặc thù theo mức độ phức tạp hồ sơ tại phân vị .
Khung phân rã này cho phép thực thi phân tích độ nhạy liên tục về ngưỡng trọng số phúc lợi hòa vốn : nếu nhà hoạch định áp dụng theo nguyên lý không bảo vệ phần lợi ích phi pháp từ trốn thuế, tử số của nhóm 90–99 và 99+ sẽ giảm nhanh hơn mẫu số, củng cố mạnh mẽ hơn nữa ưu tiên mở rộng thanh tra về phía nhóm thu nhập cao bất chấp gánh nặng hành chính. Song song đó, bộ dữ liệu khảo sát gánh nặng tuân thủ cần tách riêng chi phí thời gian theo mức lương lao động thị trường thay cho tỷ số thu nhập dương trên giờ công vốn đẩy đơn giá thời gian nhóm 99+ lên USD mỗi giờ, đồng thời bổ sung chuỗi chi phí tư vấn pháp lý thực địa riêng cho nhóm 99–99.9 và 99.9+ nhằm điền đầy khoảng trống MVPF tại đỉnh phân phối.
A.5.3. Mô hình hóa ngoại ứng mạng lưới cân bằng tổng quát và tiền thẩm định giảm thanh tra oan
Một hướng mở rộng mang lại giá trị công bố quốc tế cao tại Econometrica, American Economic Review hoặc The Quarterly Journal of Economics là kết hợp dữ liệu thanh tra cá nhân với mạng lưới đại lý khai thuế, đối tác công ty hợp danh K-1 và liên kết chuỗi cung ứng nhằm nhận dạng đồng thời hệ số nhân răn đe cá nhân và hệ số nhân lan tỏa mạng lưới tương tự khung thực nghiệm doanh nghiệp của Boning và cộng sự (2020). Về mặt thiết kế chính sách quản lý thuế, kết quả tái lập ủng hộ mạnh mẽ hai cải cách thực thi: thứ nhất, thu hẹp triệt để thanh tra qua thư đại trà nhắm vào người thụ hưởng tín thuế EITC dưới phân vị 30 nơi tỷ suất hoàn vốn nằm dưới ngưỡng hòa vốn dù chi phí gián tiếp chiếm tới ; Thứ hai, triển khai thuật toán tiền thẩm định chéo bằng dữ liệu bên thứ ba trước khi ban hành quyết định thanh tra thực địa ở nhóm 99+, nhằm cắt giảm tỷ lệ hồ sơ không điều chỉnh thuế vốn đang tạo ra gánh nặng tuân thủ trung bình USD cho mỗi người nộp thuế tuân thủ đúng pháp luật.
A.5.4. Chuẩn hóa gói tái lập công khai và quy trình minh bạch dữ liệu hành chính bảo mật
Cuối cùng, nhóm tác giả và ban biên tập phụ trách tái lập cần chuẩn hóa ngay năm điểm kỹ thuật trong gói lưu trữ doi:10.7910/DVN/SVQASQ để bảo đảm khả năng tái lập hoàn toàn khép kín: sửa triệt để lỗi cú pháp tại dòng của event_study_taxes_paid_bus_income.do thành keep if nrp2 == "nrp=1"; Hiệu chỉnh cặp bội số và trong waterfall_cost_rev_future_disc.do cho khớp hoàn toàn với Appendix Table A.IV; Công bố ghi chú giải trình chính thức cho mức chênh lệch tại phân vị 99.9+ giữa figure_2_5.dta và figure_2_5.csv; Đồng bộ quy ước đánh số decile và sửa công thức tham chiếu mẫu số trong Sheet1 của Table_1.xlsx; Đồng thời chuyển đổi hai tệp figure_6.txt và ap12.txt sang định dạng .dta hoặc .csv chuẩn kèm theo bảng sai số chuẩn cho ap14.dta và các bảng mô men tổng hợp có bảo mật vi sai cho nhóm 99–99.9 và 99.9+ trong giới hạn cho phép của Điều 6103.
Tài liệu tham khảo
- Allingham, M. G., & Sandmo, A. (1972). Income tax evasion: A theoretical analysis. Journal of Public Economics, 1, 323–338. https://doi.org/10.1016/0047-2727(72)90010-290010-2
- Alstadsæter, A., Johannesen, N., & Zucman, G. (2019). Tax evasion and inequality. American Economic Review, 109, 2073–2103. https://doi.org/10.1257/aer.20172043 ↩
- Boning, W. C., Guyton, J., Hodge, R., & Slemrod, J. (2020). Heard it through the grapevine: The direct and network effects of a tax enforcement field experiment on firms. Journal of Public Economics, 190, 104261. https://doi.org/10.1016/j.jpubeco.2020.104261 ↩
- Boning, W. C., Hendren, N., Sprung-Keyser, B., & Stuart, E. (2025). A welfare analysis of tax audits across the income distribution Replication package: [https://doi.org/10.7910/DVN/SVQASQ]. The Quarterly Journal of Economics, 140, 63–112. https://doi.org/10.1093/qje/qjae037 ↩
- Callaway, B., & Sant'Anna, P. H. C. (2021). Difference-in-differences with multiple time periods. Journal of Econometrics, 225, 200–230. https://doi.org/10.1016/j.jeconom.2020.12.001
- DeBacker, J., Heim, B. T., Tran, A., & Yuskavage, A. (2018). Once bitten, twice shy? The lasting impact of enforcement on tax compliance. The Journal of Law and Economics, 61, 1–35. https://doi.org/10.1086/697683 ↩
- Guyton, J., Langetieg, P., Reck, D., Risch, M., & Zucman, G. (2021). Tax evasion at the top of the income distribution: Theory and evidence. National Bureau of Economic Research. https://doi.org/10.3386/w28542 ↩
- Hendren, N., & Sprung-Keyser, B. (2020). A unified welfare analysis of government policies. The Quarterly Journal of Economics, 135, 1209–1318. https://doi.org/10.1093/qje/qjaa006
- Keen, M., & Slemrod, J. (2017). Optimal tax administration. Journal of Public Economics, 152, 133–142. https://doi.org/10.1016/j.jpubeco.2017.04.006
- Kleven, H. J., Knudsen, M. B., Kreiner, C. T., Pedersen, S., & Saez, E. (2011). Unwilling or unable to cheat? Evidence from a tax audit experiment in Denmark. Econometrica, 79, 651–692. https://doi.org/10.3982/ECTA9113 ↩
- MacKinnon, J. G., & White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29, 305–325. https://doi.org/10.1016/0304-4076(85)90158-790158-7
- Oster, E. (2019). Unobservable selection and coefficient stability: Theory and evidence. Journal of Business & Economic Statistics, 37, 187–204. https://doi.org/10.1080/07350015.2016.1227711 ↩
- Slemrod, J. (2019). Tax compliance and enforcement. Journal of Economic Literature, 57, 904–954. https://doi.org/10.1257/jel.20181437 ↩
- Sun, L., & Abraham, S. (2021). Estimating dynamic treatment effects in event studies with heterogeneous treatment effects. Journal of Econometrics, 225, 175–199. https://doi.org/10.1016/j.jeconom.2020.09.006
boning_hendren_2025_audits_publictable_sourcetpi_pctldeciledec_ranktpi_labelprimary_yrevent_yrpost_auditbus_incpost_x_busassessed0top10_flagMở khóa dữ liệu & mã lệnh tái lập
Sau khi theo dõi phần phân tích định lượng và bình duyệt học thuật phía trên, mời bạn đăng nhập nếu đã có gói thành viên hoặc tham gia cộng đồng nghiên cứu EcoLab để trực tiếp kiểm chứng từng hệ số ước lượng trên máy cá nhân.
Khớp chính xác tên biến, đặc tả sai số chuẩn vững và ma trận kiểm định chẩn đoán của bài nghiên cứu.
Sẵn sàng nạp trực tiếp vào môi trường thống kê cá nhân để đối chiếu độc lập từng bảng kết quả.
Đóng gói đồng bộ bản thảo chuẩn công bố tạp chí DOCX & PDF, tệp dữ liệu CSV, ba kịch bản ước lượng R · Stata · Python và hướng dẫn thực thi.
Mỗi liên kết tải xuống được cấp chữ ký bảo mật riêng cho tài khoản thành viên và tự động làm mới mượt mà ngay trên trang đọc.