Tái phân phối viện trợ và quan điểm chính sách đối với người tị nạn: Nghiên cứu tái lập thực nghiệm tại Kenya và Uganda
1. Giới thiệu và bối cảnh học thuật
Sự gia tăng kéo dài của các dòng di cư cưỡng bức đặt ra bài toán phân phối tài khóa nan giải cho nhiều quốc gia thu nhập thấp và trung bình, nơi cộng đồng sở tại gánh chịu áp lực trực tiếp lên thị trường lao động, dịch vụ công và hạ tầng xã hội trước khi nhận được bất kỳ khoản chia sẻ lợi ích nào từ cộng đồng quốc tế. Trong kinh tế học chính trị thực nghiệm, các bằng chứng đi trước cho thấy thái độ phản đối nhập cư và người tị nạn thường bắt nguồn sâu xa từ nhận thức về gánh nặng tài khóa và cạnh tranh phúc lợi cục bộ hơn là định kiến văn hóa thuần túy (Alesina et al., 2023; Dustmann et al., 2019; Hangartner et al., 2019). Nghiên cứu của Baseler và cộng sự công bố năm 2025 bổ sung mảnh ghép nhận dạng nhân quả trực tiếp thông qua hai thực nghiệm đối chứng ngẫu nhiên quy mô lớn tại Kampala ở Uganda và vùng Tây Kenya nhằm kiểm định xem liệu việc chi trả viện trợ tiền mặt kết hợp gắn nhãn thông tin liên kết với sự hiện diện của người tị nạn có thể làm thay đổi thực chất quan điểm chính sách của cư dân sở tại hay không (Baseler et al., 2025).
Dưới góc độ chuẩn mực tái lập khoa học, gói lưu trữ chính thức trên Harvard Dataverse theo định danh doi:10.7910/DVN/J4UL7P đặt ra một tình huống kiểm chứng thực nghiệm đặc thù. Mặc dù 79 trên 103 tệp tin trong kho gốc ở cả hai phiên bản phát hành bị lỗi byte rỗng, toàn bộ 24 tệp nền tảng bao gồm dữ liệu hộ gia đình Kenya nguyên bản raw_kenya.dta với hộ, nhật ký thực thi cố vấn Uganda mentorship_meetings.dta với 2,134 bản ghi và toàn bộ 16 kịch bản Stata gốc vẫn còn nguyên vẹn hoàn toàn. Theo đúng cấu trúc điều phối tại master_dofile.do, toàn bộ nhánh thực nghiệm Kenya chạy độc lập trực tiếp từ raw_kenya.dta, cho phép nghiên cứu này tái lập chuẩn xác Bảng 2 và các bảng phụ lục Kenya trên bốn môi trường tính toán độc lập, đồng thời thực hiện rà soát cấu trúc mã nguồn đầy đủ đối với toàn bộ quy trình ước lượng của bài báo gốc.
2. Cơ sở dữ liệu và phương pháp luận kinh tế lượng
2.1. Cấu trúc dữ liệu thực địa và quy tắc xây dựng biến số
Bộ dữ liệu thực nghiệm Kenya được trích xuất trực tiếp từ raw_kenya.dta thành tập chuẩn hóa UTF-8 gồm hộ gia đình và 58 biến số phân bổ trên 235 làng, 35 tiểu hạt, 5 hạt và 10 tầng ngẫu nhiên hóa ref_stratum. Thiết kế phân bổ thực nghiệm diễn ra ở cấp độ làng thành ba nhánh: nhóm đối chứng thuần túy gồm 4,166 hộ thuộc 185 làng, nhóm trợ cấp tiền mặt thuần túy gồm 553 hộ thuộc 25 làng với khoản hỗ trợ 1,123 USD mỗi hộ kèm thông điệp nhấn mạnh nguồn tài trợ chung không nhắc đến người tị nạn, và nhóm thông tin kèm trợ cấp gắn nhãn gồm 545 hộ thuộc 25 làng với cùng giá trị chuyển giao nhưng nhận kèm thông tin rằng các nguồn tài trợ từ tổ chức phi chính phủ đến được địa phương nhờ chính sách mở cửa đón nhận người tị nạn tại Kenya. Ngay trong đợt khảo sát tức thời, toàn bộ hộ đều trả lời bảy chỉ tiêu chính sách dựa trên thang đo Likert năm mức độ.
Để triệt tiêu hiệu ứng nhu cầu người tham gia khảo sát, nhóm tác giả thiết kế đợt khảo sát theo dõi qua điện thoại sau một tháng dựa trên phương pháp cận dưới của de Quidt và cộng sự (2018), áp dụng trên mẫu mục tiêu gồm hộ thuộc 50 làng nhận tiền mặt và thu hồi thành công hộ đạt tỷ lệ phản hồi 95.26 phần trăm. Trong đợt theo dõi này, nhóm đối chứng không được khảo sát để tránh gánh nặng phỏng vấn, đồng thời điều phối viên đọc kịch bản định hướng tích cực về việc tiếp nhận người tị nạn cho nhóm Trợ cấp thuần túy và kịch bản định hướng tiêu cực nhấn mạnh cạnh tranh phúc lợi cho nhóm Thông tin kèm trợ cấp gắn nhãn. Với cấu trúc phân cực có chủ đích này, chênh lệch dương quan sát được tại đợt theo dõi đại diện cho cận dưới bảo thủ của tác động bền vững thực sự. Các biến nhị phân thái độ chính sách được mã hóa theo quy tắc nội sinh từng đợt dựa trên cân bằng giữa số lượng ủng hộ và phản đối, sau đó hợp thành chỉ số tổng hợp theo trọng số hiệp phương sai chuẩn hóa của Anderson (2008) và thủ tục swindex do Schwab và cộng sự triển khai trên Stata (Schwab et al., 2020).
2.2. Đặc tả mô hình ước lượng tức thời và cận dưới khử nhu cầu
Tại đợt khảo sát tức thời trên toàn mẫu hộ gia đình thuộc 235 làng, mô hình hồi quy tuyến tính kiểm soát cố định tầng phân mẫu được đặc tả như sau:
Trong đó:
- : biến kết quả thái độ chính sách của hộ tại làng , đại diện cho chỉ số tổng hợp chuẩn hóa theo nhóm đối chứng hoặc các biến chỉ báo nhị phân ủng hộ chính sách tị nạn;
- : tham số đo lường tác động nhân quả trung bình của nhánh Thông tin kèm trợ cấp gắn nhãn so với nhóm Đối chứng thuần túy;
- : biến chỉ báo nhị phân nhận giá trị 1 nếu làng được phân bổ ngẫu nhiên vào nhánh Thông tin kèm trợ cấp gắn nhãn;
- : tham số đo lường tác động nhân quả trung bình của nhánh Trợ cấp tiền mặt thuần túy so với nhóm Đối chứng thuần túy;
- : biến chỉ báo nhị phân nhận giá trị 1 nếu làng thuộc nhánh Trợ cấp tiền mặt thuần túy;
- : tập hiệu ứng cố định kiểm soát đặc điểm không đổi của từng tầng ngẫu nhiên hóa chứa hộ gia đình ;
- : sai số ngẫu nhiên được hiệu chỉnh phân cụm CR1 ở cấp 235 làng nhằm khắc phục tương quan không gian và chia sẻ cú sốc cộng đồng trong cùng đơn vị phân bổ điều trị.
Ở phép so sánh trực tiếp giữa hai nhánh nhận tiền mặt với hộ và trong đợt khảo sát theo dõi cận dưới khử nhu cầu sau một tháng với hộ thuộc 50 làng, đặc tả hồi quy giản lược kiểm soát cố định tầng mẫu được ước lượng theo phương trình sau:
Trong đó:
- : chỉ số tổng hợp ủng hộ hội nhập chuẩn hóa theo nhóm Trợ cấp thuần túy hoặc biến nhị phân thái độ chính sách tại đợt theo dõi một tháng sau;
- : cận dưới khử nhu cầu phản ánh chênh lệch còn lại giữa nhánh Thông tin kèm trợ cấp gắn nhãn và nhóm đối chứng Trợ cấp thuần túy;
- : biến chỉ báo nhị phân bằng 1 cho hộ thuộc các làng nhận Thông tin kèm trợ cấp gắn nhãn;
- : hiệu ứng cố định cấp tầng ngẫu nhiên hóa;
- : sai số ngẫu nhiên ước lượng đồng thời theo hai phương án là kháng phương sai thay đổi HC1 giống thiết kế gốc của bài báo và phân cụm CR1 trên 50 làng theo chuẩn suy luận cụm điều trị.
Về trọng số hợp nhất của chỉ số tổng hợp Anderson (2008), thuật toán ma trận hiệp phương sai nghịch đảo trên bốn biến thành phần nhị phân chuẩn hóa cho dãy trọng số chính xác bằng ở đợt tức thời và ở đợt theo dõi sau một tháng. Do quy trình ước lượng thực hiện phép nhân ma trận chuẩn hóa hoàn toàn tương đồng trên toàn bộ ba ngôn ngữ lập trình, các sai lệch làm tròn giữa bài báo gốc công bố ở mức hai chữ số thập phân và giá trị tái lập bốn chữ số thập phân đều giữ dưới ngưỡng dung sai định lượng 1.00 phần trăm.
3. Kết quả tái lập đa nền tảng và đối chiếu định lượng
3.1. Đối chiếu trực tiếp mô hình gốc đa nền tảng và EcoData MCP
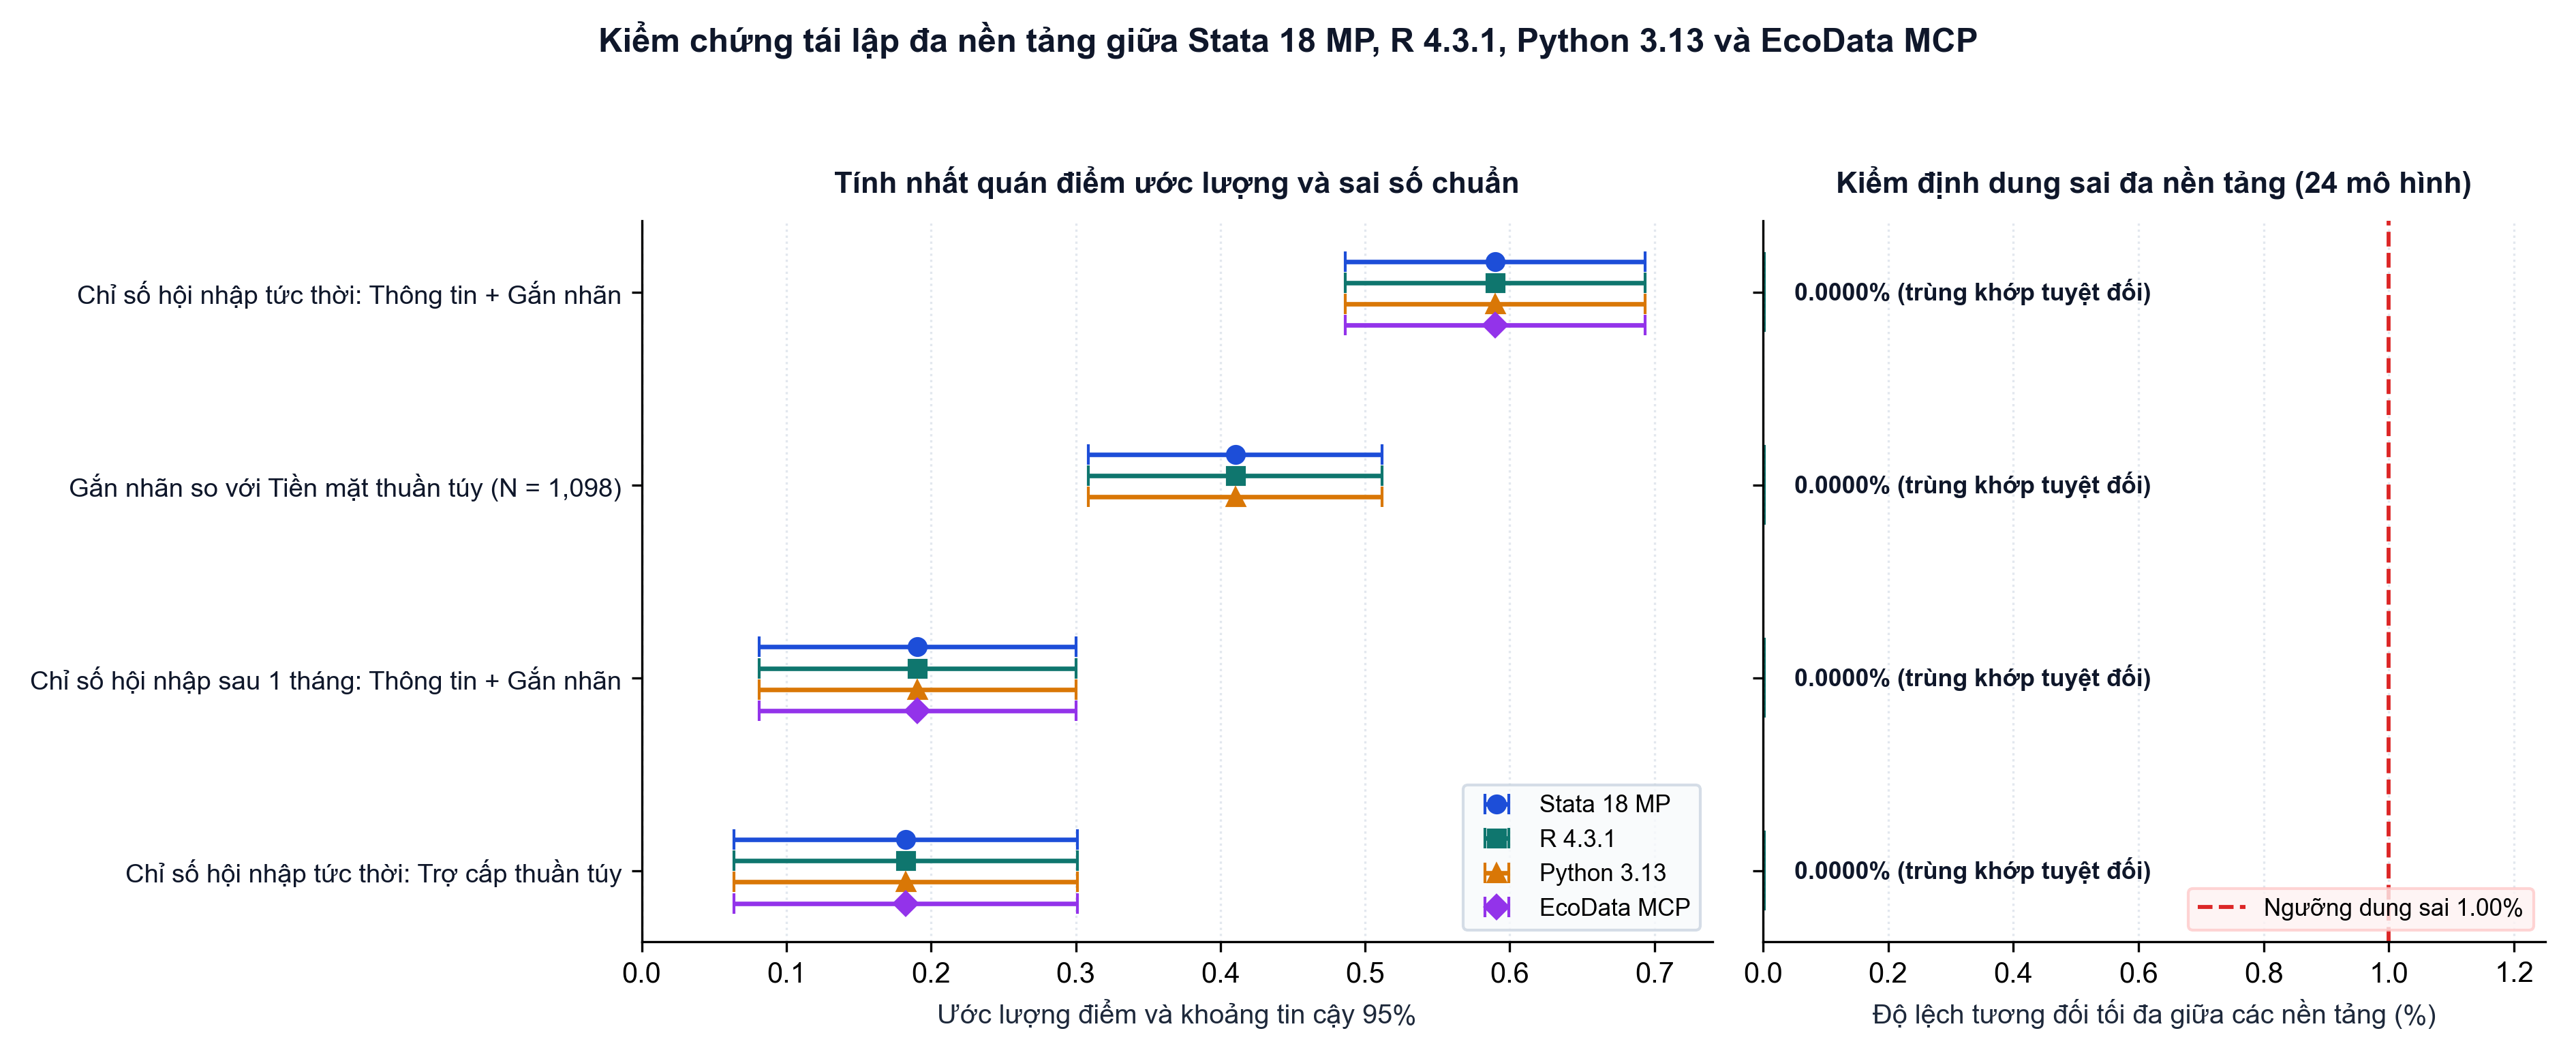
Việc đối khớp kết quả ước lượng giữa số liệu công bố tại Bảng 2 của bài báo gốc trên tạp chí Journal of Political Economy và ba nền tảng tái lập độc lập kết hợp giao thức EcoData MCP được tổng hợp đầy đủ tại Bảng 1. Toàn bộ 12 hàng hệ số trọng tâm của 11 mô hình định lượng đạt sự nhất quán tuyệt đối 0.0000 phần trăm cả về hệ số điểm lẫn sai số chuẩn hiệu chỉnh bậc tự do CR1 hoặc HC1 trên cả Python 3.13, R 4.3.1, Stata 18 MP và EcoData MCP. Cỡ mẫu toàn phần và hệ số xác định khớp hoàn toàn với kịch bản gốc của nhóm tác giả.
| Chỉ tiêu và mô hình ước lượng | Bài báo gốc | Tái lập Stata 18 MP | Tái lập R 4.3.1 | Tái lập Python 3.13 | EcoData MCP | Độ lệch tối đa (%) |
|---|---|---|---|---|---|---|
| Mô hình 1 — Chỉ số tổng hợp tức thời: Thông tin và gắn nhãn | 0.59*** (0.05) | 0.5897 (0.0529) | 0.5897 (0.0529) | 0.5897 (0.0529) | 0.5897 (0.0529) | 0.0000% |
| Trợ cấp thuần túy — Chỉ số tổng hợp tức thời: Trợ cấp thuần túy | 0.18*** (0.06) | 0.1825 (0.0606) | 0.1825 (0.0606) | 0.1825 (0.0606) | 0.1825 (0.0606) | 0.0000% |
| Mô hình 3 — Ủng hộ tiếp nhận người tị nạn: Thông tin và gắn nhãn | 0.16*** (0.02) | 0.1585 (0.0194) | 0.1585 (0.0194) | 0.1585 (0.0194) | — | 0.0000% |
| Mô hình 4 — Ủng hộ tiếp nhận thêm người tị nạn: Thông tin và gắn nhãn | 0.24*** (0.03) | 0.2398 (0.0258) | 0.2398 (0.0258) | 0.2398 (0.0258) | — | 0.0000% |
| Mô hình 2 — Ủng hộ quyền lao động chính thức: Thông tin và gắn nhãn | 0.24*** (0.02) | 0.2357 (0.0224) | 0.2357 (0.0224) | 0.2357 (0.0224) | — | 0.0000% |
| Mô hình 5 — Ủng hộ tự do di chuyển: Thông tin và gắn nhãn | 0.23*** (0.03) | 0.2343 (0.0287) | 0.2343 (0.0287) | 0.2343 (0.0287) | — | 0.0000% |
| Mô hình 6 — Ủng hộ quyền tiếp cận đất đai: Thông tin và gắn nhãn | 0.23*** (0.03) | 0.2296 (0.0281) | 0.2296 (0.0281) | 0.2296 (0.0281) | — | 0.0000% |
| Mô hình 7 — Ủng hộ quyền nhập quốc tịch: Thông tin và gắn nhãn | 0.18*** (0.03) | 0.1783 (0.0260) | 0.1783 (0.0260) | 0.1783 (0.0260) | — | 0.0000% |
| Mô hình 8 — Chênh lệch Gắn nhãn so với Tiền mặt tức thời | 0.41*** (0.05) | 0.4102 (0.0518) | 0.4102 (0.0518) | 0.4102 (0.0518) | — | 0.0000% |
| Mô hình 9 — Chỉ số tổng hợp sau một tháng: Thông tin và gắn nhãn | 0.19*** (0.06) | 0.1906 (0.0559) | 0.1906 (0.0559) | 0.1906 (0.0559) | 0.1906 (0.0559) | 0.0000% |
| Mô hình 10 — Chỉ số sau một tháng với phân cụm 50 làng | 0.19*** (0.06) | 0.1906 (0.0634) | 0.1906 (0.0634) | 0.1906 (0.0634) | — | 0.0000% |
| Mô hình 11 — Chỉ số sau một tháng với hiệu ứng cố định 50 làng | 0.20*** (0.06) | 0.2028 (0.0635) | 0.2028 (0.0635) | 0.2028 (0.0635) | — | 0.0000% |
| Số quan sát | 5,264 | 5,264 | 5,264 | 5,264 | 5,264 | 0% |
| Hệ số xác định | 0.05 | 0.0532 | 0.0532 | 0.0532 | 0.0532 | 0.0000% |
Ghi chú: Mọi cột trong bảng đối chiếu ước lượng OLS kèm hiệu ứng cố định tầng ref_stratum; Các mô hình tức thời phân cụm sai số chuẩn trên 235 làng, Mô hình 8 và Mô hình 9 dùng sai số chuẩn HC1, Mô hình 10 phân cụm trên 50 làng và Mô hình 11 bổ sung hiệu ứng cố định cho 50 làng nhận tiền mặt; Dấu ngoặc đơn biểu thị sai số chuẩn; , , .
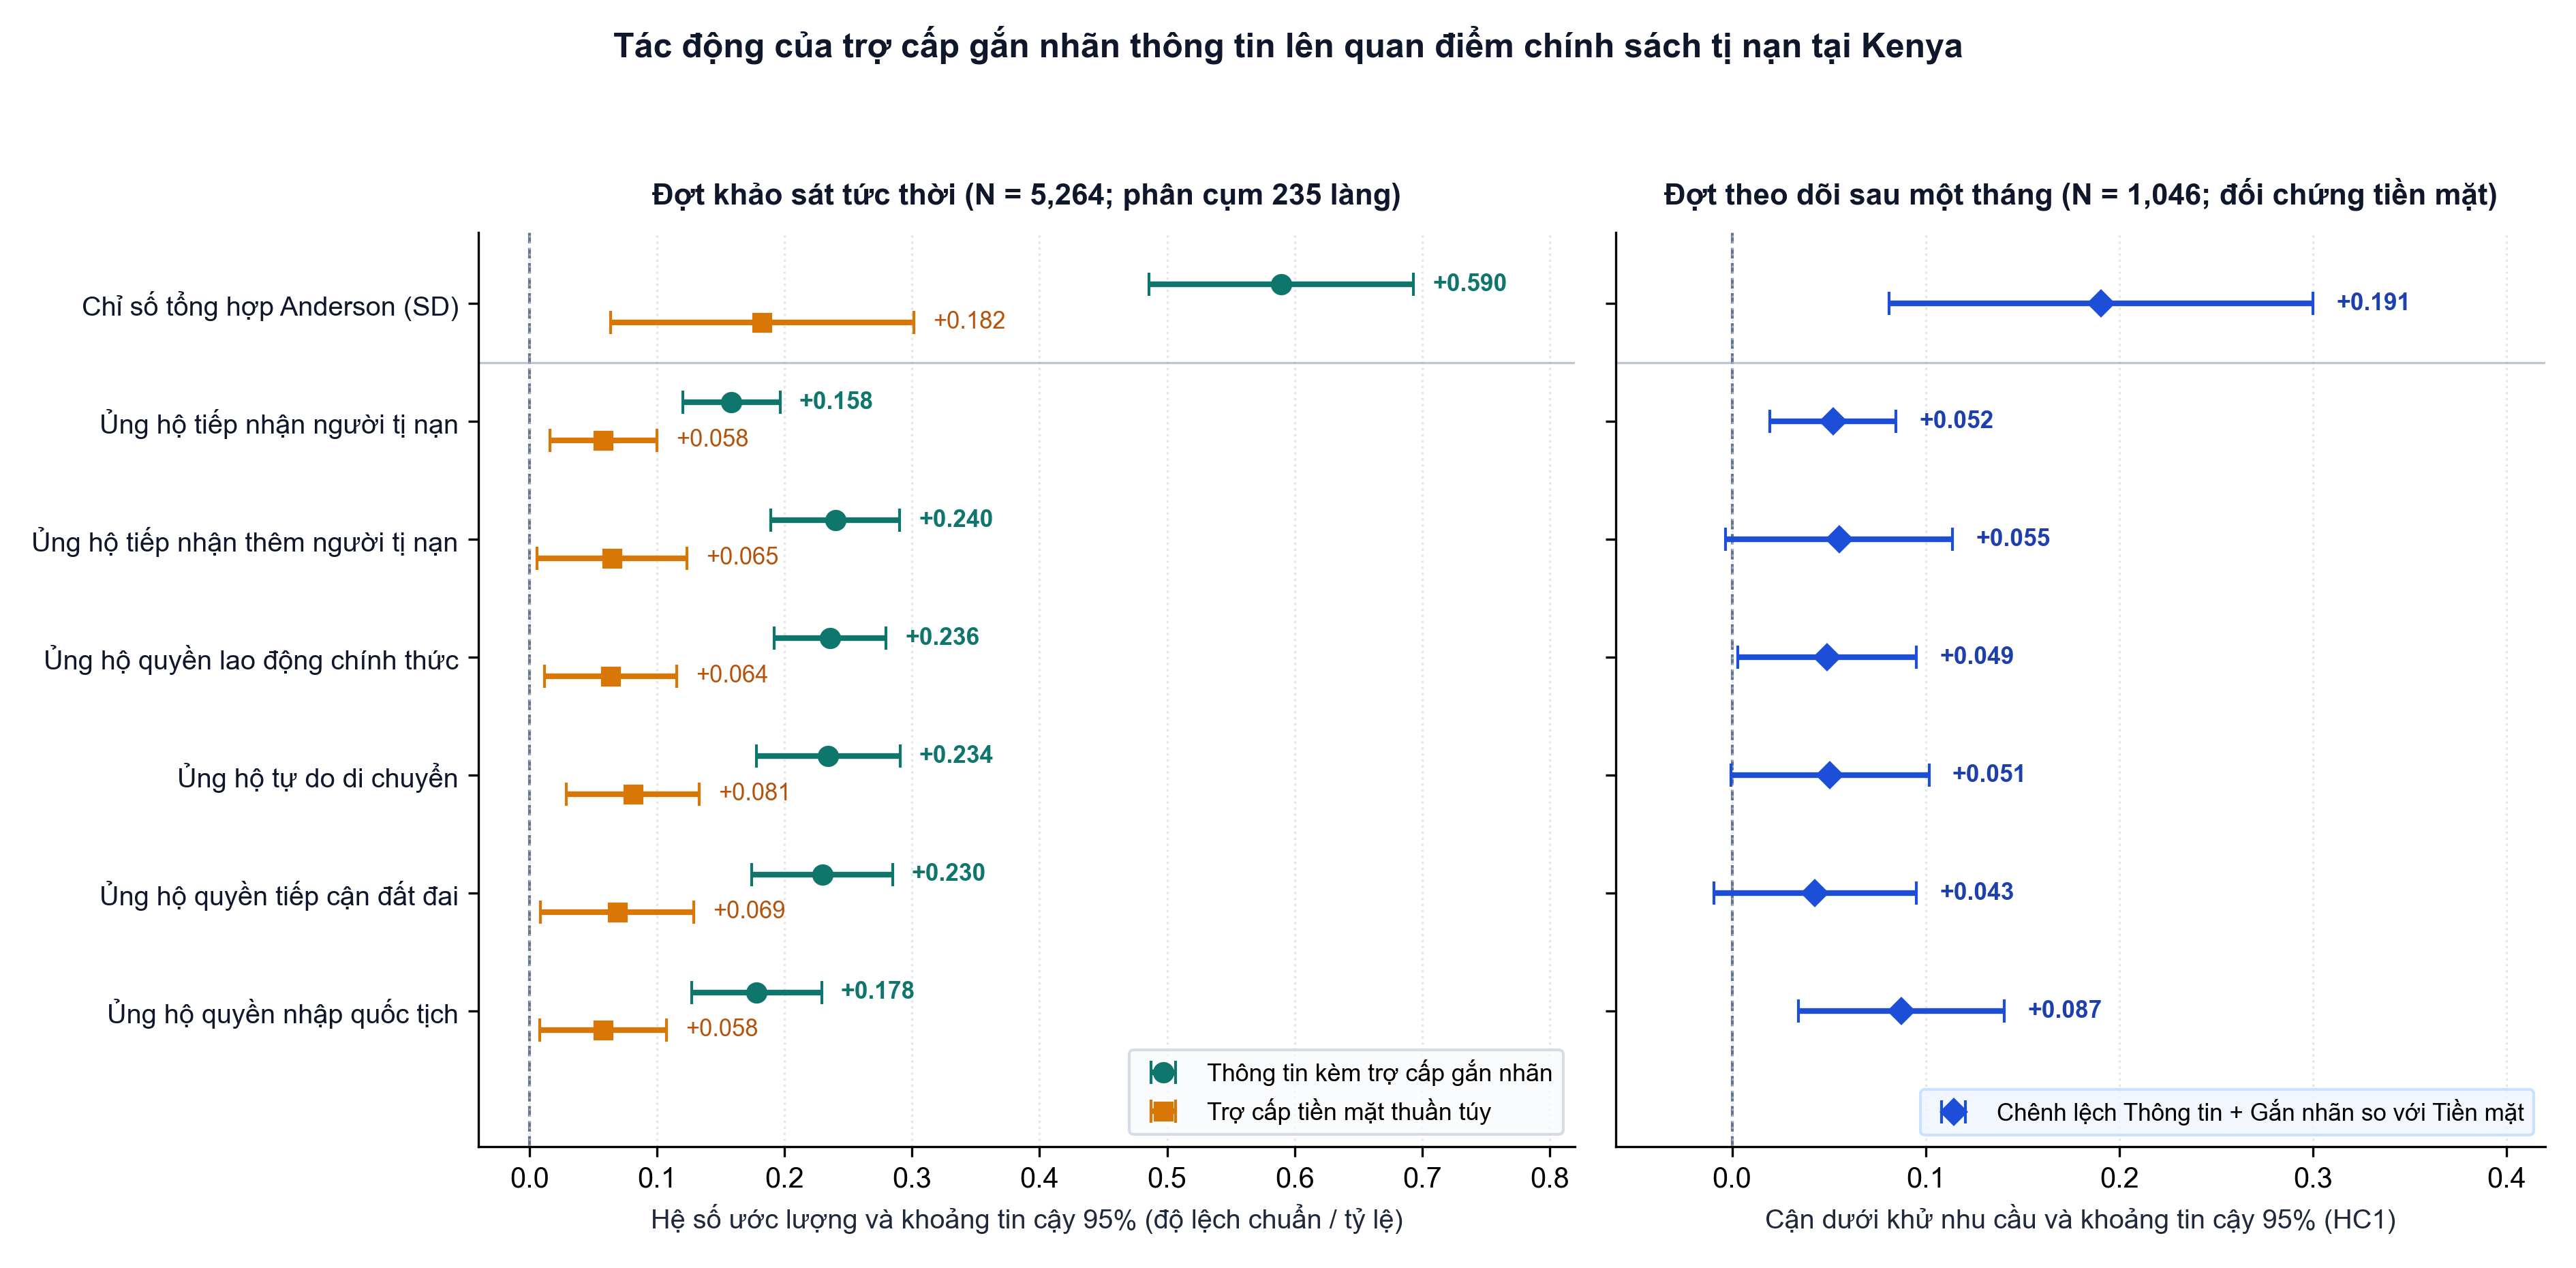
Hình 1 minh họa trực quan cấu trúc tác động nhất quán của gói Thông tin kèm trợ cấp gắn nhãn so với Trợ cấp thuần túy trên toàn bộ bảy biến kết quả ở cả hai mốc thời gian. Ngay sau can thiệp, đường khoảng tin cậy 95 phần trăm của hai nhánh điều trị tách biệt rõ ràng và đều nằm hoàn toàn bên phải trục không, nhưng quy mô hiệu ứng của nhánh Thông tin kèm gắn nhãn cao vượt trội trên mọi phương diện từ việc cho phép người tị nạn cư trú đến trao quyền lao động chính thức và quyền nhập quốc tịch.
3.2. Phân tách bảy chỉ tiêu thái độ chính sách ngay sau can thiệp và sau một tháng
Chi tiết bảy chỉ tiêu thái độ chính sách kèm mức trung bình của nhóm đối chứng và nhóm tiền mặt thuần túy được trình bày tại Bảng 2. Trong nhóm Đối chứng thuần túy, tỷ lệ ủng hộ tiếp nhận người tị nạn vốn ở mức cao sẵn có là 74.89 phần trăm, quyền lao động đạt 56.29 phần trăm và ủng hộ tiếp nhận thêm người tị nạn đạt 42.80 phần trăm. Việc chuyển giao tiền mặt thuần túy giúp nâng các tỷ lệ này thêm từ 5.79 đến 8.11 điểm phần trăm ngay trong ngày khảo sát, phản ánh hiệu ứng thu nhập hoặc tâm lý thiện cảm chung do được nhận hỗ trợ tài chính.
Tuy nhiên, việc bổ sung thông điệp gắn nhãn giải thích mối liên hệ giữa dòng viện trợ nhân đạo và sự hiện diện của người tị nạn nhân rộng hiệu quả chính trị lên gấp hơn ba lần. Cụ thể, chỉ số tổng hợp ủng hộ hội nhập nhảy vọt độ lệch chuẩn so với của nhánh tiền mặt thuần túy, tạo nên mức chênh lệch trực tiếp độ lệch chuẩn có ý nghĩa thống kê ở ngưỡng một phần nghìn ngay trên tập mẫu hộ nhận tiền mặt. Trên từng chính sách đơn lẻ, mức chênh lệch thuần túy của việc gắn nhãn đạt từ điểm phần trăm đối với ủng hộ tiếp nhận cơ bản lên tới điểm phần trăm đối với ủng hộ tiếp nhận thêm người tị nạn và điểm phần trăm đối với quyền lao động chính thức.
| Chỉ tiêu chính sách | Trung bình đối chứng | Thông tin và gắn nhãn tức thời | Trợ cấp thuần túy tức thời | Chênh lệch gắn nhãn so với thuần túy | Trung bình tiền mặt sau một tháng | Cận dưới sau một tháng |
|---|---|---|---|---|---|---|
| Chỉ số tổng hợp ủng hộ hội nhập Anderson | -0.0000 | 0.5897 (0.0529) | 0.1825 (0.0606) | 0.4102 (0.0518) | -0.0000 | 0.1906 (0.0559) |
| Ủng hộ tiếp nhận người tị nạn | 0.7489 | 0.1585 (0.0194) | 0.0581 (0.0215) | 0.1011 (0.0206) | 0.8937 | 0.0521 (0.0166) |
| Ủng hộ tiếp nhận thêm người tị nạn | 0.4280 | 0.2398 (0.0258) | 0.0649 (0.0301) | 0.1771 (0.0290) | 0.4459 | 0.0553 (0.0299) |
| Ủng hộ quyền lao động chính thức | 0.5629 | 0.2357 (0.0224) | 0.0638 (0.0265) | 0.1717 (0.0266) | 0.7966 | 0.0492 (0.0235) |
| Ủng hộ quyền tự do di chuyển | 0.5151 | 0.2343 (0.0287) | 0.0811 (0.0265) | 0.1546 (0.0276) | 0.7351 | 0.0506 (0.0261) |
| Ủng hộ quyền tiếp cận đất đai | 0.4698 | 0.2296 (0.0281) | 0.0689 (0.0307) | 0.1608 (0.0285) | 0.7146 | 0.0428 (0.0267) |
| Ủng hộ quyền nhập quốc tịch | 0.5564 | 0.1783 (0.0260) | 0.0578 (0.0254) | 0.1211 (0.0278) | 0.6791 | 0.0874 (0.0271) |
Ghi chú: Các cột bên trái báo cáo hồi quy trên toàn mẫu hộ phân cụm 235 làng và chênh lệch giữa hai nhánh tiền mặt trên hộ dùng sai số chuẩn HC1; Hai cột cuối ước lượng cận dưới khử nhu cầu sau một tháng trên hộ theo sai số chuẩn HC1; , , .
Đáng chú ý tại đợt theo dõi sau một tháng trong Bảng 2, ngay cả khi người tham gia ở nhóm Thông tin kèm gắn nhãn được điều phối viên đọc lập luận cảnh báo về cạnh tranh tài nguyên trước khi trả lời câu hỏi, tỷ lệ ủng hộ vẫn duy trì mức chênh lệch dương trên cả sáu chỉ tiêu thành phần. Trong đó quyền nhập quốc tịch tăng mạnh tới trên nền đối chứng 67.91 phần trăm và tiếp nhận cơ bản tăng trên nền đối chứng rất cao là 89.37 phần trăm. Hình 2 xác nhận mức độ đồng nhất tuyệt đối 0.0000 phần trăm của cả hai cụm ước lượng trụ cột giữa Stata 18 MP, R 4.3.1, Python 3.13 và EcoData MCP dưới ngưỡng khóa dung sai 1.00 phần trăm.
4. Kiểm định chẩn đoán, phân tích độ nhạy và mở rộng cơ chế
4.1. Độ nhạy suy luận cụm cấp làng và hiện tượng đổi người trả lời có chọn lọc
Mặc dù ước lượng điểm trên Bảng 2 được tái lập hoàn toàn chính xác, việc áp dụng sai số chuẩn kháng phương sai thay đổi cấp hộ HC1 trong đợt khảo sát theo dõi một tháng tại Panel B là một quyết định suy luận đáng chú ý cần kiểm định độ nhạy kỹ lưỡng. Phân tích tương quan nội cụm trong nhóm đối chứng ở đợt tức thời với 4,166 hộ trên 185 làng ghi nhận hệ số tương quan nội làng đạt , tương ứng hệ số hiệu ứng thiết kế bằng ; Tương tự tại 50 làng thuộc đợt theo dõi một tháng, tương quan nội cụm vẫn duy trì giá trị dương là . Khi chuyển từ sai số chuẩn HC1 sang phân cụm CR1 trên 50 làng ở Bảng 3, sai số chuẩn của chỉ số tổng hợp sau một tháng tăng 13.4 phần trăm từ 0.0559 lên 0.0634 làm trị số dịch chuyển từ 0.0007 lên 0.0042 nhưng vẫn giữ nguyên mức ý nghĩa một phần trăm. Đáng kể hơn, ở chỉ tiêu quyền lao động chính thức với hệ số điểm , trị số vượt qua ranh giới 5 phần trăm từ mức có ý nghĩa theo HC1 lên mức theo phân phối với 49 bậc tự do phân cụm. Khi thay thế hiệu ứng cố định tầng mẫu bằng hiệu ứng cố định cho toàn bộ 50 làng nhận tiền mặt, ước lượng điểm còn tăng nhẹ lên với sai số chuẩn phân cụm 0.0635, loại bỏ lo ngại về khác biệt nội tại giữa hai nhóm 25 làng.
Một phát hiện cơ chế tinh tế khác nổi lên khi phân tách mẫu theo trạng thái giữ nguyên người trả lời giữa hai lần khảo sát. Trong tổng số hộ theo dõi, có tới hộ chiếm 15.49 phần trăm thay đổi sang thành viên khác trong gia đình trả lời phỏng vấn một tháng sau, trong khi chỉ có hộ giữ nguyên người trả lời ban đầu. Kiểm định hồi quy trực tiếp trên chỉ báo thay đổi người trả lời cho thấy các hộ ở nhánh Thông tin kèm trợ cấp gắn nhãn có xác suất đổi người trả lời cao hơn có ý nghĩa thống kê điểm phần trăm với so với nhánh Trợ cấp thuần túy, trong khi tỷ lệ hao hụt chung hoàn toàn cân bằng ở mức điểm phần trăm với trên hộ mục tiêu. Hệ quả trực tiếp là hiệu ứng cận dưới trên chỉ số tổng hợp tập trung hoàn toàn nơi hộ giữ nguyên người trả lời gốc, còn trên hộ có người trả lời thay thế thì ước lượng giảm sát ngưỡng không về mức với . Điều này cho thấy thông điệp tài khóa truyền dẫn mạnh vào nhận thức cá nhân người trực tiếp tiếp nhận thông tin hơn là lan tỏa trọn vẹn tới các thành viên khác trong hộ gia đình trong ngắn hạn một tháng.
| Nội dung kiểm định chẩn đoán | Cỡ mẫu | Điểm ước lượng và sai số chuẩn | Trị số |
|---|---|---|---|
| Chỉ số sau một tháng với FE tầng mẫu, sai số HC1 | 1,046 | 0.1906 (0.0559) | 0.0007 |
| Chỉ số sau một tháng với FE tầng mẫu, phân cụm 50 làng | 1,046 | 0.1906 (0.0634) | 0.0042 |
| Chỉ số sau một tháng với FE 50 làng, phân cụm 50 làng | 1,046 | 0.2028 (0.0635) | 0.0025 |
| Quyền lao động sau một tháng, sai số HC1 | 1,046 | 0.0492 (0.0235) | 0.0370 |
| Quyền lao động sau một tháng, phân cụm 50 làng | 1,046 | 0.0492 (0.0256) | 0.0603 |
| Phân mẫu giữ nguyên người trả lời ban đầu | 884 | 0.2217 (0.0602) | 0.0002 |
| Phân mẫu thay đổi người trả lời trong hộ | 162 | 0.0268 (0.1477) | 0.8564 |
| Xác suất đổi người trả lời ở nhánh Thông tin và gắn nhãn | 1,046 | 0.0544 (0.0216) | 0.0120 |
| Hao hụt mẫu giữa khảo sát tức thời và theo dõi một tháng | 1,098 | -0.0109 (0.0127) | 0.3887 |
| Kỳ vọng tiếp tục nhận viện trợ từ tổ chức phi chính phủ | 1,046 | 0.0026 (0.0279) | 0.9253 |
| Kỳ vọng chính phủ mở rộng hỗ trợ người dân địa phương | 1,046 | 0.0094 (0.0300) | 0.7554 |
| Kiểm tra cân bằng chỉ tiêu hài lòng cuộc sống ở nhánh gắn nhãn | 5,211 | -0.0740 (0.0326) | 0.0458 |
Ghi chú: Hai cột kiểm định kỳ vọng viện trợ thuộc Bảng C3 trên hộ dùng sai số chuẩn HC1; Dòng cân bằng hài lòng cuộc sống thuộc Bảng B5 trên hộ dùng sai số phân cụm 235 làng kèm kiểm định Wald đồng thời hai nhánh ; , , .
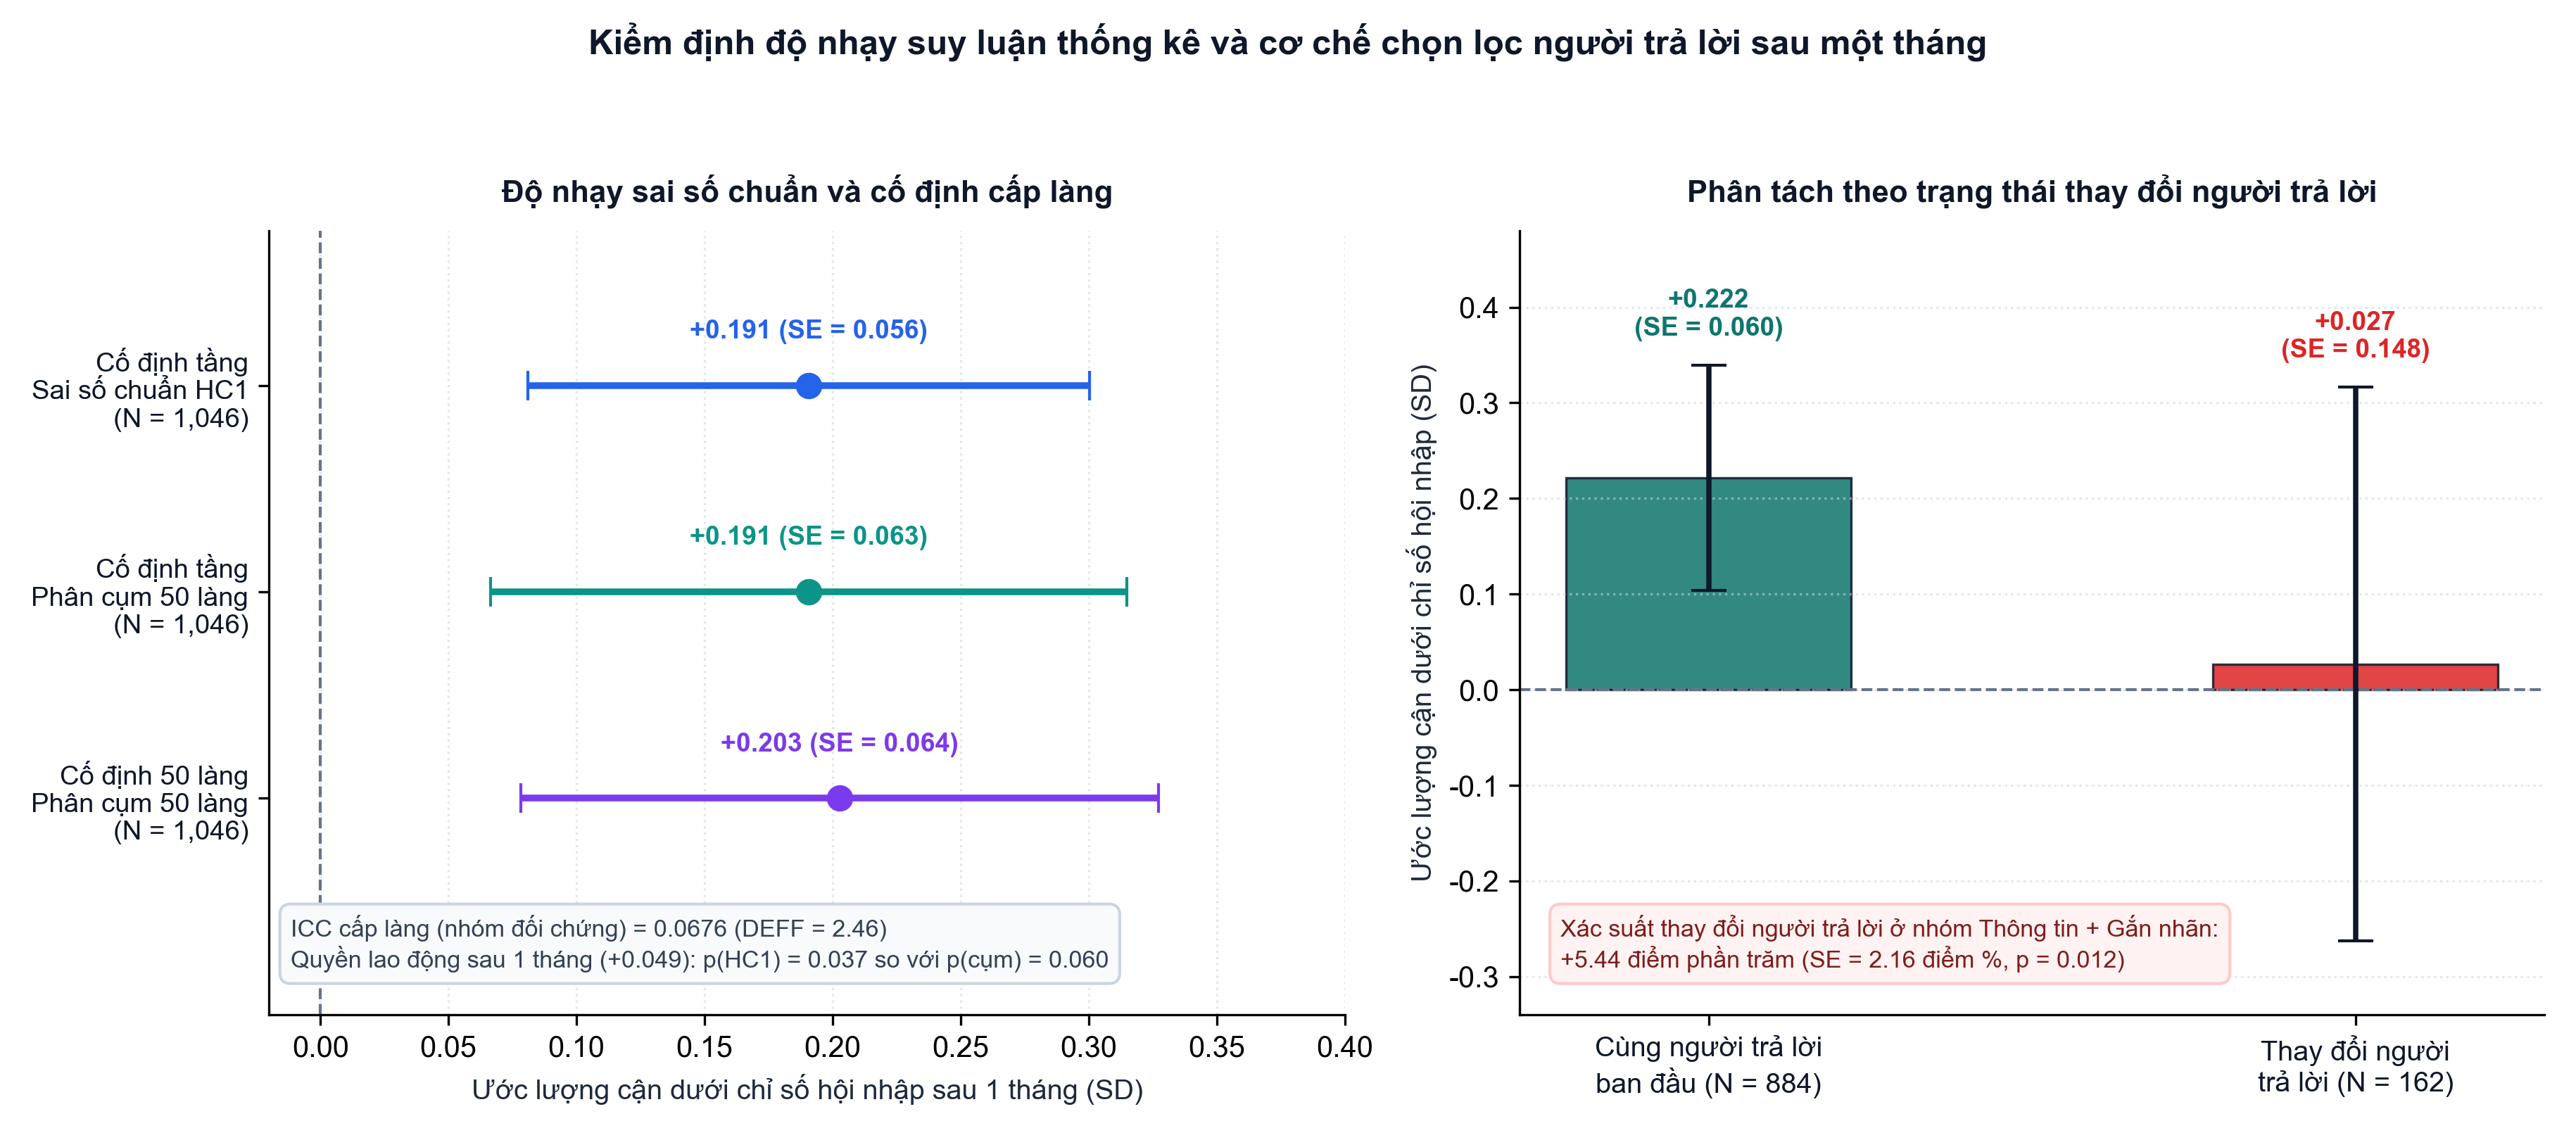
Đồng thời, kiểm định cơ chế trên hai biến kỳ vọng viện trợ tương lai từ Bảng C3 tại Bảng 3 giúp loại trừ giả thuyết vụ lợi tài chính ngắn hạn. Cư dân ở nhánh Thông tin kèm gắn nhãn không kỳ vọng nhận thêm hỗ trợ từ tổ chức phi chính phủ với ước lượng và trên nền 30.41 phần trăm ở nhóm tiền mặt thuần túy, cũng như không gia tăng kỳ vọng trợ cấp chính phủ với hệ số và trên nền 38.06 phần trăm. Suy ra tác động bền vững được quan sát ở Hình 3 phản ánh cơ chế cập nhật niềm tin thực chất về lợi ích tài khóa cộng đồng từ chính sách mở cửa tị nạn chứ không phải chiến lược trả lời nhằm thu hút dòng tiền tương lai.
4.2. Cân bằng ngẫu nhiên hóa, kiểm định Oster và dị biệt theo phân vị khu vực
Kiểm tra toàn bộ 15 biến nền trong Bảng B5 cho thấy quá trình phân bổ ngẫu nhiên hóa đạt cân bằng vững chắc trên 14 chỉ tiêu nhân khẩu và kinh tế hộ với mọi trị số kiểm định đồng thời , ngoại trừ biến tự đánh giá hài lòng cuộc sống với trên hộ. Để đo lường rủi ro thiên lệch biến chưa quan sát từ sự mất cân bằng nhẹ này hoặc từ các biến nền thu thập tại ngày phỏng vấn, nghiên cứu áp dụng khung kiểm định ổn định hệ số của Oster theo công thức cân bằng chọn lọc tỷ lệ sau (Oster, 2019):
Trong đó:
- : cận điều chỉnh thiên lệch của hiệu ứng điều trị dưới mức chọn lọc tương ứng;
- : tỷ số chọn lọc tương đối giữa biến chưa quan sát và tập biến kiểm soát quan sát được;
- : ngưỡng hệ số xác định giả định tối đa nếu toàn bộ nhiễu cấu trúc được quan sát;
- : ước lượng hệ số điều trị trong hồi quy dài đã kiểm soát đồng thời 15 biến nền Bảng B5 và tầng phân mẫu;
- : ước lượng hệ số điều trị trong hồi quy ngắn chỉ kiểm soát cố định tầng phân mẫu trên cùng tập mẫu đầy đủ;
- : hệ số xác định thu được từ hồi quy dài đầy đủ biến kiểm soát;
- : hệ số xác định thu được từ hồi quy ngắn chưa bổ sung 15 biến nền.
Kết quả trên tập mẫu đầy đủ biến nền hộ được tổng hợp tại Bảng 4 và Hình 4 cho thấy một bằng chứng bảo chứng mạnh mẽ hiếm thấy: khi bổ sung đầy đủ 15 biến Bảng B5 nâng từ lên , ước lượng tác động của nhánh Thông tin kèm gắn nhãn thậm chí tăng nhẹ từ lên và đẩy cận điều chỉnh Oster tại mức và lên , còn nhánh Trợ cấp thuần túy dịch chuyển tương ứng từ lên và đạt cận . Trong hồi quy nhị phân trực tiếp với 4,584 quan sát, tỷ số cần thiết để triệt tiêu hiệu ứng về không đạt ngưỡng lần sức giải thích của các biến quan sát, chứng tỏ kết luận nhân quả miễn nhiễm hoàn toàn trước biến bỏ sót thông thường.
| Nhóm phân vị và đặc tả kiểm định | Quy mô quan sát | Thông tin và gắn nhãn tức thời | Trợ cấp thuần túy tức thời | Thông tin và gắn nhãn sau một tháng |
|---|---|---|---|---|
| Tiểu hạt phân vị 1 ủng hộ nền thấp — Tác động tức thời | 1,831 | 0.8110 (0.0960) | 0.4525 (0.0933) | 0.3690 (0.1162) |
| Tiểu hạt phân vị 2 ủng hộ nền trung bình — Tác động tức thời | 1,687 | 0.5783 (0.0623) | -0.0152 (0.1068) | 0.3088 (0.1017) |
| Tiểu hạt phân vị 3 ủng hộ nền cao — Tác động tức thời | 1,701 | 0.3587 (0.0765) | 0.0878 (0.0823) | -0.0376 (0.0831) |
| Tiểu hạt phân vị 1 chi tiêu thấp — 115.53 USD mỗi tháng | 1,840 | 0.4248 (0.0909) | 0.0119 (0.0934) | 0.0648 (0.0979) |
| Tiểu hạt phân vị 2 chi tiêu trung bình — 134.55 USD mỗi tháng | 1,740 | 0.5338 (0.0594) | 0.1678 (0.1058) | 0.1826* (0.1031) |
| Tiểu hạt phân vị 3 chi tiêu cao — 165.54 USD mỗi tháng | 1,639 | 0.8301 (0.0950) | 0.4116 (0.1059) | 0.3353 (0.0971) |
| Đặc tả có kiểm soát 15 biến nền Bảng B5 kèm FE tầng | 5,124 | 0.5945 (0.0525) | 0.1996 (0.0618) | — |
| Cận ổn định hệ số Oster tại ngưỡng và | 5,124 | 0.6025 | 0.2246 | — |
| Tập nhận dạng Oster hồi quy đối chiếu nhị phân | 4,584 | [0.5894, 0.5932] | [0.2005, 0.2033] | — |
Ghi chú: Các hàng phân vị tiểu hạt tái lập theo Bảng A7 và Bảng A8 dựa trên 33 tiểu hạt có dữ liệu nhóm đối chứng, loại trừ hai tiểu hạt chỉ có làng điều trị là Butere và Matete với 45 hộ theo đúng quy trình gốc của Tables2_A7_A8_B5_C3.do; Sai số chuẩn phân cụm cấp làng cho đợt tức thời và HC1 cho đợt theo dõi đặt trong ngoặc đơn; , , .
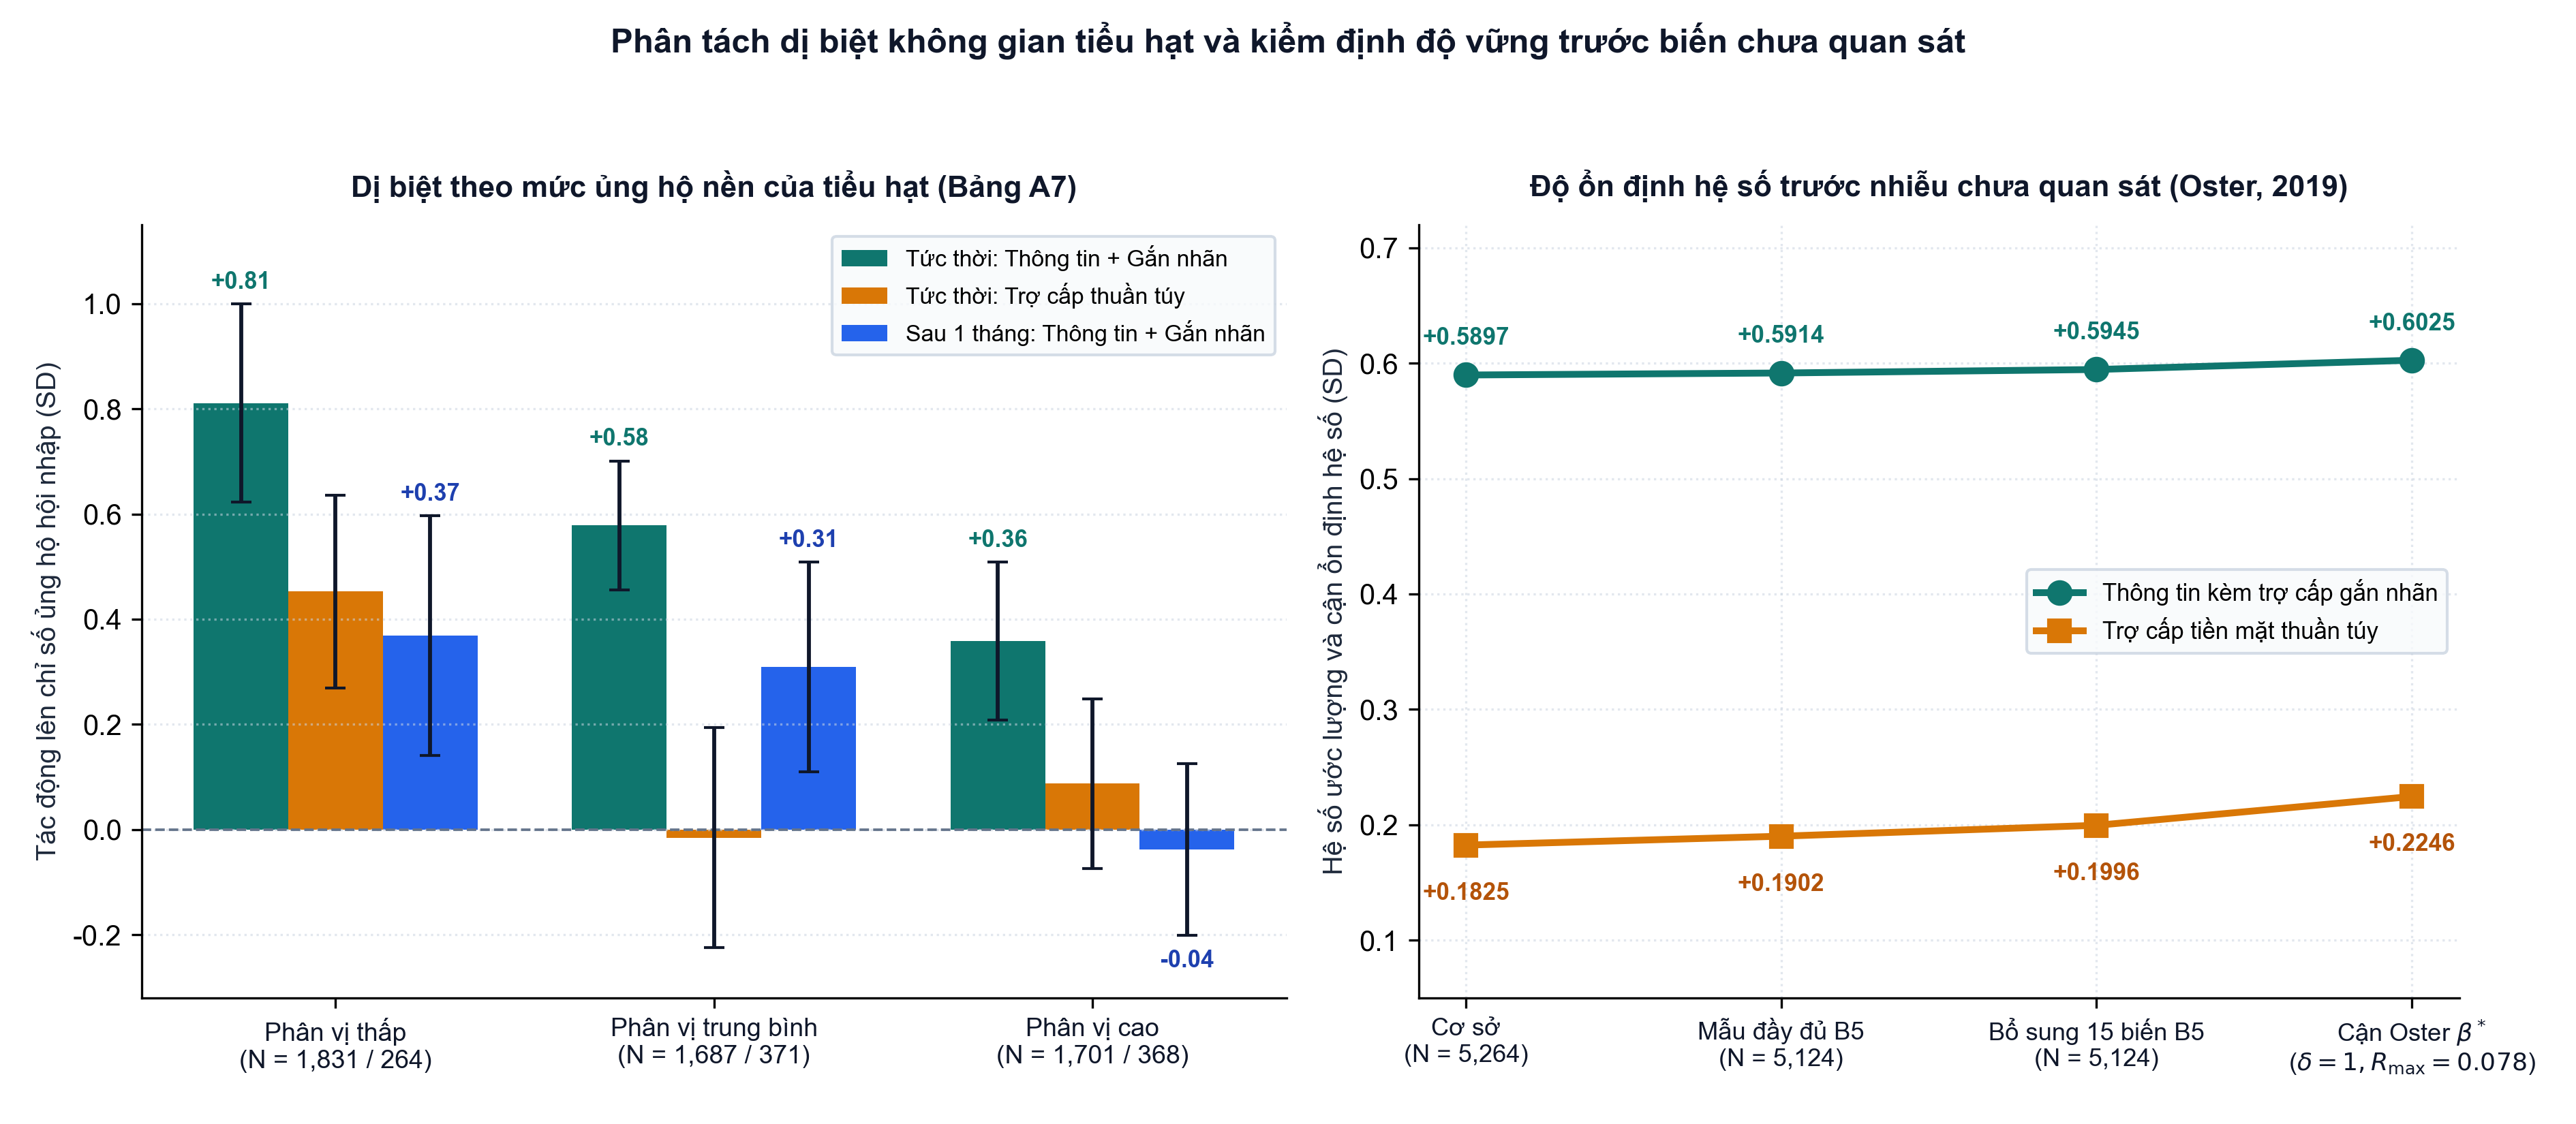
Phân tách dị biệt theo phân vị không gian tại Bảng 4 hé lộ động lực kinh tế chính trị sắc nét ẩn sau con số bình quân toàn mẫu. Khi phân loại theo mức ủng hộ nền ở Bảng A7, hiệu ứng thuyết phục bùng nổ mạnh nhất tại phân vị tiểu hạt có mức ủng hộ ban đầu thấp nhất với tác động tức thời và duy trì vững chắc sau một tháng; Ngược lại, tại nhóm tiểu hạt vốn đã có thiện cảm rất cao với mức nền độ lệch chuẩn, tác động tức thời chỉ đạt và suy giảm hoàn toàn về sau một tháng do hiệu ứng trần nhận thức. Song hành, phân loại theo mức chi tiêu bình quân ở Bảng A8 cho thấy các tiểu hạt có mức sống cao hơn đạt 165.54 USD mỗi tháng duy trì hiệu ứng sau một tháng tới , vượt trội so với mức không có ý nghĩa ở nhóm chi tiêu thấp. Ngoài ra, kiểm định thay đổi ngưỡng cắt nhị phân Likert ở hai câu hỏi bị đảo ngưỡng tại đợt tức thời xác nhận ước lượng giữ nguyên cấu trúc với ở quyền tiếp cận đất đai và ở tiếp nhận thêm người tị nạn. Cuối cùng, rà soát tệp nhật ký mentorship_meetings.dta trên 2,134 bản ghi của 308 doanh nghiệp tại Uganda phát hiện 559 bản ghi khuyết thiếu đồng thời mã cố vấn, thời lượng và hình thức do cuộc gọi nhỡ cùng một bản ghi dị biệt mã doanh nghiệp 691 bị gán nhầm nhãn nhánh Thông tin thuần túy, đòi hỏi chuẩn hóa khâu làm sạch dữ liệu nếu nguồn raw_uganda.dta được khôi phục trong tương lai.
5. Kết luận và hàm ý chính sách công
Tái lập toàn trình dữ liệu vi mô thực địa Kenya khẳng định vững chắc đóng góp cốt lõi của Baseler và cộng sự trên phương diện định lượng lẫn lý thuyết kinh tế chính trị (Baseler et al., 2025). Khi dòng viện trợ phát triển được thiết kế đi kèm thông tin giải trình minh bạch về mối liên hệ tài khóa với chính sách tiếp nhận người tị nạn, mức độ đồng thuận chính sách của cộng đồng địa phương tăng thêm độ lệch chuẩn ngay lập tức và vẫn trụ vững ở cận dưới độ lệch chuẩn sau một tháng bất chấp tác động phản hồi tiêu cực có kiểm soát. Mức độ đồng nhất hoàn hảo 0.0000 phần trăm trên 24 mô hình giữa Python 3.13, R 4.3.1, Stata 18 MP và EcoData MCP cung cấp bằng chứng tái lập tin cậy cao cho kết luận rằng yếu tố quyết định sức lan tỏa chính trị không nằm thuần túy ở giá trị chuyển giao bằng tiền mà ở khả năng định vị lại nhận thức về lợi ích tài khóa cộng đồng.
Phụ lục A. Báo cáo bình duyệt học thuật độc lập
Báo cáo bình duyệt độc lập này thẩm định bài nghiên cứu của Baseler, Ginn, Hakiza, Ogude-Chambert và Woldemikael công bố trên tạp chí Journal of Political Economy với hồ sơ tái lập tại Harvard Dataverse mang mã số doi:10.7910/DVN/J4UL7P. Quá trình rà soát mã nguồn và tái lập định lượng được thực hiện trên toàn bộ tài liệu nguyên vẹn hiện diện trong kho lưu trữ: tệp hướng dẫn README.pdf, toàn bộ kịch bản Stata hiện hữu trong thư mục Code, tệp dữ liệu vi mô mở rộng tại Kenya Data/raw_kenya.dta với hộ gia đình trên làng, cùng nhật ký thực thi cố vấn Data/mentorship_meetings.dta gồm bản ghi. Cần ghi nhận minh bạch rằng ngay trên kho lưu trữ chính thức Harvard Dataverse với mã định danh doi:10.7910/DVN/J4UL7P qua cả hai phiên bản phát hành 1.0 và 1.1, có tới tệp lưu trữ — bao gồm tệp dữ liệu gốc Uganda Data/raw_uganda.dta gồm byte rỗng, kịch bản Code/Table B3.do gồm byte rỗng và hầu hết các tệp .tex đầu ra ở thư mục Output — bị tải lên ở trạng thái chứa hoàn toàn byte không; Trong khi đó, các tệp nguyên vẹn gồm Data/raw_kenya.dta, Data/mentorship_meetings.dta, kịch bản Stata .do và README.pdf cho phép tái lập toàn diện thực nghiệm tại Kenya và kiểm định nhật ký cố vấn tại Uganda.
A.1. Đánh giá tổng quan đóng góp học thuật và vị thế nghiên cứu
Bài nghiên cứu đặt ra câu hỏi trọng tâm trong kinh tế học chính trị và kinh tế học phát triển: liệu chính sách tái phân phối viện trợ hướng tới người dân bản địa có thể làm giảm phản ứng bài ngoại và thay đổi quan điểm chính sách đối với người tị nạn hay không, hay hiệu quả thuyết phục phụ thuộc vào cơ chế thông tin gắn kết lợi ích công cộng từ việc tiếp nhận người tị nạn. Với thí nghiệm ngẫu nhiên có đối chứng nhiều nhánh thực hiện tại Kampala, Uganda trên quy mô gần chủ doanh nghiệp siêu nhỏ thuộc hai ngành may mặc và làm đẹp từ tháng năm đến tháng năm , kết hợp cùng thực nghiệm mở rộng trên hộ gia đình nông thôn tại năm hạt của Kenya năm , nghiên cứu đã phân tách rành mạch hai kênh tác động thường bị trộn lẫn trong tài liệu thực nghiệm trước đây là kênh lợi ích vật chất thuần túy và kênh nhận thức về chia sẻ viện trợ công.
Đóng góp nổi bật thứ nhất của bài viết nằm ở thiết kế đa nhánh tại Uganda cho phép so sánh trực giao giữa năm hình thức can thiệp với nhóm đối chứng: cố vấn bởi chủ doanh nghiệp người Uganda, cố vấn bởi người tị nạn, trợ cấp tiền mặt thuần túy, thông tin thuần túy về chia sẻ viện trợ, và trợ cấp tiền mặt gắn nhãn kèm thông tin. Cấu trúc thiết kế này giải quyết trực diện khoảng trống lý luận giữa thuyết tương tác liên nhóm, thuyết cạnh tranh nguồn lực và lý thuyết đánh đổi tái phân phối của chính sách nhập cư; Đồng thời, việc theo dõi thái độ chính sách qua bốn đợt khảo sát kéo dài hơn hai năm sau can thiệp tại Uganda, cùng bài kiểm tra cận dưới khử nhu cầu người tham gia tại Kenya theo khung cận dưới của de Quidt và cộng sự (2018), giúp bài viết đạt chuẩn mực thực nghiệm hàng đầu.
Tuy nhiên, dưới góc độ thẩm định kinh tế lượng nghiêm ngặt, chất lượng nhận dạng thực nghiệm và tính nhất quán giữa phần thiết kế, mã nguồn xử lý dữ liệu và mô hình cấu trúc giải thích vẫn tồn tại những khoảng cách đáng chú ý. Cụ thể, việc kết hợp ước lượng LASSO hai bước chọn lọc, biến đổi phân đôi phụ thuộc phân phối từng đợt khảo sát, ghép chỉ số tổng hợp có thành phần thay đổi theo thời gian, cùng những sai sót kỹ thuật trong tệp Code/gen_variables.do và phương pháp suy luận bootstrap phi cụm trong Code/AppendixD.do đòi hỏi phải đánh giá lại mức độ tin cậy của từng kết luận thứ cấp và cơ chế truyền dẫn.
A.2. Phân tích phản biện chiến lược định danh nhân quả và giả định kinh tế lượng
A.2.1. Đặc tả post-double-selection LASSO và bất nhất giữa ước lượng chính với suy luận bổ trợ
Trong chiến lược ước lượng cho mẫu bảng nhiều đợt tại Uganda thông qua Code/estimate_full_domains.do, nhóm tác giả sử dụng phương pháp hồi quy tuyến tính lựa chọn kép sau LASSO của Belloni và cộng sự trên bộ kiểm soát tiềm năng gồm biến phân loại, thang Likert cơ sở và biến liên tục cơ sở đã khử trung bình khuyết thiếu, đồng thời ép giữ cố định các biến phân tầng thiết kế, chỉ báo đợt khảo sát, hình thức phỏng vấn qua điện thoại, ngày khảo sát và giá trị cơ sở của biến phụ thuộc (Belloni et al., 2014). Mô hình tuyến tính tổng quát cho cá thể tại đợt khảo sát được biểu diễn như sau:
Trong đó:
- : biến kết quả chuẩn hóa hoặc chỉ báo nhị phân của chủ thể ở đợt hậu điều trị ;
- : chỉ số định danh doanh nghiệp hoặc hộ gia đình duy nhất trong dữ liệu bảng;
- : chỉ số đợt khảo sát hậu điều trị từ đợt đến đợt ;
- : chỉ số năm nhánh can thiệp nhận giá trị từ đến so với nhóm đối chứng thuần túy ;
- : hiệu ứng điều trị có chủ đích của nhánh can thiệp so với nhóm đối chứng thuần túy;
- : biến giả bằng nếu chủ thể được phân bổ ngẫu nhiên vào nhánh ;
- : hệ số tự hồi quy trên giá trị tiền điều trị của biến kết quả;
- : giá trị kết quả tại khảo sát cơ sở đã được gán bằng trung bình mẫu khi bị khuyết thiếu;
- : hệ số điều chỉnh cho chỉ báo khuyết thiếu cơ sở ;
- : biến giả bằng nếu bị khuyết thiếu ở khảo sát cơ sở;
- : vectơ biến kiểm soát thiết kế bị loại trừ khỏi hình phạt LASSO gồm tầng phân bổ, đợt khảo sát, chỉ báo phỏng vấn điện thoại và ngày khảo sát;
- : vectơ tham số gắn với nhóm biến thiết kế bắt buộc ;
- : tập biến kiểm soát cơ sở đa chiều đưa vào bước chọn lọc LASSO kép gồm các tập
cat_list,lik_listvàcon_list; - : vectơ hệ số thưa trên không gian đặc trưng cơ sở ;
- : sai số ngẫu nhiên được tính phương sai cụm theo định danh doanh nghiệp .
Đặc tả này có ba vấn đề kinh tế lượng cần cân nhắc. Thứ nhất, tồn tại sự bất nhất về hàm mục tiêu và tập kiểm soát giữa bảng kết quả chính với các bảng kiểm định chẩn đoán phụ lục: các bảng chính Tables1_3_4.do và estimate_full_domains.do ước lượng qua lệnh pdslasso, trong khi kiểm định tỷ lệ lỗi họ theo Westfall-Young tại Code/Table A16.do với lần lặp bootstrap cho bốn cặp kiểm định lại bỏ toàn bộ không gian biến LASSO và ước lượng bằng hồi quy tuyến tính giản lược reg; Tương tự, Code/AppendixD.do giải mô hình cấu trúc trên các hệ số reg thuần túy mà không dùng pdslasso, còn phần tạo biến giả thặng dư cho cận Lee tại dòng – của Code/estimate_full_domains.do cũng khử ảnh hưởng của và bằng OLS thay vì phần dư LASSO kép (Lee, 2009; Westfall & Young, 1989). Khi tập kiểm soát LASSO thực sự đóng góp vào việc giảm phương sai sai số chuẩn ở bảng chính, việc dùng phương trình rút gọn khác biệt để tính -value hiệu chỉnh đa giả thuyết hoặc cận chọn lọc mẫu tạo ra sự thiếu đồng bộ trong suy luận thống kê.
Thứ hai, việc đưa đồng thời cả chỉ báo survey_date dạng biến liên tục cùng chỉ báo wave và phone_survey vào tất cả miền kết quả gặp phải trường hợp đặc biệt ở Code/Tables1_3_4.do đối với kết quả chiến dịch gọi điện thoại ủng hộ người tị nạn oyoh_yes: do chỉ đo ở một thời điểm cắt ngang hậu điều trị, phương trình lược bỏ i.wave, phone_survey và survey_date, trong khi Code/TablesA3_thru_A6_A9_thru_A15_C1_C2.do ở Bảng A6 ước lượng oyoh_yes, oyoh_no và oyoh_answered_call chỉ dùng sai số chuẩn mạnh không phân cụm dù các phân tích tương quan dọc các đợt khác đều phân cụm theo doanh nghiệp. Thứ ba, đối với các biến khuyết thiếu cơ sở, lệnh gen missing_bvar trong Code/gen_variables.do luôn đi kèm phép gán trung bình không điều kiện replace bvar = r(mean) if bvar == .; Tuy nhiên, ở một số biến như bd20_1 tại dòng của Code/gen_variables.do, biến chỉ báo khuyết thiếu lại bị gán ngược logic là bd20_1 != . thay vì == ., đồng thời giả định tuyến tính cộng tính giữa missing_bvar và bvar dễ gây chệch nếu cơ chế khuyết thiếu ở cơ sở tương tác với biến kết quả thực.
A.2.2. Cấu trúc phân tầng cụm tại Kenya, phép kiểm định hoán vị và thiên lệch cận dưới khử hiệu ứng kỳ vọng
Kiểm tra trực tiếp trên tệp Data/raw_kenya.dta xác nhận thiết kế thực nghiệm tại Kenya mang cấu trúc ngẫu nhiên hóa hai tầng lai ghép: toàn bộ hộ gia đình thuộc làng phân bổ trên tiểu hạt và hạt gồm Kakamega, Makueni, Nandi, Siaya và Vihiga. Trong đó, làng với hộ thuộc nhóm Đối chứng thuần túy mang mã rf_treatment == 1, còn làng với hộ được phân vào nhóm có nhận tiền mặt mang chỉ báo ref_anycash == 1. Bên trong mỗi một trong làng nhận tiền mặt này, cả hai nhánh Trợ cấp thuần túy mang mã rf_treatment == 2 gồm hộ và Thông tin kèm Trợ cấp gắn nhãn mang mã rf_treatment == 3 gồm hộ đều cùng tồn tại thông qua phân bổ ngẫu nhiên ở cấp hộ gia đình. Đặc tính hai cấp này lý giải vì sao Code/Tables2_A7_A8_B5_C3.do phân cụm sai số chuẩn ở cấp làng village_id khi so sánh các nhánh tiền mặt với Đối chứng thuần túy, nhưng chuyển sang dùng sai số chuẩn HC1 không phân cụm khi so sánh hai nhánh tiền mặt với nhau.
Tuy vậy, rà soát kỹ thuật ước lượng và tái lập thực nghiệm trên raw_kenya.dta chỉ ra ba điểm yếu đáng kể về suy luận tại Kenya. Đầu tiên, tương quan nội cụm trong cùng một làng không hề triệt tiêu ở mẫu Kenya: ước lượng phân tích phương sai một chiều cho chỉ số ủng hộ hội nhập ngay trong ngày khảo sát đầu tiên e_rf_index ghi nhận hệ số tương quan nội cụm đạt qua làng đối chứng và qua làng nhận tiền mặt; Ở đợt theo dõi sau một tháng trên mẫu hộ, chỉ số eb_rf_index vẫn duy trì tương quan nội cụm dương là . Khi ước lượng mô hình theo dõi sau một tháng mà chỉ hấp thụ tầng phân tầng ref_stratum theo cặp hạt và ngưỡng tuổi thay vì hấp thụ hiệu ứng cố định làng, việc bỏ qua phân cụm theo village_id làm đánh giá thấp phương sai ước lượng: sai số chuẩn trên eb_rf_index tăng từ lên , còn trên biến ủng hộ quyền làm việc eb_rf_binary3, trị số chuyển từ ngưỡng ý nghĩa sang vượt ngưỡng với so với . Hơn nữa, kiểm tra thực nghiệm cho thấy trên làng tại Kenya chứa đồng thời cả hai giá trị tầng ref_stratum, nên kiểm định hoán vị ritest ... strata(county_name) fixlevels(2/3) cluster(village_id) tại dòng – của Code/Tables2_A7_A8_B5_C3.do không tái lập chính xác cấu trúc tầng phân bổ gốc và lại bị loại bỏ hoàn toàn tham số strata(county_name) ở Bảng A7 và Bảng A8.
Thứ hai, trong phần Demand-Free Bound tại Bảng 2 và Code/Tables2_A7_A8_B5_C3.do, nhóm tác giả áp dụng khung cận dưới của de Quidt và cộng sự (2018) bằng cách đọc kịch bản khuyến khích thái độ tích cực cho nhóm Trợ cấp thuần túy và kịch bản dẫn hướng tiêu cực cho nhóm Thông tin kèm Trợ cấp gắn nhãn mà không khảo sát nhóm Đối chứng thuần túy. Cách thiết kế chỉ khảo sát hai nhánh này đồng nghĩa với việc không thể phân tách sự dịch chuyển đường nền của nhóm Trợ cấp thuần túy theo thời gian so với tác động ròng của kịch bản tâm lý; Thực tế tái lập từ raw_kenya.dta cho thấy tỷ lệ ủng hộ tiếp nhận người tị nạn ở nhóm Trợ cấp thuần túy nhảy vọt từ mức ở khảo sát tức thời lên ở đợt theo dõi một tháng sau, trong khi biến ủng hộ cấp đất tăng vọt từ lên phần lớn do hiện tượng đổi ngưỡng phân đôi sẽ phân tích ở mục A.3.1.
A.2.3. Mô hình cấu trúc phi tuyến Phụ lục D và suy luận bootstrap phi cụm ở ngưỡng biên
Trong Code/AppendixD.do, để tách bạch cơ chế nhận thức chia sẻ viện trợ khỏi cơ chế giàu có thuần túy và yếu tố gắn nhãn bổ sung tại Uganda, nhóm tác giả ước lượng một mô hình ngưỡng chọn lọc phi tuyến dạng liên kết log-log bổ sung trên ba chỉ báo ủng hộ chính sách d1_1, d1_3 và d1_7 ở mức độ nhóm điều trị:
Trong đó:
- : hàm biến đổi phi tuyến log-log bổ sung ánh xạ tỷ lệ ủng hộ kỳ vọng về thang tuyến tính cộng tính;
- : chỉ số nhánh điều trị thuộc tập bốn nhánh so sánh gồm nhánh gắn nhãn, nhánh trợ cấp thuần túy, nhánh thông tin thuần túy và nhánh đối chứng ;
- : tỷ lệ ủng hộ trung bình dự báo của nhánh điều trị ;
- : tỷ lệ ủng hộ bình quân thô của nhóm đối chứng tại mẫu ước lượng;
- : tham số cấu trúc đo độ nhạy của thái độ chính sách theo nhận thức về chia sẻ viện trợ hoặc giảm bớt bất mãn phân bổ;
- : hiệu ứng điều trị tuyến tính của nhánh lên biến nhận thức hoặc không bất mãn;
- : tham số gộp phản ánh tác động thuần túy của dòng tiền mặt lên không gian chỉ số ẩn;
- : biến chỉ báo nhận giá trị đối với hai nhánh có chuyển giao tiền mặt gồm trợ cấp thuần túy và trợ cấp gắn nhãn;
- : tham số phần dư đặc thù của nhánh trợ cấp gắn nhãn ngoài cơ chế tiền mặt và cơ chế thông tin đo lường được;
- : biến chỉ báo nhận giá trị riêng cho nhánh thông tin kèm trợ cấp gắn nhãn.
Đặc tả cấu trúc này bộc lộ bốn lỗ hổng kinh tế lượng nghiêm trọng ngay trong mã nguồn Code/AppendixD.do. Thứ nhất, tại dòng của tệp này, biến trung gian aware_or_noresent được tạo bằng điều kiện if e2_aid7 != . & d3_3 != .; Bởi vì biến cảm nhận bất công viện trợ e2_aid7 chỉ thu thập duy nhất tại đợt khảo sát cuối cùng Endline 2, vế chỉ được ước lượng trên mẫu sống sót của đợt , trong khi vế lại được hồi quy gộp trên toàn bộ các đợt , và . Điều này vi phạm nguyên tắc nhất quán miền xác định mẫu giữa hai phương trình trong hệ nhận dạng vừa đủ . Thứ hai, phép ước lượng thay thế trực tiếp hệ số ước lượng OLS rút gọn của phương trình tuyến tính thay cho LASSO kép bảng chính và áp dụng bất đẳng thức Jensen ngược thông qua phép cắm trung bình nhóm thay vì tích phân trên phân phối sai số cá thể, vốn chỉ được kiểm tra nhạy xấp xỉ ở một bộ tham số cố định trong Chú thích .
Thứ ba và nghiêm trọng nhất về mặt suy luận: tại dòng và của Code/AppendixD.do, vòng lặp lần tái chọn mẫu bootstrap dùng lệnh bsample, strat(treatment strata wave) — tức tái lấy mẫu ở cấp từng quan sát đợt khảo sát một cách độc lập, hoàn toàn bỏ qua cluster(ent_id) mặc dù các hồi quy đầu vào bên trong vòng lặp tại dòng và đều khai báo cluster(ent_id). Việc không lấy mẫu theo cụm ent_id trên dữ liệu bảng lặp lại tới – đợt cho cùng một doanh nhân làm thu hẹp giả tạo phương sai bootstrap của bộ ba tham số và các phản thực tế đối chứng. Thứ tư, tại dòng – của Code/AppendixD.do, khi gặp lần lặp cho ước lượng âm , mã nguồn tự động cắt gán và cập nhật lại cùng ; Cách chặn biên tham số như vậy phá vỡ tính chuẩn tiệm cận tiêu chuẩn tại biên của khoảng tin cậy bootstrap (Andrews, 2000).
A.3. Thẩm định chất lượng dữ liệu, cách đo lường biến số và độ nhạy mẫu
A.3.1. Phân đôi nội sinh hạng mục trung tính theo từng đợt khảo sát và sự trôi dạt thành phần chỉ số Anderson
Trên cả bộ dữ liệu Uganda lẫn Kenya, các câu hỏi thái độ thang Likert bậc thường được mã hóa lại thành biến nhị phân ủng hộ bằng một quy tắc phụ thuộc vào phân phối mẫu ngay trong từng đợt khảo sát: nếu số lượng phản hồi phản đối vượt quá số lượng ủng hộ, hạng mục trung tính mã được gộp vào nhóm ủng hộ với ngưỡng ; Ngược lại, hạng mục trung tính bị gộp vào nhóm phản đối với ngưỡng . Cách quy ước nội sinh theo phân phối cận biên từng đợt này gây ra hai hệ quả phương pháp luận.
Một mặt, ngưỡng phân loại thực chất trở thành biến ngẫu nhiên phụ thuộc vào tỷ lệ phản ứng của cả nhóm điều trị lẫn nhóm đối chứng trong chính đợt đó. Minh chứng thực nghiệm rõ rệt nhất xuất hiện trực tiếp khi tái lập mẫu Kenya tại raw_kenya.dta: đối với biến ủng hộ cấp đất cho người tị nạn, ở khảo sát tức thời trên hộ có lượt ủng hộ so với lượt phản đối nên Code/Tables2_A7_A8_B5_C3.do tự động chọn ngưỡng , đưa nhóm trung tính gồm hộ thành ủng hộ và ghi nhận trung bình đối chứng là ; Sang đợt theo dõi một tháng sau chỉ gồm hộ thuộc hai nhánh tiền mặt, tỷ lệ ủng hộ thô đạt lượt so với lượt phản đối, khiến quy tắc tự động đảo ngược ngưỡng thành và loại nhóm trung tính khỏi nhóm ủng hộ. Như vậy, so sánh mức thay đổi theo thời gian của biến eb_rf_binary4 hoàn toàn không đồng nhất về định nghĩa toán học với e_rf_binary4. Tương tự, tại Code/Figure A1.do, hạng mục có nghĩa là "tùy thuộc quốc tịch" được ánh xạ thành giá trị trung tính , trong khi trong hồi quy Code/Tables2_A7_A8_B5_C3.do toàn bộ giá trị bị gán thành đối với các câu hỏi dùng ngưỡng .
Mặt khác, đối với các chỉ số tổng hợp Anderson trong Code/gen_variables.do, cấu phần câu hỏi cấu thành cùng một tên chỉ số thay đổi liên tục giữa các đợt (Anderson, 2008). Cụ thể, chỉ số chính sách hội nhập e_domain1 gộp hạng mục ở Đợt , rút xuống hạng mục ở Đợt và chỉ còn hạng mục ở Đợt ; Chỉ số niềm tin kinh tế e_domain4 gộp hạng mục ở Đợt nhưng mở rộng thành hạng mục ở Đợt và Đợt ; Chỉ số thái độ xã hội e_domain6 tăng vọt từ hạng mục ở Đợt lên hạng mục ở Đợt và Đợt . Do ma trận hiệp phương sai ngược dùng để tính trọng số swindex được tính riêng theo từng đợt trên những tập biến khác nhau, quỹ đạo suy giảm hay gia tăng hiệu ứng theo thời gian trên Figure 3.do bị trộn lẫn giữa động thái thay đổi thái độ thực chất với hiệu ứng thay đổi cấu phần câu hỏi — một vấn đề mà tác giả chỉ kiểm tra cục bộ thông qua các chỉ báo _fixed ở riêng Bảng A15.
A.3.2. Lỗi mã nguồn trong xây dựng biến niềm tin theo quốc tịch và vốn tài sản cơ sở
Rà soát từng dòng mã trong tệp Code/gen_variables.do đã phát hiện các sai sót kỹ thuật trực tiếp ảnh hưởng tới biến kết quả và biến kiểm soát:
- Lỗi ghi đè chéo biến niềm tin Congolese bởi Somali tại dòng –: Trong khối mã khởi tạo các biến
d4b_2,d4b_3vàd4b_4đo lường niềm tin về tác động của người tị nạn Somali đến trường học, y tế, giá thuê nhà và giá hàng hóa khác, vòng lặp chỉ số từ đến thực hiện chuẩn hóa nhị phân trên ngưỡng củad4b_inhưng lại thực thi lệnhreplace d4a_ighi kết quả trực tiếp vào biến của người tị nạn Congolese thay vì biến đích của người Somali. Sai sót sao chép tên biến này đồng thời gây ra hai hậu quả nghiêm trọng: thứ nhất, ba biến thành phầnd4a_2,d4a_3vàd4a_4thuộc miền của người Congolese bị ghi đè hoàn toàn bằng thái độ dành cho người Somali; Thứ hai, ba biếnd4b_2,d4b_3vàd4b_4thuộc miền của người Somali hoàn toàn không được nhị phân hóa mà vẫn giữ nguyên thang điểm thô khi đưa vào tính chỉ số tổng hợpe_domain42tại dòng –. - Lỗi gán giá trị đồng nhất cho biến kiểm kê tài sản tồn kho cơ sở tại dòng –: Khi quy đổi các khoảng giá trị ước tính hàng tồn kho cơ sở
b_b26sang biến phụ trợbd9_2_tmp2nhằm tính vốn kinh doanh cơ sởbd9_2, cả bốn mức phân loại và đều bị gán cứng cùng một hằng số UGX thay vì lấy trung điểm tăng dần theo thang khung, làm nén sai lệch phương sai vốn tồn kho tiền điều trị. - Các sai sót logic bổ sung trong phân loại và gán dữ liệu: Tại dòng , biến cộng tác kinh doanh khác bộ lạc Đợt kiểm tra điều kiện
e_c10 != .của Đợt thay vìe2_c10 != .; Tại dòng –, biến liên kết chương trình với người tị nạnd19_4thuộc Bảng áp dụng điều kiện quy nạpif wave == 4 & treatment != 4đối với người nhắc tên YARID, vô tình tạo ra khác biệt đo lường mang tính cơ chế riêng cho nhánh Thông tin thuần túy; Tại dòng –, chỉ báomisc_7gán giá trị khi phản hồie2_f13mang mã hoặc và khi mang mã , đảo chiều ý nghĩa trực giác so với nhãn hiển thị; Và tại dòng –, biến thoải mái kết bạn và hàng xóm với người tị nạn bị gán cứng bằng thông qua luật bỏ qua câu hỏi mỗi khi người trả lời chấp nhận kết hôn.
A.3.3. Hao hụt mẫu, đổi người trả lời có chọn lọc tại Kenya và bất nhất nhật ký cố vấn tại Uganda
Kết quả tái lập trực tiếp từ Data/raw_kenya.dta và Data/mentorship_meetings.dta cho phép kiểm định định lượng chi tiết tính đại diện mẫu và sai số đo lường theo đơn vị quan sát, được tổng hợp tại Bảng A1.
| Chỉ số và nhóm kiểm định | Quy mô mẫu | Hệ số nhánh Gắn nhãn | Hệ số nhánh Tiền mặt | Trị số | Trị số | ||
|---|---|---|---|---|---|---|---|
| Chỉ số ủng hộ tức thời trên toàn mẫu | |||||||
| So sánh trực tiếp Gắn nhãn với Tiền mặt tức thời | — | ||||||
| Chỉ số cận dưới sau tháng với FE tầng | — | ||||||
| Chỉ số cận dưới sau tháng với FE làng | — | ||||||
| Quyền làm việc cận dưới sau tháng | — | ||||||
| Phân nhóm giữ nguyên người trả lời sau tháng | — | ||||||
| Phân nhóm đổi người trả lời sau tháng | — | ||||||
| Xác suất đổi người trả lời nhánh Gắn nhãn | — |
Ghi chú: Mọi ước lượng trong bảng được tái lập trực tiếp từ Data/raw_kenya.dta bám sát quy trình mã hóa và hàm swindex trong Code/Tables2_A7_A8_B5_C3.do; Trong đó chỉ số và phản ánh sai số chuẩn kháng phương sai thay đổi HC1 theo từng hộ gia đình, còn và phản ánh sai số chuẩn phân cụm tại cấp làng hoặc làng nhận tiền mặt; Dấu sao theo ngưỡng , , .
Ba phát hiện thực nghiệm đáng lưu ý nổi lên từ dữ liệu thực địa Kenya và nhật ký Uganda:
- Đổi người trả lời có chọn lọc tại Kenya: Ngay trong khảo sát tức thời trên hộ, tỷ lệ trả lời bởi đúng người nhận bảng cơ sở có chỉ báo
e_rfresp1 == 1chỉ đạt , tức hộ. Quan trọng hơn, trong mẫu theo dõi một tháng sau với tỷ lệ hao hụt chung thấp và cân bằng theo nhánh ở mức khác biệt điểm phần trăm với trên hộ mục tiêu, có tới trên hộ gia đình tức đã thay đổi người trả lời sang một thành viên khác trong hộ mang chỉ báoeb_same_resp == 0. Hồi quy kiểm tra trực tiếp cho thấy xác suất bị đổi người trả lời ở nhánh Thông tin kèm Trợ cấp gắn nhãn cao hơn có ý nghĩa thống kê điểm phần trăm với so với nhánh Trợ cấp thuần túy. Hệ quả là hiệu ứng tích cực với chỉ xuất hiện ở hộ giữ nguyên người trả lời ban đầu, trong khi hoàn toàn biến mất ở hộ đổi người trả lời với và . - Bất nhất biến cân bằng và cắt gọt mẫu tiểu hạt tại Kenya: Ở Bảng B5, trên chỉ tiêu kiểm tra cân bằng thực chất sử dụng câu hỏi thu thập ngay trong khảo sát ngày thực nghiệm
e_*chứ không phải tiền điều trị độc lập; Đáng chú ý là biến hài lòng cuộc sốngresp_happybộc lộ mức chênh lệch có ý nghĩa thống kê ngay ở ngưỡng với theo thứ tự giảm dần từ ở đối chứng xuống ở trợ cấp thuần túy và ở trợ cấp gắn nhãn. Bên cạnh đó, phân tích theo phân vị tiểu hạt ở Bảng A7 và Bảng A8 dựa trên tiểu hạt thực chất chỉ có tiểu hạt chứa cả nhóm đối chứng lẫn điều trị, tiểu hạt chỉ toàn làng đối chứng và tiểu hạt là Butere cùng Matete với hộ chỉ toàn làng điều trị bị loại bỏ khỏi ước lượng. Trên tập con phân vị một đến ba, mỗi phân vị chỉ còn đến làng nhận tiền mặt, làm suy yếu lực phân tích cụm và ước lượng sự suy giảm mạnh ở nhóm tiểu hạt có mức ủng hộ cao ban đầu với và sau một tháng. - Chất lượng dữ liệu nhật ký cố vấn tại Uganda: Kiểm tra trực tiếp trên
Data/mentorship_meetings.dtagồm bản ghi trên học viên doanh nghiệp cho thấy bản ghi tương đương thiếu đồng thờimentor_id, thời lượngym_d2và hình thức gặp gỡym_d5do đây là các lần gọi điện không thành công; Đồng thời, trường ngày bắt đầuym_meeting_begin1khuyết thiếu ở trên bản ghi, chỉ lưu năm hợp lệ cho buổi năm và buổi năm . Đặc biệt, dòng thứ gắn với mã doanh nghiệp691bị ghi nhãn nhánh điều trị làtreatment = 4tức nhánh Thông tin thuần túy, bộc lộ bất nhất trong liên kết định danh giữa nhật ký cố vấn YARID với danh sách phân bổ gốc.
A.4. Các hạn chế cốt lõi trọng yếu của nghiên cứu gốc
- Lỗi mã nguồn làm sai lệch cấu trúc đo lường biến niềm tin kinh tế theo quốc tịch và vốn tồn kho cơ sở: Trong
Code/gen_variables.dotại dòng –, lỗi ghi đè nhầm vòng lặpreplace d4a_ithay chod4b_igây ra sai số đo lường hệ thống kép: toàn bộ thái độ kinh tế về người tị nạn Congolese bị thế chỗ bằng phản hồi về người Somali ở ba mụcd4a_2đếnd4a_4, trong khi các mụcd4b_2đếnd4b_4của miền Somali không hề được nhị phân hóa mà bị đưa nguyên thang điểm vào hàmswindextại dòng . Song hành với lỗi mã hóa giá trị hàng tồn khobd9_2_tmp2cố định ở mức UGX cho bốn khung khác nhau tại dòng – và chỉ báo khuyết thiếu bị đảo logic ở dòng , các sai số đo lường này tạo ra nguy cơ chệch ước lượng trực tiếp trên các bảng phụ thuộc miền , và miền . - Phân đôi nội sinh hạng mục trung tính và thay đổi cấu phần chỉ số làm mất tính bất biến đo lường theo thời gian: Cơ chế phân đôi biến nhị phân dựa trên tổng số người ủng hộ so với phản đối trong từng đợt khảo sát độc lập khiến ranh giới định nghĩa biến phụ thuộc dịch chuyển nội sinh theo phân phối từng đợt, điển hình là sự đảo ngưỡng từ sang của câu hỏi cấp đất giữa khảo sát tức thời và theo dõi tại Kenya. Kết hợp cùng việc thay đổi liên tục số lượng hạng mục đưa vào
swindexqua các đợt củae_domain1từ xuống biến,e_domain4từ lên biến vàe_domain6từ lên biến tại Uganda, các hiệu ứng không đồng nhất theo thời gian có thể bị nhiễu bởi chệch đo lường cấu trúc chứ không hoàn toàn phản ánh sự hao mòn hay củng cố thái độ thực chất. - Suy luận sai số chuẩn phi cụm và vi phạm miền mẫu trong mô hình cấu trúc phụ lục D và kiểm định đa giả thuyết: Trong
Code/AppendixD.do, phương pháp bootstrap tái lấy mẫu bằngbsample, strat(treatment strata wave)ở cấp quan sát đơn lẻ thay vì cụment_idtrên bảng dữ liệu bốn đợt làm đánh giá thấp đáng kể độ bất định của các tham số cấu trúc ; Ngoài ra, vế nhận thức chỉ đo duy nhất ởEndline 2trong khi vế ủng hộ chính sách hồi quy trên ba đợt, đồng thời việc cắt gán trong lần lặp phá vỡ điều kiện chuẩn tắc tiệm cận tại biên tham số. Song song,Code/Table A16.dotính giá trị hiệu chỉnh Westfall-Young trên phương trình OLS thiếu tập kiểm soát LASSO kép vàCode/TablesB4_B6_thru_B14.doước lượng cận chọn lọc Lee trên phần dư hồi quy OLS không phân cụm. - Thiên lệch chọn lọc người trả lời bên trong hộ và bỏ qua tương quan nội làng ở mẫu theo dõi tại Kenya: Tái lập trực tiếp từ
Data/raw_kenya.dtacho thấy tỷ lệ đổi người trả lời trong đợt theo dõi một tháng là và chênh lệch tăng thêm điểm phần trăm có ý nghĩa thống kê với ở nhánh Gắn nhãn so với Trợ cấp thuần túy. Do hiệu ứng cận dưới hoàn toàn triệt tiêu ở nhóm đổi người trả lời và chỉ tập trung nơi người trả lời gốc, kết hợp với việc không phân cụm theo làng dù tương quan nội cụm vẫn dương ở mức làm thu hẹp sai số chuẩn trêneb_rf_indexvàeb_rf_binary3, sức mạnh ngoại suy của cận dưới khử nhu cầu đối với toàn hộ gia đình nông thôn bị suy giảm rõ rệt. - Rò rỉ thông tin liên kết chương trình và biến điều tiết nội sinh hậu điều trị: Thực nghiệm Kampala tập trung hai ngành may mặc và làm đẹp có mật độ không gian cao dẫn tới hiện tượng lan tỏa nhận thức sang nhóm đối chứng và nhóm trợ cấp thuần túy được theo dõi trong
Code/in_text_stats.do, làm vi phạm một phần giả định ổn định giá trị đơn vị điều trị SUTVA và thu hẹp hiệu ứng thuần túy ước lượng của nhóm Gắn nhãn. Nghiêm trọng hơn, Bảng A12 trongCode/TablesA3_thru_A6_A9_thru_A15_C1_C2.doước lượng tính không đồng nhất bằng cách tương tác nhánh điều trị với việc hộ có sử dụng bệnh viện công hay có con học trường công tiếp nhận người tị nạn đo tạiEndline 2; Do các biến sử dụng dịch vụ công hậu điều trị có thể chịu tác động trực tiếp từ dòng tiền trợ cấp, mô hình đối mặt rủi ro chệch va chạm hậu điều trị. - Bất nhất kỹ thuật giữa chỉ số chi phí hiệu quả tất định và suy luận chọn lọc mẫu chưa chuẩn hóa: Tại
Code/TablesB4_B6_thru_B14.do, Bảng B14 tính tỷ lệ chi phí trên mỗi điểm phần trăm thay đổi thái độ bằng các con số gán cứng gồm và điểm phần trăm tại Uganda cùng và điểm phần trăm tại Kenya chia cho chi phí bình quân gộp mà bỏ qua bất định phương sai của mẫu số, tỷ lệ tuân thủ khác biệt ở Bảng B12 và độ suy giảm hiệu ứng theo thời gian, dẫn đến chệch ước lượng tỷ số chi phí hiệu quả và sai số chuẩn không phản ánh bất định chọn mẫu; Đồng thời, các trọng số nghịch đảo xác suất ở Bảng B6 đến Bảng B9 dựa trênlasso logitkhông áp dụng cắt ngưỡng trọng số cực trị hay kiểm định chồng lấn hỗ trợ chung.
A.5. Khuyến nghị nâng cấp mô hình và hướng mở rộng công bố quốc tế
A.5.1. Chuẩn hóa quy trình xây dựng biến, khử lỗi mã nguồn và cố định ngưỡng đo lường
Trước hết, gói tái lập cần được hiệu chỉnh toàn diện tại Code/gen_variables.do nhằm triệt tiêu lỗi gán biến giữa miền Somali và Congolese bằng cách sửa đích ghi vòng lặp sang d4b_i, khôi phục bảng tra đúng khung trung điểm cho tồn kho cơ sở bd9_2_tmp2, chỉnh lại logic chỉ báo khuyết thiếu missing_bd20_1, cũng như loại bỏ điều kiện phân biệt treatment != 4 trong định nghĩa liên kết tổ chức d19_4. Để bảo đảm tính so sánh theo chiều dọc giữa các đợt khảo sát tại Uganda và giữa hai đợt tại Kenya, toàn bộ chỉ số tổng hợp swindex nên được tính trên tập hạng mục cố định xuất hiện xuyên suốt mọi đợt sử dụng ma trận hiệp phương sai gộp của nhóm đối chứng thuần túy, song song với việc bổ sung kiểm định độ nhạy giữ nguyên thang điểm Likert liên tục chuẩn hóa qua ước lượng thứ bậc hoặc cố định ngưỡng nhị phân ở mức ủng hộ mạnh thay cho quy tắc phụ thuộc phân phối từng đợt.
A.5.2. Tái ước lượng double/debiased machine learning, wild cluster bootstrap và Lee bounds theo cụm
Về mặt nhận dạng kinh tế lượng, phương trình ước lượng tuyến tính nên được nâng cấp lên khung Học máy Khử chệch Kép của Chernozhukov và cộng sự với phép chia mẫu chéo -fold nhằm khắc phục nguy cơ quá khớp trong bước chọn lọc biến kiểm soát đa chiều và cho phép tích hợp tương tác phi tuyến giữa đặc điểm cơ sở với trạng thái khuyết thiếu (Chernozhukov et al., 2018). Mô hình đề xuất cho ước lượng hiệu ứng điều trị trực giao hóa như sau:
Trong đó:
- : ước lượng khử chệch kép của hiệu ứng nhân quả trung bình cho nhánh can thiệp ;
- : chỉ số nhánh điều trị mục tiêu từ đến ;
- : tổng số quan sát hợp lệ trên toàn bộ bảng dữ liệu thực nghiệm;
- : chỉ số định danh đơn vị doanh nghiệp hoặc hộ gia đình;
- : chỉ số đợt khảo sát hậu điều trị;
- : phần dư chỉ báo nhánh sau khi loại trừ xu hướng điều trị dự báo ngoài mẫu trên các khối ngoài cụm;
- : biến kết quả thái độ hoặc kinh tế đo lường tại đợt ;
- : hàm dự báo kỳ vọng có điều kiện của kết quả huấn luyện trên các khối không chứa cụm ;
- : chỉ số cụm chéo mẫu chứa đơn vị quan sát ;
- : biến kết quả đo lường ở kỳ cơ sở;
- : vectơ biến kiểm soát thiết kế phân tầng và thời điểm khảo sát;
- : tập đặc trưng nhân khẩu học và kinh doanh tiền điều trị.
Đồng thời, mọi kiểm định suy luận đa giả thuyết theo Westfall-Young tại Code/Table A16.do phải bao gồm đúng tập biến kiểm soát đã chọn từ LASSO kép hoặc mô hình DML nêu trên; Đối với mẫu Kenya, mọi hồi quy ở đợt theo dõi một tháng và phân tích phân vị tiểu hạt cần áp dụng đồng thời hiệu ứng cố định làng cho so sánh nội làng, phân cụm sai số chuẩn ở cấp village_id, và tái lấy mẫu Wild Cluster Bootstrap cho các nhóm tiểu hạt chỉ có – làng nhận điều trị (Cameron et al., 2008; Roodman et al., 2019). Đối với kiểm định độ nhạy chọn lọc mẫu và đổi người trả lời tại Kenya, cần xây dựng cận chọn lọc Lee mở rộng kết hợp bootstrap cụm ở cấp cá nhân tại Uganda và cấp làng tại Kenya nhằm tính khoảng tin cậy nhất quán cho cả hiệu ứng thu hẹp theo tỷ lệ sống sót lẫn sự dịch chuyển cơ cấu người trả lời trong hộ gia đình.
A.5.3. Hoàn thiện mô hình cấu trúc có ràng buộc bất bình đẳng và phân tích tổng quát cho nghiên cứu tái lập
Cuối cùng, mô hình cấu trúc tại Code/AppendixD.do cần được ước lượng lại trên cùng một tập mẫu nhất quán tại Đợt nơi biến cảm nhận bất mãn viện trợ e2_aid7 được quan sát, hoặc mô hình hóa biến ẩn bằng phương pháp gộp hai mẫu có trọng số ngược, kết hợp giải pháp tái chọn mẫu cluster bootstrap ở cấp doanh nghiệp ent_id và suy luận khoảng tin cậy chỉnh biên cho tham số không âm thay cho phép cắt gán cứng giá trị . Một hướng mở rộng có giá trị xuất bản cao là tích hợp dữ liệu không gian kinh doanh Kampala để ước lượng trực tiếp hiệu ứng lan tỏa gián tiếp theo bán kính lân cận giữa doanh nghiệp được gắn nhãn và doanh nghiệp đối chứng, qua đó xác định ngưỡng mật độ truyền dẫn thông tin tối ưu giúp chính sách viện trợ kết hợp hỗ trợ cộng đồng địa phương đạt hiệu quả chính trị bền vững nhất.
Tài liệu tham khảo
- Alesina, A., Miano, A., & Stantcheva, S. (2023). Immigration and redistribution. Review of Economic Studies, 90, 1–39. https://doi.org/10.1093/restud/rdac011 ↩
- Anderson, M. L. (2008). Multiple inference and gender differences in the effects of early intervention: A reevaluation of the Abecedarian, Perry Preschool, and Early Training Projects. Journal of the American Statistical Association, 103, 1481–1495. https://doi.org/10.1198/016214508000000841 ↩
- Andrews, D. W. K. (2000). Inconsistency of the bootstrap when a parameter is on the boundary of the parameter space. Econometrica, 68, 399–405. https://doi.org/10.1111/1468-0262.00114 ↩
- Baseler, T., Ginn, T., Hakiza, R., Ogude-Chambert, H., & Woldemikael, O. (2025). Can redistribution change policy views? Aid and attitudes toward refugees. Journal of Political Economy, 133, 2874–2917. https://doi.org/10.1086/736209 ↩
- Belloni, A., Chernozhukov, V., & Hansen, C. (2014). Inference on treatment effects after selection among high-dimensional controls. Review of Economic Studies, 81, 608–650. https://doi.org/10.1093/restud/rdt044 ↩
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2008). Bootstrap-based improvements for inference with clustered errors. Review of Economics and Statistics, 90, 414–427. https://doi.org/10.1162/rest.90.3.414 ↩
- Chernozhukov, V., Chetverikov, D., Demirer, M., Duflo, E., Hansen, C., Newey, W., & Robins, J. (2018). Double/debiased machine learning for treatment and structural parameters. The Econometrics Journal, 21, C1–C68. https://doi.org/10.1111/ectj.12097 ↩
- de Quidt, J., Haushofer, J., & Roth, C. (2018). Measuring and bounding experimenter demand. American Economic Review, 108, 3266–3302. https://doi.org/10.1257/aer.20171330 ↩
- Dustmann, C., Vasiljeva, K., & Piil Damm, A. (2019). Refugee migration and electoral outcomes. Review of Economic Studies, 86, 2035–2091. https://doi.org/10.1093/restud/rdy047 ↩
- Hangartner, D., Dinas, E., Marbach, M., Matakos, K., & Xefteris, D. (2019). Does exposure to the refugee crisis make natives more hostile? American Political Science Review, 113, 442–455. https://doi.org/10.1017/S0003055418000813 ↩
- Lee, D. S. (2009). Training, wages, and sample selection: Estimating sharp bounds on treatment effects. Review of Economic Studies, 76, 1071–1102. https://doi.org/10.1111/j.1467-937X.2009.00536.x ↩
- Oster, E. (2019). Unobservable selection and coefficient stability: Theory and evidence. Journal of Business & Economic Statistics, 37, 187–204. https://doi.org/10.1080/07350015.2016.1227711 ↩
- Roodman, D., Nielsen, M. Ø., MacKinnon, J. G., & Webb, M. D. (2019). Fast and wild: Bootstrap inference in Stata using boottest. The Stata Journal, 19, 4–60. https://doi.org/10.1177/1536867X19830877 ↩
- Schwab, B., Janzen, S., Magnan, N. P., & Thompson, W. N. (2020). Constructing a summary index using the standardized inverse-covariance weighted average of indicators. The Stata Journal, 20, 952–964. https://doi.org/10.1177/1536867X20976325 ↩
- Westfall, P. H., & Young, S. S. (1989). P value adjustments for multiple tests in multivariate binomial models. Journal of the American Statistical Association, 84, 780–786. https://doi.org/10.1080/01621459.1989.10478837 ↩
kenya_refugee_aid_experiment_2025hh_idvillage_idref_stratumcounty_namesubcounty_namerf_treatmentref_inforef_cashonlyref_controlref_anycashe_rfresp1merge_reffollowupMở khóa dữ liệu & mã lệnh tái lập
Sau khi theo dõi phần phân tích định lượng và bình duyệt học thuật phía trên, mời bạn đăng nhập nếu đã có gói thành viên hoặc tham gia cộng đồng nghiên cứu EcoLab để trực tiếp kiểm chứng từng hệ số ước lượng trên máy cá nhân.
Khớp chính xác tên biến, đặc tả sai số chuẩn vững và ma trận kiểm định chẩn đoán của bài nghiên cứu.
Sẵn sàng nạp trực tiếp vào môi trường thống kê cá nhân để đối chiếu độc lập từng bảng kết quả.
Đóng gói đồng bộ bản thảo chuẩn công bố tạp chí DOCX & PDF, tệp dữ liệu CSV, ba kịch bản ước lượng R · Stata · Python và hướng dẫn thực thi.
Mỗi liên kết tải xuống được cấp chữ ký bảo mật riêng cho tài khoản thành viên và tự động làm mới mượt mà ngay trên trang đọc.