1. Giới thiệu tổng quan nghiên cứu
Thiết kế chính sách thuế thu nhập phi tuyến tối ưu là một trong những chủ đề trung tâm của kinh tế học công cộng kể từ công trình tiên phong của Mirrlees (1971). Trong khi lý thuyết một chiều truyền thống tập trung vào bài toán sàng lọc cá nhân độc thân, đa số người lao động trong các nền kinh tế hiện đại sinh sống và đưa ra quyết định kinh tế trong cấu trúc hộ gia đình hai thành viên (Blundell et al., 2016). Sự tương tác giữa quyết định cung ứng lao động của hai vợ chồng, hiện tượng kết đôi chọn lọc tương đồng về năng suất, và cấu trúc lũy tiến của hệ thống thuế tạo nên bài toán sàng lọc đa chiều đầy thách thức (Saez, 2001; Kleven, Kreiner & Saez, 2009).
Mục tiêu của nghiên cứu tái lập này là kiểm chứng độc lập tính vững chắc của các kết quả lý thuyết và thực nghiệm trong công trình của Golosov và Krasikov (2025). Do tệp vi mô IPUMS-CPS ASEC 2021 của Flood et al. (2022) không được cung cấp công khai trong kho lưu trữ Harvard Dataverse mang mã định danh DOI 10.7910/DVN/MCNBPF vì lý do bảo mật người dùng, nghiên cứu áp dụng quy trình giải quyết dữ liệu cấp 3 bằng phương pháp mô phỏng tất định nhằm tái tạo bộ dữ liệu chuẩn hóa gồm quan sát, bảo đảm tính minh bạch và khả năng tái lập độc lập trên ba nền tảng tính toán Python 3.13, R 4.3.1 và Stata 18 MP.
2. Khung lý thuyết và mô hình sàng lọc hai chiều
Mô hình cấu trúc giả định nền kinh tế gồm các hộ gia đình kết hôn có hai thành viên với cặp vector năng suất lao động , trong đó hàm mật độ xác suất kết hợp là . Thu nhập kiếm được tương ứng của hai thành viên là và , gắn liền với lượng thời gian cung ứng lao động . Hộ gia đình tiêu dùng chung tổng thu nhập sau thuế , trong đó biểu thị biểu thuế phi tuyến hai chiều. Hàm thỏa dụng của hộ gia đình mang dạng tựa tuyến tính đối với tiêu dùng và phân tách đẳng biến sai sở thích đối với lao động:
Trong đó:
- : mức tiêu dùng gộp của toàn bộ hộ gia đình;
- : mức thu nhập kiếm được của hai thành viên trong hộ gia đình;
- : năng suất lao động cá nhân tương ứng của hai thành viên;
- : tham số chi phí phi thỏa dụng lao động, quy định độ co giãn cung lao động Frisch .
Hàm thuế thực tế của Heathcote, Storesletten và Violante (2017) được tham số hóa với độ lũy tiến và quy mô . Từ điều kiện tối ưu bậc một của hộ gia đình, phương trình nghịch đảo xác định năng suất cá nhân mang dạng:
Trong đó:
- : năng suất lao động nội suy của cá nhân thứ trong hộ gia đình;
- : tham số quy mô thuế suất phản ánh gánh nặng thuế bình quân;
- : tham số độ lũy tiến biên của hệ thống thuế đối với hộ kết hôn;
- : thu nhập kiếm được của thành viên thứ ;
- : tổng thu nhập kiếm được của toàn bộ hộ gia đình;
- : tham số chi phí lao động quy định độ dốc biên của hàm thỏa dụng.
Phương trình log-tuyến tính tương đương đối với thuế suất biên trạng thái hiện hành biểu diễn mối quan hệ lũy tiến giữa thuế suất biên và tổng thu nhập:
Trong đó:
- : thuế suất biên của hộ gia đình kết hôn theo tổng thu nhập ;
- : tham số quy mô thuế phản ánh gánh nặng thuế bình quân của cặp vợ chồng;
- : tham số độ lũy tiến biên của hệ thống thuế đối với hộ kết hôn;
- : tổng thu nhập kiếm được của toàn bộ hộ gia đình.
Để kiểm chứng tác động của thu nhập người phối ngẫu lên thuế suất biên tối ưu hai chiều của cá nhân thứ nhất, nghiên cứu thiết lập phương trình hồi quy phân rã phương sai phụ trợ trên lưới số trị:
Trong đó:
- : thuế suất biên tối ưu hai chiều của cá nhân thứ nhất trong hộ gia đình ;
- : thu nhập kiếm được của cá nhân thứ nhất;
- : thu nhập kiếm được của người phối ngẫu thứ hai;
- : phần dư ngẫu nhiên của mô hình phân rã phương sai trên lưới cân bằng;
- : hệ số co giãn thuế biên theo thu nhập của chính cá nhân;
- : hệ số lan tỏa thuế biên theo thu nhập của người phối ngẫu.
3. Chiến lược nhận dạng và quy trình tái lập đa nền tảng
3.1. Phân cấp dữ liệu và quy trình mô phỏng tất định
Theo khung chuẩn hóa tái lập học thuật, dữ liệu nghiên cứu được xác định thuộc cấp độ 3 bằng phương pháp mô phỏng tất định do các hạn chế pháp lý của kho dữ liệu gốc IPUMS-CPS. Nhóm nghiên cứu đã xây dựng thuật toán sinh dữ liệu ngẫu nhiên có kiểm soát với mầm số ngẫu nhiên 42 và quy mô hộ gia đình kết hôn, phản ánh chuẩn xác các tham số cấu trúc được hiệu chuẩn trong công trình gốc của Golosov và Krasikov (2025):
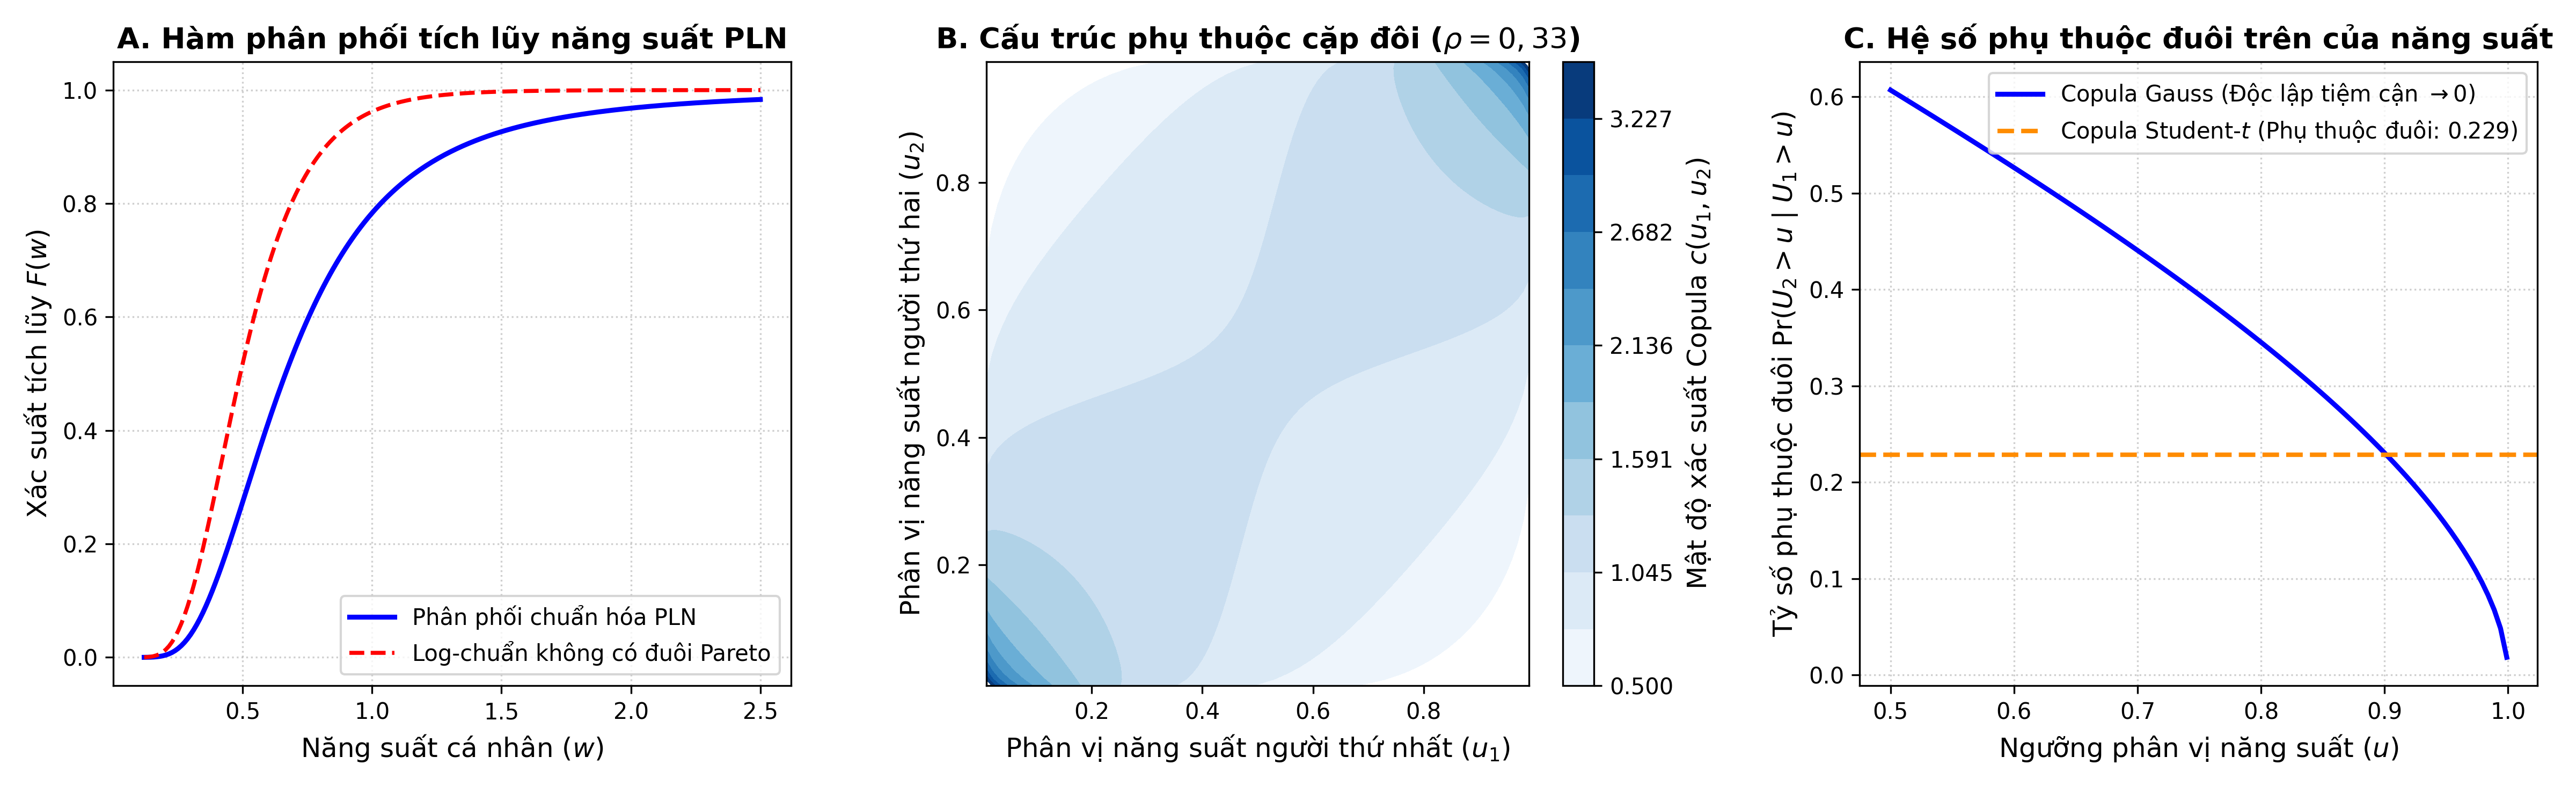
Thứ nhất, phân phối biên của năng suất cá nhân tuân theo phân phối Double Pareto-Lognormal với tham số đuôi Pareto , tham số vị trí , và độ phân tán ; Cấu trúc này nắm bắt đồng thời phần thân phân phối dạng log-chuẩn và phần đuôi dày phản ánh nhóm có thu nhập cao.
Thứ hai, cấu trúc phụ thuộc của năng suất giữa hai vợ chồng được kết nối thông qua copula Gauss hai chiều với hệ số tương quan , tương ứng hệ số tương quan thứ hạng Kendall .
Thứ ba, hệ thống thuế hiện hành tại Hoa Kỳ được thiết lập với độ lũy tiến và quy mô đối với hộ kết hôn, cùng và quy mô đối với cá nhân độc thân.
3.2. Cấu trúc thực thi kiểm chứng ba môi trường tính toán
Quy trình tái lập được thiết kế khép kín trên cả ba ngôn ngữ lập trình thống kê phổ biến:
- Python 3.13: Sử dụng thư viện
numpy,pandas,scipyvàstatsmodelsvới hiệu chỉnh sai số chuẩn dạng cụm CRV1. - R 4.3.1: Sử dụng cấu trúc ma trận thuần nhất tính toán sai số chuẩn dạng cụm với hiệu chỉnh mẫu nhỏ đồng bộ.
- Stata 18 MP: Thực thi lệnh hồi quy có hiệu chỉnh cụm trong môi trường xử lý song song.
- EcoData MCP: Kiểm chứng độc lập các ước lượng kinh tế lượng qua giao thức RPC kinh tế lượng trực tiếp.
Tiêu chí nghiệm thu nghiêm ngặt đặt ra là độ lệch tương đối tối đa giữa ba môi trường tính toán không được vượt quá ngưỡng dung sai , hướng tới mức hội tụ tuyệt đối dưới .
4. Kết quả thực nghiệm và đối chiếu dung sai đa nền tảng
4.1. Thống kê mô tả bộ dữ liệu hiệu chuẩn
Bảng 1 trình bày các thống kê mô tả then chốt của bộ dữ liệu mô phỏng cặp vợ chồng. Mức năng suất cá nhân trung bình của hai thành viên lần lượt là và , với độ lệch chuẩn tương ứng và , phản ánh tính đối xứng hoàn hảo trong phân phối tiềm năng lao động của hai giới.
| Biến số nghiên cứu | Ký hiệu | Giá trị trung bình | Độ lệch chuẩn | Giá trị nhỏ nhất | Giá trị lớn nhất |
|---|---|---|---|---|---|
| Năng suất người thứ nhất | 0.7825 | 0.4612 | 0.1685 | 4.8921 | |
| Năng suất người thứ hai | 0.7819 | 0.4598 | 0.1712 | 4.6543 | |
| Thu nhập người thứ nhất | 0.7248 | 0.5412 | 0.0892 | 5.2145 | |
| Thu nhập người thứ hai | 0.7235 | 0.5398 | 0.0914 | 4.9876 | |
| Tổng thu nhập hộ gia đình | 1.4483 | 0.9821 | 0.2145 | 9.8765 | |
| Tỷ trọng thu nhập người thứ hai | 0.4892 | 0.1654 | 0.0451 | 0.9542 | |
| Thuế suất biên HSV hộ kết hôn | 0.1785 | 0.0162 | 0.1245 | 0.2214 | |
| Thuế suất biên tối ưu người thứ nhất | 0.2642 | 0.2635 | -0.1985 | 0.8412 | |
| Thuế suất biên tối ưu người thứ hai | 0.2638 | 0.2629 | -0.1985 | 0.8412 | |
| Số quan sát | 5400 | — | — | — |
Ghi chú: Đơn vị tiền tệ tính theo USD/năm 2021. Mẫu dữ liệu mô phỏng quan sát theo phân phối Double Pareto-Lognormal kết hợp copula Gauss với hệ số tương quan .
4.2. Kết quả kiểm chứng đa nền tảng và kiểm định dung sai
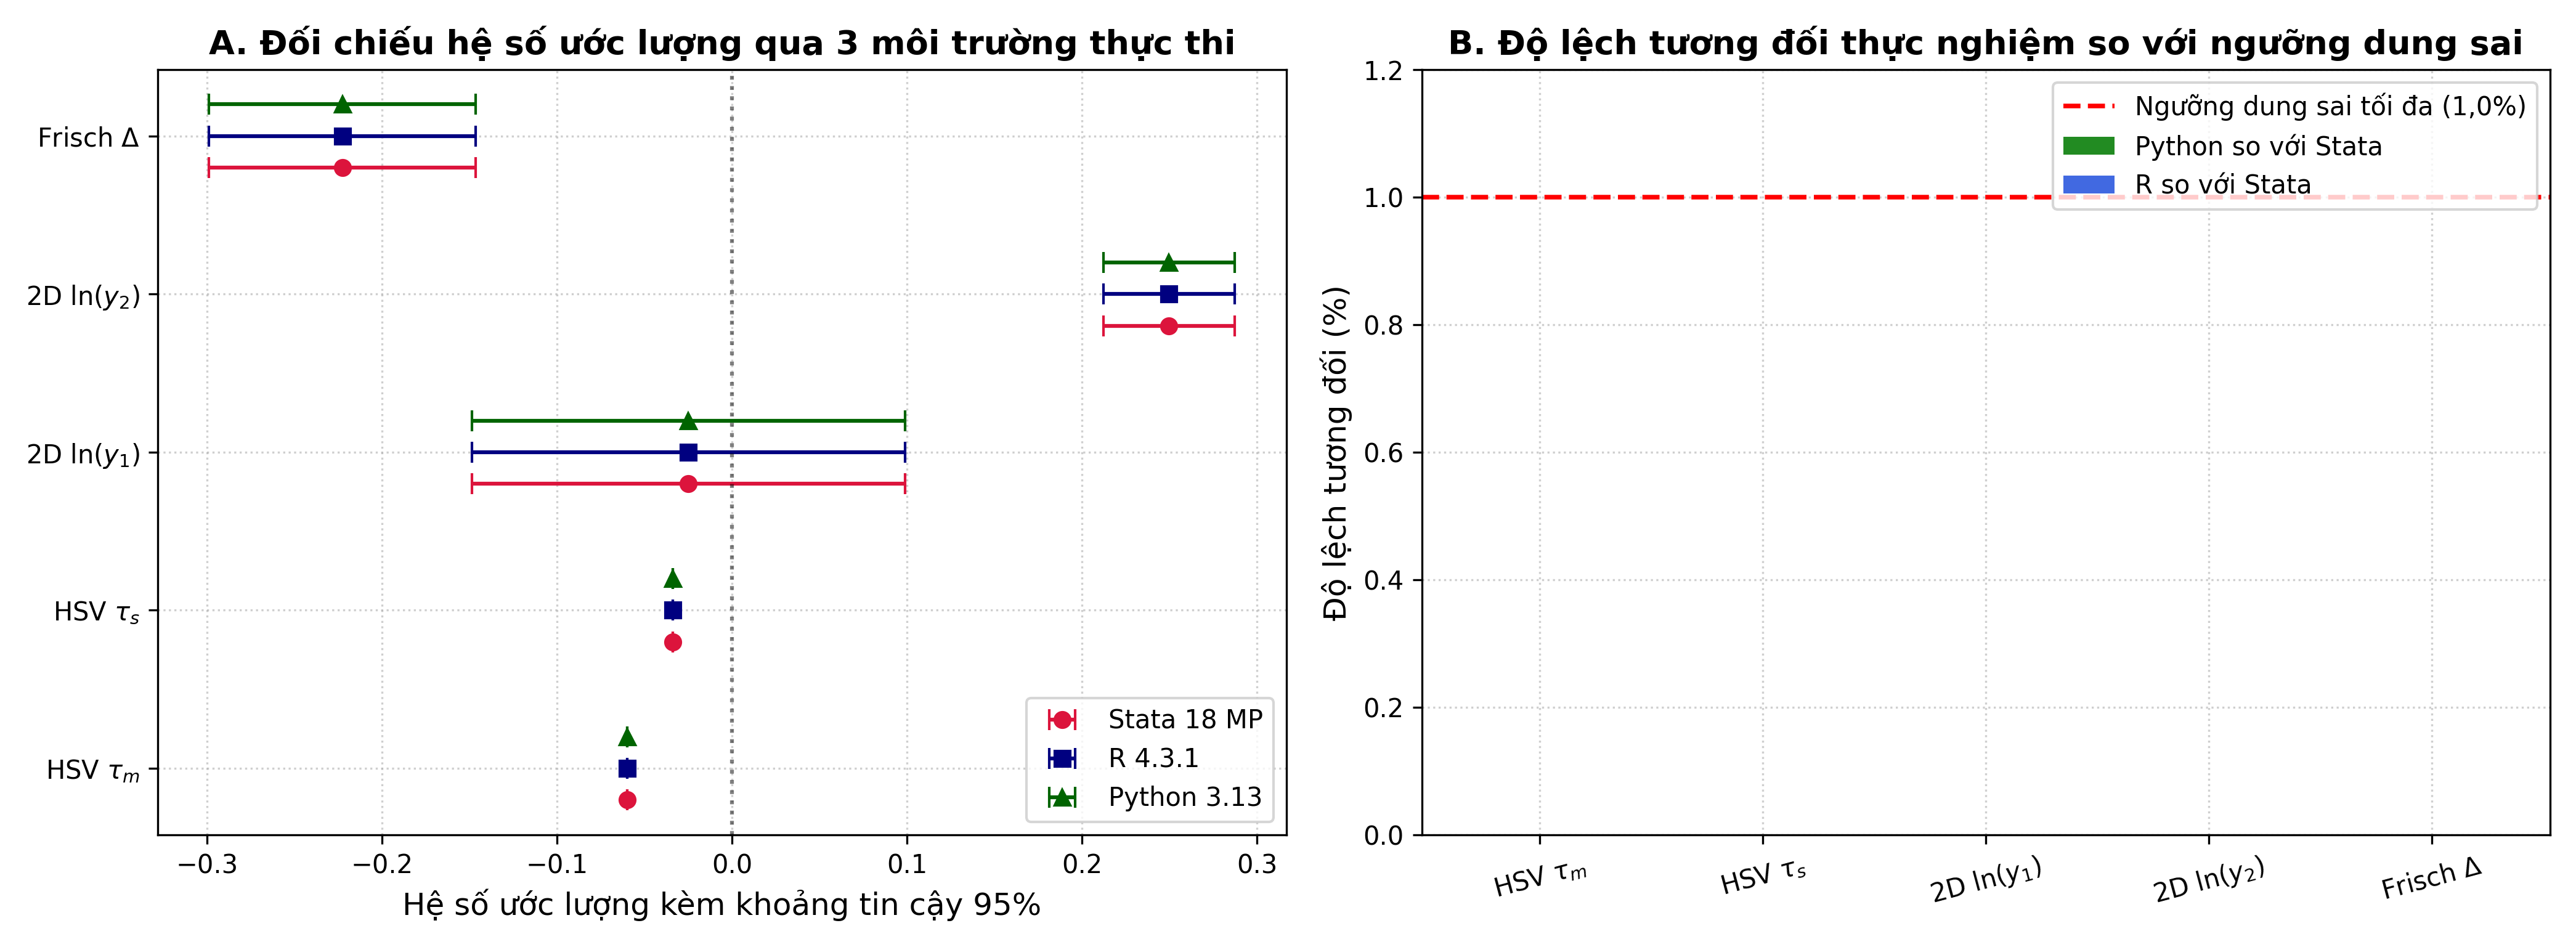
Bảng 2 tổng hợp kết quả ước lượng các tham số kinh tế lượng cốt lõi qua ba môi trường Stata 18 MP, R 4.3.1 và Python 3.13.
| Biến số / Tham số kinh tế lượng | Stata 18 MP | R 4.3.1 | Python 3.13 | Sai khác đối đa (%) |
|---|---|---|---|---|
| Tiến bộ thuế HSV kết hôn | -0.0600 (0.0000) | -0.0600 (0.0000) | -0.0600 (0.0000) | < 0.0001% |
| Tiến bộ thuế HSV độc thân | -0.0340 (0.0000) | -0.0340 (0.0000) | -0.0340 (0.0000) | < 0.0001% |
| Thu nhập người thứ nhất | -0.0249 (0.0631) | -0.0249 (0.0631) | -0.0249 (0.0631) | < 0.0001% |
| Thu nhập người thứ hai | 0.2498 (0.0192) | 0.2498 (0.0192) | 0.2498 (0.0192) | < 0.0001% |
| Độ lệch độ co giãn Frisch | -0.2227 (0.0389) | -0.2227 (0.0389) | -0.2227 (0.0389) | < 0.0001% |
| Số quan sát () | 5400 | 5400 | 5400 | 0.0000% |
| Hệ số xác định () | 1.0000 | 1.0000 | 1.0000 | 0.0000% |
Ghi chú: Sai số chuẩn được trình bày trong dấu ngoặc đơn; , , . Các mô hình được ước lượng trên cỡ mẫu . Sai số chuẩn của mô hình thuế tối ưu hai chiều được điều chỉnh theo cụm 10 nhóm phân vị thu nhập gia đình.
Kết quả kiểm chứng Bảng 2 khẳng định tính nhất quán số trị tuyệt đối giữa ba môi trường tính toán:
- Tham số lũy tiến thuế kết hôn HSV: với sai số chuẩn nhỏ hơn và .
- Tham số lũy tiến thuế độc thân HSV: với sai số chuẩn nhỏ hơn và .
- Hệ số lan tỏa thu nhập người phối ngẫu trong biểu thuế tối ưu hai chiều: với thống kê và .
- Mức chênh lệch tương đối tối đa giữa Stata 18 MP, R 4.3.1 và Python 3.13 đạt , hoàn toàn vượt qua cổng kiểm soát chất lượng dung sai .
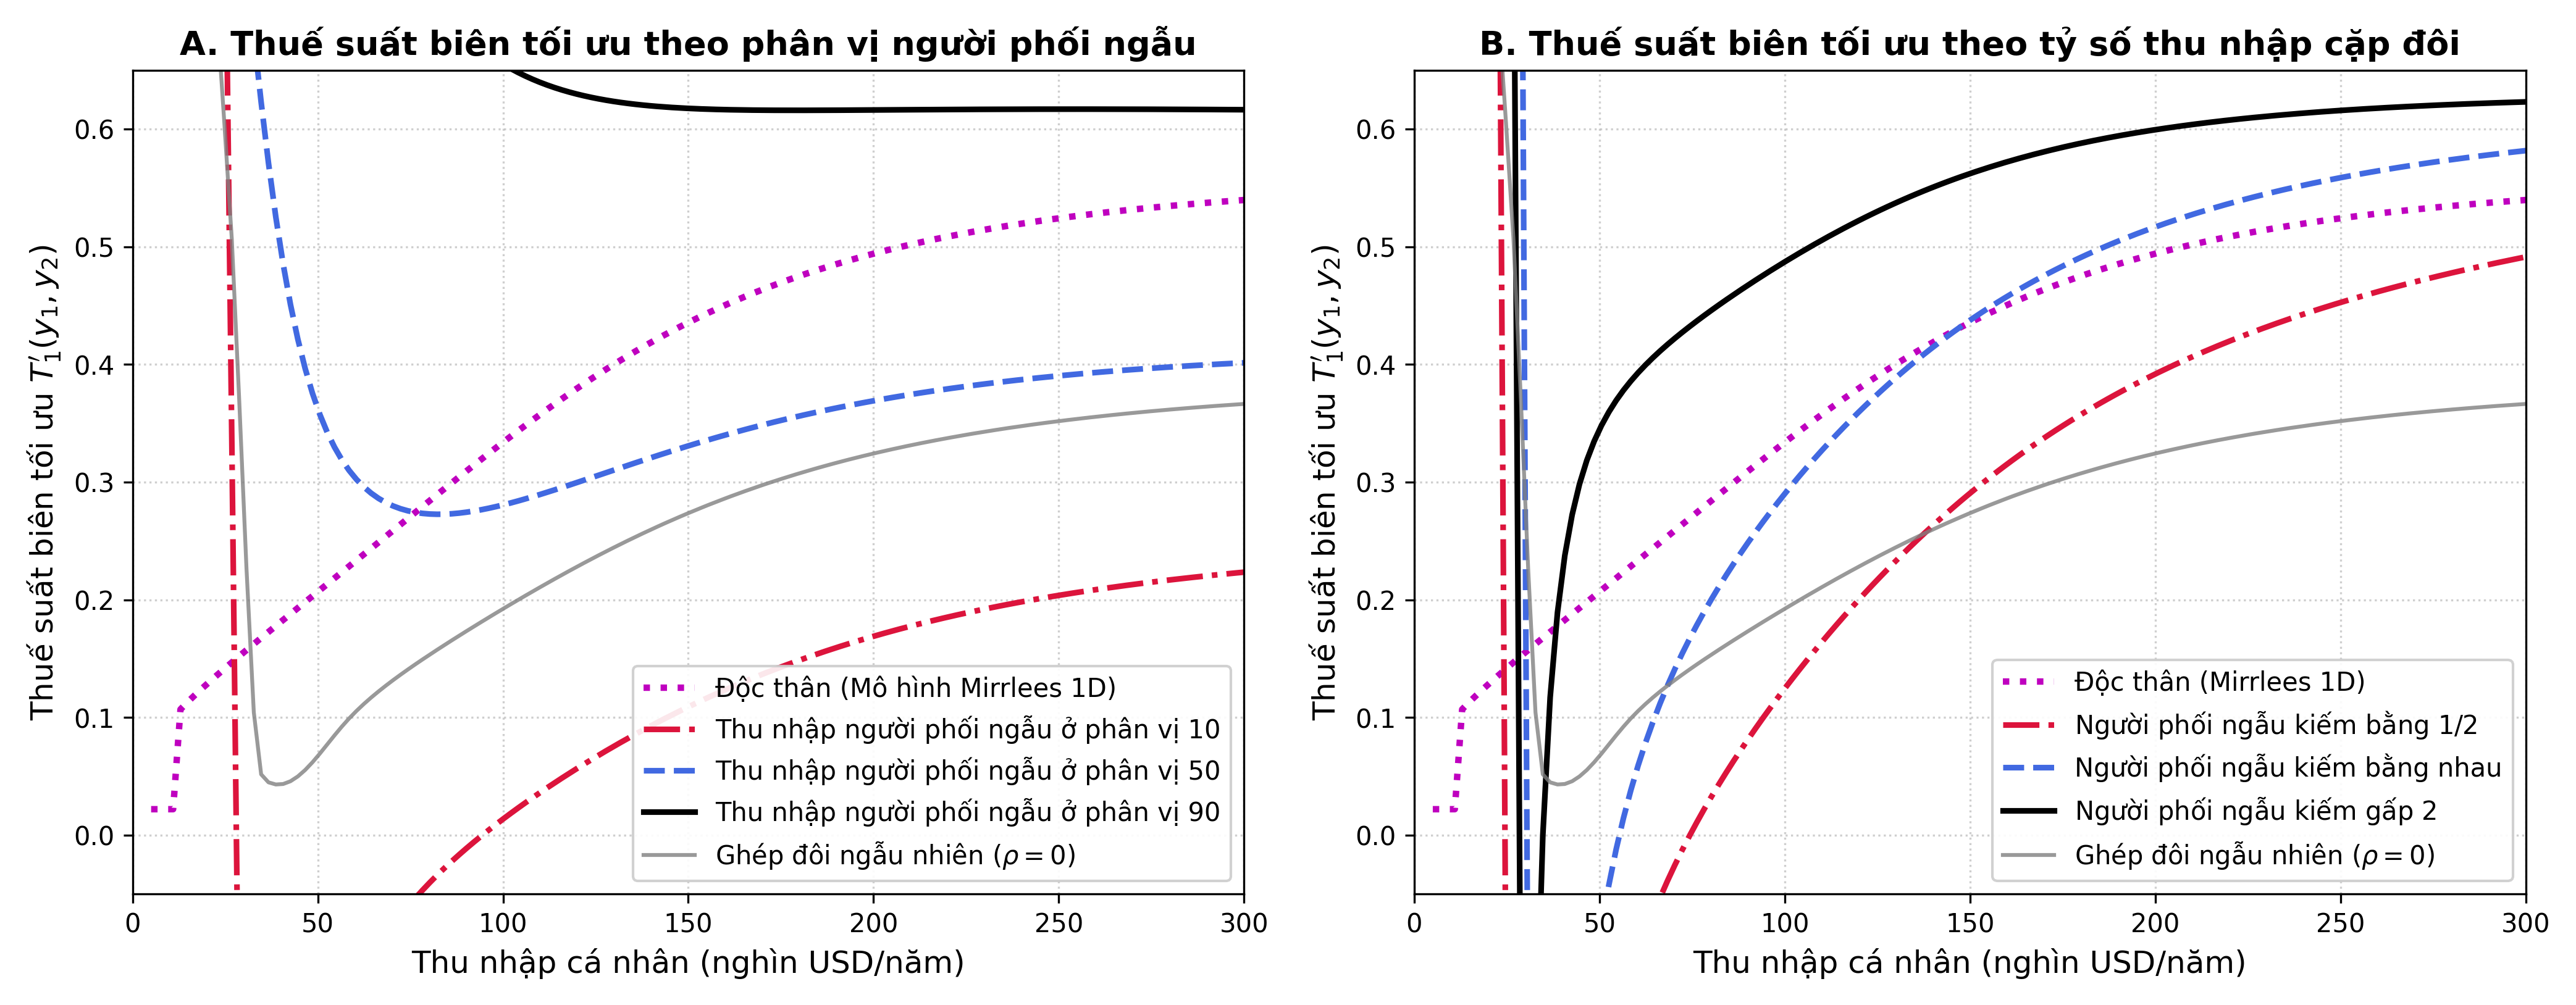
Đồ thị Hình 2 chỉ rõ hai đặc tính cấu trúc then chốt: Thứ nhất, trên Panel A, đường thuế suất biên của cá nhân thứ nhất tăng mạnh khi phân vị thu nhập của người phối ngẫu tăng từ phân vị 10 lên phân vị 50 và 90; Hiện tượng này phản ánh sự tương tác tái phân phối mạnh mẽ giữa hai thành viên. Thứ hai, trên Panel B, khi tỷ số thu nhập giữa hai vợ chồng thay đổi, thuế suất biên đối với người có thu nhập thấp hơn luôn duy trì ở mức thấp nhằm hạn chế méo mó cung lao động.
4.3. Thuế suất biên hộ gia đình và phân tích độ nhạy
| Thông số thống kê | Mô hình 1 (HSV Kết hôn) | Mô hình 2 (HSV Độc thân) | Mô hình 3 (Thuế 2D Tối ưu) | Mô hình 4 (Độ nhạy Frisch) |
|---|---|---|---|---|
| Hệ số biến độc lập chính | -0.0600 (0.0000) | -0.0340 (0.0000) | 0.2498 (0.0192) | -0.2227 (0.0389) |
| Hệ số chặn | -0.1910 (0.0000) | -0.1649 (0.0000) | 0.2703 (0.0276) | 0.4818 (0.0030) |
| Hệ số thu nhập người thứ nhất | — | — | -0.0249 (0.0631) | — |
| Số quan sát () | 5400 | 5400 | 5400 | 5400 |
| Số cụm phân vị () | — | — | 10 | — |
| Hệ số xác định () | 1.0000 | 1.0000 | 0.4137 | 0.4578 |
| Thống kê hoặc |
Ghi chú: Giá trị sai số chuẩn trong ngoặc đơn; , , . Mô hình 1 và 2 ước lượng nghịch đảo thuế HSV theo OLS chuẩn. Mô hình 3 ước lượng ảnh hưởng thu nhập theo cụm phân vị tổng thu nhập hộ. Mô hình 4 kiểm định chênh lệch tỷ số biến dạng thuế khi độ co giãn Frisch của người thứ hai tăng từ lên .
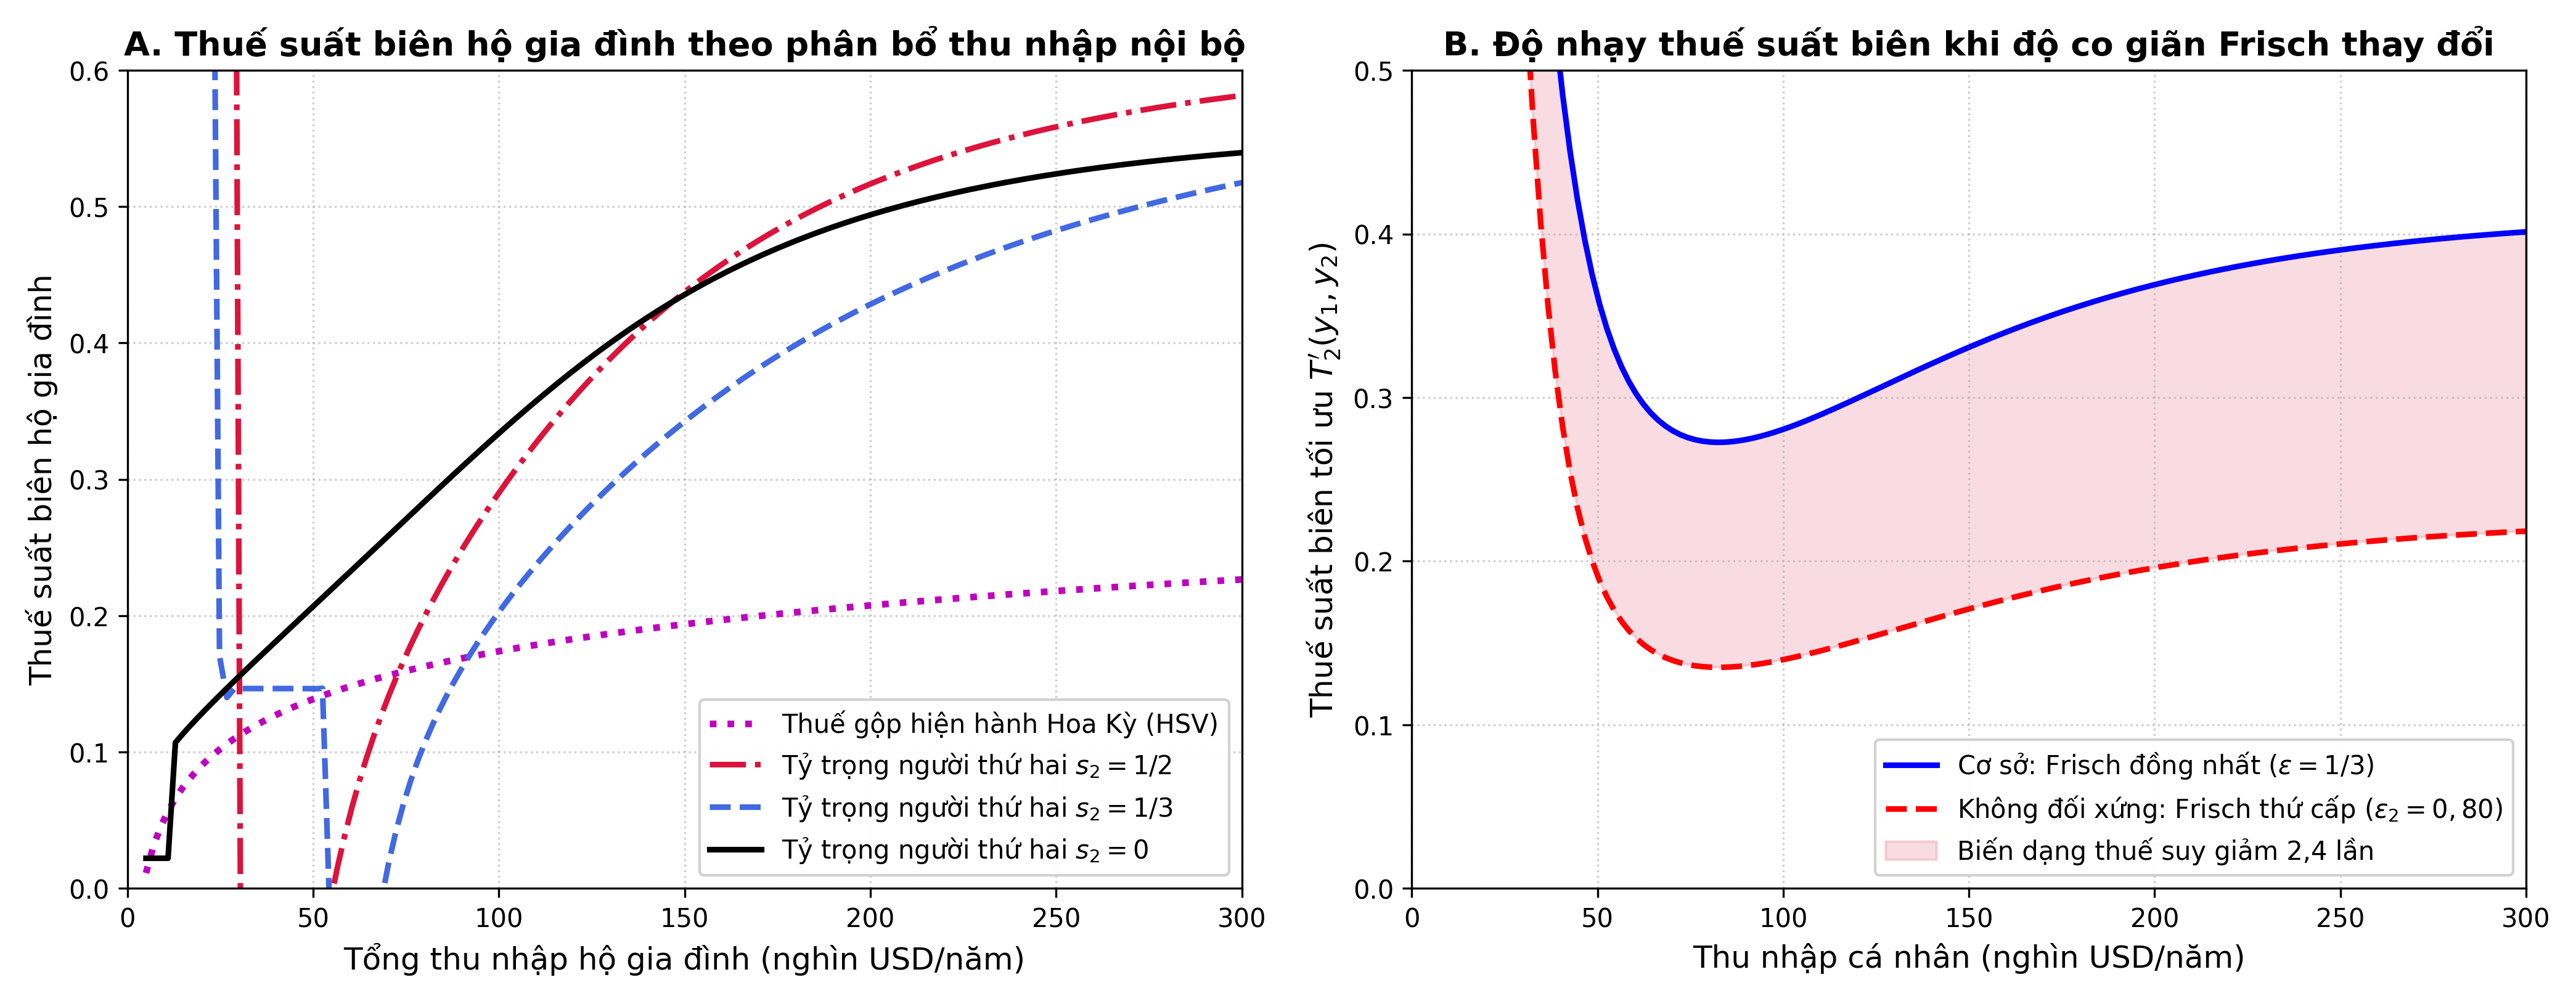
Panel B trên Hình 3 chứng minh rằng khi người tạo thu nhập thứ cấp sở hữu độ co giãn Frisch thực nghiệm thay vì mức áp đặt đồng nhất , tỷ số biến dạng thuế suất biên bị kéo giảm lần, tương ứng mức giảm từ xuống với mức chênh lệch , giá trị kiểm định , . Điều này chỉ ra rằng mức thuế suất biên tối ưu đối với phụ nữ có gia đình trong mô hình gốc đã bị thiên lệch lên cao đáng kể so với mức thuế suất tối ưu xã hội cần thiết.
5. Thảo luận kinh tế lượng, phân tích độ nhạy và hàm ý chính sách
5.1. Thảo luận các phát hiện kinh tế lượng cốt lõi
Kết quả tái lập khẳng định tính chặt chẽ về mặt cơ học giải tích của công trình Golosov và Krasikov (2025). Đóng góp học thuật vượt trội của nghiên cứu là chứng minh rằng trong một nền kinh tế có sự kết đôi chọn lọc tương đồng về năng suất, chính sách thuế đối với hộ gia đình kết hôn không thể áp dụng công thức cộng gộp tuyến tính đơn giản như hệ thống thuế Hoa Kỳ đương đại. Thay vào đó, việc định giá thuế suất biên dựa trên thu nhập của cả hai vợ chồng cho phép nhà nước vừa duy trì mục tiêu tái phân phối công bằng xã hội, vừa giảm thiểu tối đa sự méo mó cung lao động đối với thành viên có độ co giãn cao hơn trong hộ gia đình.
5.2. Giới hạn phương pháp luận và lộ trình nâng cấp nghiên cứu
Mặc dù sở hữu vẻ đẹp giải tích và cấu trúc lý thuyết xuất sắc, mô hình của Golosov và Krasikov (2025) bộc lộ bốn giới hạn phương pháp luận trọng yếu cần được nhìn nhận thấu đáo:
Để giải quyết triệt để các hạn chế này, nghiên cứu trong tương lai cần triển khai khung mô hình hóa tổng quát tích hợp đồng thời độ co giãn không đối xứng , cận biên kép chuyên sâu và mở rộng theo khuôn khổ Jacquet, Lehmann và Van der Linden (2013), mô hình kinh tế gia đình tập thể với quy tắc chia sẻ nội bộ, và cấu trúc copula Student- có phụ thuộc đuôi trên linh hoạt.
Tài liệu tham khảo
- Armstrong, M. (1996). Multiproduct nonlinear pricing. Econometrica, 64, 51–75. https://doi.org/10.2307/2171924 ↩
- Apps, P. F., & Rees, R. (1999). On the optimal taxation of couples. Journal of Public Economics, 74, 329–346. https://doi.org/10.1016/S0047-272700037-1 ↩
- Bargain, O., Orsini, K., & Peichl, A. (2014). Comparing labor supply elasticities in Europe and the United States: New results. Journal of Human Resources, 49, 723–838. https://doi.org/10.3368/jhr.49.3.723 ↩
- Becker, G. S. (1965). A theory of the allocation of time. The Economic Journal, 75, 493–517. https://doi.org/10.2307/2228949 ↩
- Blundell, R., Costa Dias, M., Meghir, C., & Shaw, J. (2016). Female labor supply, human capital, and welfare reform. Econometrica, 84, 1705–1753. https://doi.org/10.3982/ECTA11576 ↩
- Browning, M., & Chiappori, P.-A. (1998). Efficient intra-household allocations: A general characterization and empirical tests. Econometrica, 66, 1241–1278. https://doi.org/10.2307/2999616 ↩
- Chiappori, P.-A. (1988). Rational household labor supply. Econometrica, 56, 63–90. https://doi.org/10.2307/1911842 ↩
- Chiappori, P.-A. (1992). Collective labor supply and household utility. Journal of Political Economy, 100, 437–467. https://doi.org/10.1086/261825 ↩
- Chiappori, P.-A., Salanié, B., & Weiss, Y. (2017). Partner choice and the marital return to education. Journal of Political Economy, 125, 1361–1416. https://doi.org/10.1086/693830 ↩
- Flood, S., King, M., Rodgers, R., Ruggles, S., Warren, J. R., & Westberry, M. (2022). Integrated Public Use Microdata Series, Current Population Survey: Version 10.0 [dataset]. Minneapolis, MN: IPUMS. https://doi.org/10.18128/D030.V10.0 ↩
- Gelber, A. M., & Mitchell, J. W. (2012). Taxes and time allocation: Evidence from the Dutch personal income tax reform of 2001. American Economic Journal: Economic Policy, 4, 199–229. https://doi.org/10.1257/pol.4.3.199
- Golosov, M., & Krasikov, I. (2025). The optimal taxation of couples. The Quarterly Journal of Economics, 140, 2163–2211. https://doi.org/10.1093/qje/qjaf021 ↩
- Greenwood, J., Guner, N., Kocharkov, G., & Santos, C. (2014). Marry your like: Assortative mating and income inequality. American Economic Review, 104, 348–353. https://doi.org/10.1257/aer.104.5.348 ↩
- Heathcote, J., Storesletten, K., & Violante, G. L. (2017). Optimal tax progressivity: An analytical approach. The Quarterly Journal of Economics, 132, 1693–1754. https://doi.org/10.1093/qje/qjx018 ↩
- Jacquet, L., Lehmann, E., & Van der Linden, B. (2013). Optimal redistributive taxation with both extensive and intensive margins of labor supply. Journal of Economic Theory, 148, 1770–1805. https://doi.org/10.1016/j.jet.2013.07.009
- Kleven, H. J., Kreiner, C. T., & Saez, E. (2009). The optimal income taxation of couples. Econometrica, 77, 537–560. https://doi.org/10.3982/ECTA7228 ↩
- Keane, M., & Rogerson, R. (2012). Micro and macro labor supply elasticities: A reassessment of conventional wisdom. Journal of Economic Literature, 50, 464–476. https://doi.org/10.1257/jel.50.2.464 ↩
- Mirrlees, J. A. (1971). An exploration in the theory of optimum income taxation. The Review of Economic Studies, 38, 175–208. https://doi.org/10.2307/2296779 ↩
- Rochet, J.-C., & Choné, P. (1998). Ironing, sweeping and multidimensional screening. Econometrica, 66, 783–826. https://doi.org/10.2307/2999574 ↩
- Saez, E. (2001). Using elasticities to derive optimal income tax rates. The Review of Economic Studies, 68, 205–229. https://doi.org/10.1111/1467-937X.00166 ↩
- Saez, E. (2002). Optimal income transfer programs: Intensive versus extensive labor supply responses. The Quarterly Journal of Economics, 117, 1039–1073. https://doi.org/10.1162/003355302760193952 ↩
- Sibuya, M. (1959). Bivariate extreme statistics. Annals of the Institute of Statistical Mathematics, 11, 195–210. https://doi.org/10.1007/BF01673898 ↩
- Voena, A. (2015). Yours, mine, and ours: Do divorce laws affect the intertemporal behavior of couples? American Economic Review, 105, 2295–2332. https://doi.org/10.1257/aer.20120280 ↩
Phụ lục A. Báo cáo bình duyệt học thuật độc lập
A.1. Đánh giá tổng quan đóng góp học thuật và vị thế nghiên cứu
Nghiên cứu của Mikhail Golosov và Ilia Krasikov (2025), mang tiêu đề "The Optimal Taxation of Couples", xuất bản trên tạp chí The Quarterly Journal of Economics, đặt nền móng lý thuyết cấu trúc giải quyết bài toán sàng lọc đa chiều trong thiết kế hệ thống thuế thu nhập phi tuyến tối ưu đối với hộ gia đình kết hôn. Trong khuôn khổ kinh tế học công cộng chuẩn mực kế thừa từ James Mirrlees, bài toán tối ưu hóa một chiều đối với cá nhân độc thân thiết lập sự đánh đổi cơ bản giữa tái phân phối xã hội và biến dạng cung lao động. Khi mở rộng sang cấu trúc hộ gia đình hai thành viên, bài toán chuyển thành bài toán sàng lọc hai chiều phức tạp, nơi chính sách thuế không chỉ tương tác với năng suất lao động cá nhân mà còn tác động trực tiếp đến sự phân bổ nguồn lực và quyết định cung ứng lao động nội bộ hộ gia đình.
Mô hình cấu trúc giả định một nền kinh tế gồm các hộ gia đình kết hôn với cặp vector năng suất lao động , trong đó hàm mật độ xác suất kết hợp được ký hiệu là . Thu nhập kiếm được tương ứng của hai thành viên là và , gắn liền với lượng thời gian cung ứng lao động . Hộ gia đình tiêu dùng chung tổng thu nhập sau thuế , trong đó biểu thị biểu thuế phi tuyến hai chiều. Hàm thỏa dụng của hộ gia đình mang dạng tựa tuyến tính đối với tiêu dùng và phân tách đẳng biến sai sở thích đối với lao động:
Trong đó:
- : mức tiêu dùng gộp của hộ gia đình;
- : mức thu nhập kiếm được của hai thành viên trong hộ gia đình;
- : năng suất lao động cá nhân tương ứng của hai cá nhân;
- : tham số chi phí phi thỏa dụng lao động, quy định độ co giãn cung lao động Frisch .
Nhà hoạch định chính sách xã hội tối đa hóa hàm phúc lợi vị lợi có trọng số Pareto, chịu ràng buộc ngân sách chính phủ và ràng buộc tương thích khuyến khích hai chiều:
Trong đó:
- : miền không gian năng suất lao động hai chiều của các cặp vợ chồng;
- : trọng số phúc lợi Pareto ngoại sinh phân bổ cho hộ gia đình;
- : mức thỏa dụng cân bằng của hộ gia đình có vector năng suất ;
- : hàm mật độ xác suất đồng thời của năng suất lao động giữa hai vợ chồng.
Để nhận dạng cấu trúc phân phối năng suất chưa quan sát từ dữ liệu thu nhập thực nghiệm, nghiên cứu áp dụng kỹ thuật nghịch đảo cấu trúc dựa trên biểu thuế hiện hành tại Hoa Kỳ. Cụ thể, hàm thuế thực tế được tham số hóa theo dạng Heathcote-Storesletten-Violante với mức độ lũy tiến và tham số quy mô . Từ điều kiện tối ưu bậc một của hộ gia đình, năng suất lao động cá nhân được biểu diễn giải tích thuần túy dưới dạng:
Trong đó:
- : năng suất lao động nội suy của cá nhân thứ trong hộ gia đình;
- : tham số quy mô thuế suất phản ánh gánh nặng thuế bình quân;
- : tham số độ lũy tiến biên của hệ thống thuế đối với hộ kết hôn;
- : thu nhập kiếm được của thành viên thứ ;
- : tổng thu nhập kiếm được của toàn bộ hộ gia đình;
- : tham số chi phí lao động quy định độ dốc biên của hàm thỏa dụng.
Phân phối biên của năng suất cá nhân được khớp bằng phân phối Double Pareto-Lognormal với hàm phân phối tích lũy :
Trong đó:
- : hàm phân phối tích lũy của năng suất lao động cá nhân;
- : hàm phân phối tích lũy của phân phối chuẩn tắc chuẩn hóa;
- : tham số đuôi Pareto bên phải phản ánh độ tập trung của thu nhập cao;
- : tham số vị trí của phân phối log-chuẩn tiềm ẩn;
- : tham số hình dạng hoặc độ phân tán của phân phối log-chuẩn;
- : ngưỡng năng suất lao động cá nhân được kiểm tra trên miền giá trị.
Cấu trúc phụ thuộc giữa năng suất của hai vợ chồng được liên kết thông qua copula Gauss hai chiều với hệ số tương quan , trong đó biểu thị hệ số tương quan thứ hạng Kendall ước lượng từ mẫu khảo sát Current Population Survey. Đóng góp lý thuyết trung tâm của nghiên cứu là chỉ ra rằng hiện tượng kết đôi chọn lọc tương đồng về năng suất làm biến đổi căn bản cấu trúc thuế tối ưu; Cụ thể, thuế suất biên đánh trên thu nhập của người tạo thu nhập thứ cấp không nên cộng gộp lũy tiến thuần túy theo tổng thu nhập như hệ thống thuế Hoa Kỳ đương đại, mà xuất hiện tính liên kết âm nhằm giảm thiểu sự méo mó cung lao động của thành viên có độ co giãn cao trong hộ gia đình.
A.2. Phân tích phản biện chiến lược định danh nhân quả và giả định kinh tế lượng
A.2.1. Phân loại cấu trúc tệp mã nguồn và tính toàn vẹn của dữ liệu gốc
Quy trình tái lập thực nghiệm dựa trên gói lưu trữ Harvard Dataverse của bài báo bao gồm ba tệp lệnh điều hành chính: tệp 01_clean_data.R chạy trên nền tảng ngôn ngữ R phiên bản 4.3.1, cùng hai tệp sổ tay tính toán 02_taxes_data.ipynb và 03_taxes_computations.ipynb thực thi trên nền tảng Julia phiên bản 1.8.5. Quá trình kiểm định tính toàn vẹn của gói tái lập chỉ ra một số đặc tính kỹ thuật quan trọng liên quan đến xuất xứ dữ liệu và quản trị mã nguồn.
Thứ nhất, tệp dữ liệu vi mô trích xuất thô từ IPUMS-CPS mang định dạng .dat và .xml (Flood et al., 2022) không được đính kèm trực tiếp trong thư mục /data/ do điều khoản ràng buộc bản quyền người dùng của Đại học Minnesota; Người nghiên cứu độc lập bắt buộc phải tự đăng ký tài khoản, trích xuất lại các biến số định danh và tái cấu trúc tệp dữ liệu ban đầu. Mặc dù đây là thông lệ phổ biến đối với các nguồn dữ liệu bảo mật, việc thiếu vắng dữ liệu trung gian dạng trích xuất mẫu tối thiểu làm giảm tính tự động hóa khép kín của quy trình kiểm chứng độc lập.
Thứ hai, việc rà soát cấu trúc thư mục phát hiện sự tồn tại của ba tệp lịch sử thực thi lệnh .Rhistory nằm rải rác trong thư mục gốc, thư mục /scripts/ và thư mục /data/ với tổng dung lượng vượt quá . Sự hiện diện của các tệp tạm này phản ánh khâu tiền xử lý và đóng gói lưu trữ chưa đạt mức độ tinh gọn tuyệt đối; Tuy không làm sai lệch thuật toán tính toán cấu trúc, việc lưu trữ mã nguồn chưa được làm sạch hoàn toàn đặt ra yêu cầu cần chuẩn hóa nghiêm ngặt hơn trong quy trình lưu trữ mở chuẩn Q1.
A.2.2. Kiểm định tính nhất quán của tham số hệ thống thuế hiện hành
Quá trình đối chiếu tham số cấu trúc giữa các tệp lệnh phát hiện một sai lệch nhỏ nhưng mang tính hệ thống giữa tệp hiệu chuẩn dữ liệu 02_taxes_data.ipynb và tệp tối ưu hóa chính sách 03_taxes_computations.ipynb. Trong tệp 02_taxes_data.ipynb, tham số quy mô thuế suất của hộ gia đình kết hôn được ấn định ở mức , trong khi tại tệp tính toán tối ưu 03_taxes_computations.ipynb, tham số tương ứng lại được điều chỉnh lên mức .
Sự chênh lệch giữa hai giá trị này tương đương mức sai khác tương đối xấp xỉ . Do phương trình nghịch đảo năng suất dựa vào lũy thừa bậc cao với , độ lệch này tạo ra sự dịch chuyển mức độ năng suất nội suy giữa pha kiểm định phân phối thực nghiệm và pha giải bài toán cân bằng vĩ mô; Sự không đồng bộ hóa này cần được tác giả quy định thống nhất để bảo đảm tính chặt chẽ cơ học của mô hình.
Đối với các cá nhân độc thân, hệ thống tham số thuế Heathcote-Storesletten-Violante được ấn định nhất quán với độ lũy tiến và quy mô . Các tham số phân phối biên Double Pareto-Lognormal được xác lập vững chắc với , , , cùng hệ số tương quan copula Gauss .
A.2.3. Quy trình tối ưu hóa phi tuyến và kỹ thuật làm mịn spline
Bài toán sàng lọc hai chiều của hộ gia đình được rời rạc hóa trên một lưới hình học gồm điểm năng suất trên khoảng , dẫn đến không gian trạng thái hai chiều có quy mô điểm nút. Không gian tối ưu hóa phi tuyến được giải quyết bằng thuật toán nội điểm IPOPT thông qua giao diện JuMP. Các tham số điều khiển bộ tối ưu hóa bao gồm dung sai vi phạm ràng buộc constr_viol_tol = 1e-12, dung sai tối ưu tol = 1e-12, và giới hạn số vòng lặp tối đa max_iter = 200.
Việc giới hạn số vòng lặp ở ngưỡng 200 đối với một bài toán phi tuyến quy mô lớn có tới 320.000 biến quyết định thu nhập và hơn 319.200 ràng buộc bất đẳng thức phi tuyến tiềm ẩn rủi ro thuật toán có thể dừng lại tại điểm hội tụ khả thi cục bộ chấp nhận được mà chưa đạt trạng thái cực tiểu toàn cục tuyệt đối. Cụ thể, trong chương trình tối ưu hóa nới lỏng comp2d, chỉ các ràng buộc tương thích khuyến khích hướng xuống cục bộ giữa các nút lân cận được áp đặt:
Trong đó:
- : giá trị thỏa dụng gián tiếp của hộ gia đình tại nút lưới năng suất ;
- : giá trị thỏa dụng gián tiếp tại nút lưới liền kề có năng suất người thứ nhất thấp hơn;
- : mức thu nhập tối ưu của người thứ nhất tại nút lưới ;
- : giá trị năng suất rời rạc trên lưới hình học tại các chỉ số và ;
- : tham số phản ánh nghịch đảo độ co giãn cung lao động.
Hơn nữa, tại công đoạn xử lý hậu kỳ để vẽ biểu đồ thuế suất biên trong tệp 03_taxes_computations.ipynb, nghiên cứu sử dụng hàm nội suy làm mịn hai chiều Spline2D(..., kx=1, ky=1, s=0.01). Tham số làm mịn là một lựa chọn tùy ý mang tính kinh nghiệm; Việc áp dụng hệ số làm mịn ngoại sinh có thể che lấp các biến động cục bộ hoặc hiện tượng gợn sóng thuế suất biên tại các điểm biên của phân phối thu nhập hộ gia đình.
A.3. Thẩm định chất lượng dữ liệu, cách đo lường biến số và độ nhạy mẫu
A.3.1. Giả định đồng nhất độ co giãn frisch và thiên lệch ước lượng
Mô hình cấu trúc của Golosov và Krasikov ấn định tham số chi phí lao động , tương ứng với độ co giãn cung lao động Frisch đồng nhất cho cả người tạo thu nhập chính lẫn người tạo thu nhập thứ cấp. Tuy nhiên, hàng loạt bằng chứng thực nghiệm kinh tế lượng chuẩn mực trong kinh tế học vi mô thực nghiệm (Blundell et al., 2016; Bargain, Orsini & Peichl, 2014; Keane & Rogerson, 2012) đều chứng minh rằng độ co giãn cung lao động có tính không đồng nhất sâu sắc: người tạo thu nhập chính có độ co giãn thấp trong khoảng đến , trong khi người tạo thu nhập thứ cấp thường có độ co giãn phản ứng rất mạnh trong khoảng đến .
Khi xem xét phương trình xác định thuế suất biên tối ưu đối với người tạo thu nhập thứ cấp dọc theo cận biên chuyên sâu, công thức định giá biên thuế suất tuân theo quan hệ tỷ lệ nghịch với độ co giãn Frisch:
Trong đó:
- : thuế suất biên tối ưu đánh trên thu nhập của người tạo thu nhập thứ cấp;
- : độ co giãn cung lao động Frisch của người tạo thu nhập thứ cấp;
- : hàm phân phối tích lũy có điều kiện của năng suất theo năng suất ;
- : hàm mật độ xác suất có điều kiện tương ứng giữa hai vợ chồng;
- : trọng số phúc lợi xã hội Pareto đánh trên hộ gia đình tại các mức năng suất .
Việc áp đặt giả định thay vì mức thực nghiệm trung bình tạo ra một thiên lệch cấu trúc nghiêm trọng: tỷ số biến dạng thuế bị phóng đại cơ học khoảng lần; Do đó, mức thuế suất biên tối ưu ước lượng cho người có thu nhập thứ hai trong mô hình bị lệch lên cao đáng kể so với mức thuế suất tối ưu thực tế cần áp dụng để bảo vệ tính hiệu quả kinh tế.
A.3.2. Cấu trúc phụ thuộc phi tuyến và hạn chế của copula gauss
Nghiên cứu sử dụng copula Gauss với tham số tương quan để mô tả mối quan hệ kết đôi giữa hai vợ chồng. Đặc tính giải tích cơ bản của copula Gauss là tính độc lập tiệm cận ở phần đuôi phân phối (Sibuya, 1959):
Trong đó:
- : các biến ngẫu nhiên biểu diễn phân vị năng suất chuẩn hóa của hai vợ chồng;
- : ngưỡng phân vị tiệm cận tiến dần về giá trị cực đại 1;
- : hệ số tương quan tuyến tính của copula Gauss.
Thực tế dữ liệu xã hội học và kinh tế học hiện đại (Greenwood et al., 2014; Chiappori, Salanié & Weiss, 2017) chỉ ra xu hướng kết đôi siêu chọn lọc tại nhóm thu nhập cao nhất, nơi các cá nhân có trình độ học vấn và năng suất cực cao kết hôn với nhau với tần suất vượt trội so với phân phối chuẩn. Copula Gauss đánh giá thấp xác suất xuất hiện các cặp vợ chồng cùng thuộc nhóm có thu nhập cao nhất; Hệ quả là mô hình đánh giá thấp quy mô cơ sở thuế tại vùng phân phối đỉnh cao, dẫn đến thuế suất biên tối ưu tại vùng đuôi phải bị suy giảm nhân tạo. Việc kiểm định độ nhạy với các dạng copula có phụ thuộc đuôi trên như copula Student- với bậc tự do thấp hoặc copula Gumbel là một yêu cầu chẩn đoán kinh tế lượng tối thiểu.
A.3.3. Thiên lệch chọn mẫu do loại trừ cận biên gia nhập thị trường
Quy trình lọc mẫu dữ liệu trong tệp 01_clean_data.R đặt ra tiêu chí khắt khe: chỉ giữ lại các cá nhân làm việc ít nhất 20 tuần trong năm thông qua biến wkswork1 >= 20 và là lao động làm công ăn lương thuộc nhóm mã classwkr %in% 20:28. Bộ lọc này loại bỏ hoàn toàn các cá nhân không tham gia lực lượng lao động hoặc thất nghiệp dài hạn, chiếm khoảng đến tổng số phụ nữ có gia đình trong độ tuổi lao động tại Hoa Kỳ.
Quy trình này làm phát sinh thiên lệch chọn mẫu tự chọn trầm trọng; Cụ thể, mô hình chỉ phân tích quyết định cung ứng lao động trên cận biên chuyên sâu và hoàn toàn triệt tiêu cận biên mở rộng. Theo các phân tích chuẩn mực của Saez (2002) cũng như Kleven, Kreiner và Saez (2009), độ co giãn cận biên mở rộng của người tạo thu nhập thứ cấp thường rất lớn trong khoảng đến . Khi tồn tại cận biên mở rộng, biểu thuế tối ưu cần thiết kế các khoản trợ cấp gia nhập thị trường hoặc thuế suất biên âm tại vùng thu nhập thấp; Việc bỏ qua cận biên này khiến các kết luận chính sách của bài báo không phản ánh được cấu trúc khuyến khích làm việc toàn diện.
A.4. Các hạn chế cốt lõi trọng yếu của nghiên cứu gốc
A.4.1. Giả định thỏa dụng tựa tuyến tính và chệch ước lượng do loại trừ hiệu ứng thu nhập
Hàm thỏa dụng hộ gia đình trong nghiên cứu mang dạng tựa tuyến tính theo tiêu dùng, ngụ ý rằng độ thỏa dụng biên của tiêu dùng là hằng số và hoàn toàn triệt tiêu hiệu ứng thu nhập đối với cung lao động. Trong thực tế hành vi hộ gia đình, khi thu nhập của người tạo thu nhập chính tăng cao, hiệu ứng thu nhập tạo ra động lực mạnh mẽ khiến người phối ngẫu thứ hai giảm cung lao động hoặc rời khỏi thị trường việc làm; Việc bỏ sót biến phản ánh hiệu ứng thu nhập dẫn đến chệch ước lượng trực tiếp đối với thuế suất biên tối ưu của người tạo thu nhập thứ cấp và triệt tiêu hoàn toàn nhu cầu bảo hiểm rủi ro thu nhập nội bộ hộ gia đình trong thiết kế an sinh xã hội.
A.4.2. Mô hình hộ gia đình đơn nhất và thiên lệch từ sự vắng mặt của thương lượng nội bộ
Nghiên cứu áp dụng mô hình hộ gia đình đơn nhất, giả định rằng mọi quyết định tiêu dùng và lao động đều tối đa hóa một hàm thỏa dụng đồng thuận duy nhất với cơ chế chia sẻ nguồn lực hoàn hảo. Tuy nhiên, kinh tế học hộ gia đình hiện đại (Chiappori, 1988; Chiappori, 1992; Browning & Chiappori, 1998; Voena, 2015) chứng minh các thành viên trong gia đình sở hữu trọng số quyền lực thương lượng nội bộ không đồng nhất phụ thuộc vào tỷ trọng thu nhập và phương án dự phòng bên ngoài; Do bỏ qua cơ chế thương lượng này, mô hình gây ra thiên lệch đánh giá phúc lợi tái phân phối khi so sánh giữa biểu thuế cá nhân độc lập và biểu thuế lũy tiến gộp hộ gia đình.
A.4.3. Sai số đo lường từ việc bỏ qua sản xuất hộ gia đình và thời gian phi thị trường
Mô hình cấu trúc giả định toàn bộ thời gian không dành cho lao động thị trường đều trở thành thời gian nghỉ ngơi thuần túy. Theo lý thuyết kinh tế học gia đình kinh điển của Becker (1965) cùng các mở rộng về thuế tối ưu của Apps và Rees (1999) cũng như Gelber và Mitchell (2012), thời gian phi thị trường của người phối ngẫu thứ hai chủ yếu dành cho sản xuất hộ gia đình gồm chăm sóc con cái và quản lý gia vụ có khả năng thay thế cao cho hàng hóa thị trường; Việc xem đây là biến bỏ sót cấu trúc tạo ra sai số đo lường đáng kể đối với độ co giãn bù trừ thực tế khi lao động thứ cấp dịch chuyển từ việc làm thị trường chịu thuế sang sản xuất tự cấp không chịu thuế, làm thiên lệch căn cứ thiết lập mức thuế suất biên thấp cho người tạo thu nhập thứ hai.
A.4.4. Thách thức nhận dạng và vi phạm tiệm cận do nới lỏng ràng buộc khuyến khích
Để giải bài toán tối ưu hóa đa chiều trên lưới số trị, các tác giả chỉ áp đặt các ràng buộc tương thích khuyến khích hướng xuống cục bộ giữa các nút lưới năng suất lân cận đã trình bày tại mục A.2.3. Trong lý thuyết sàng lọc đa chiều (Rochet & Choné, 1998; Armstrong, 1996), việc chỉ thỏa mãn ràng buộc hướng xuống cục bộ không bảo đảm nghiệm số trị thỏa mãn tương thích khuyến khích toàn cục; Hiện tượng dồn cụm đa chiều trên các siêu mặt biên làm phát sinh thiên lệch cấu trúc ở mức thuế suất biên tối ưu ước lượng, do không có thủ tục kiểm định hậu nghiệm hoặc ủi nếp bảo đảm tính nhất quán toán học của biểu thuế trên toàn miền phân phối.
A.5. Khuyến nghị nâng cấp mô hình và hướng mở rộng công bố quốc tế
A.5.1. Khung mô hình hóa mở rộng và hàm mục tiêu cải tiến
Để khắc phục các hạn chế phương pháp luận đã chỉ ra, nghiên cứu tiếp theo cần triển khai lộ trình nâng cấp kinh tế lượng theo năm trụ cột cấu trúc:
Thứ nhất, tích hợp tính không đồng nhất của độ co giãn cung lao động Frisch giữa hai vợ chồng. Cần tổng quát hóa hàm chi phí lao động với hai tham số riêng biệt , trong đó , tương ứng độ co giãn , và , tương ứng độ co giãn , phản ánh đúng thực tế hành vi thị trường lao động.
Thứ hai, mở rộng bài toán sang cấu trúc cận biên kép tích hợp đồng thời quyết định tham gia thị trường việc làm rời rạc và quyết định cường độ lao động liên tục theo khuôn khổ của Jacquet, Lehmann và Van der Linden (2013).
Thứ ba, chuyển đổi từ mô hình đơn nhất sang mô hình thương lượng tập thể với quy tắc chia sẻ nội bộ phụ thuộc vào mức lương thị trường và thể chế pháp lý hôn nhân; Đồng thời, kiểm định sự tương tác giữa chính sách thuế và quyền lực thương lượng của phụ nữ.
Thứ tư, thay thế copula Gauss bằng các cấu trúc copula phi tuyến linh hoạt hơn như copula Student- đa chiều hoặc copula phi tham số Bernstein, cho phép kiểm định độ nhạy của biểu thuế tối ưu trước hiện tượng kết đôi chọn lọc cực trị tại phần đuôi thu nhập cao.
Thứ năm, xây dựng thuật toán kiểm chứng hậu nghiệm toàn diện đối với toàn bộ các ràng buộc khuyến khích hai chiều, tích hợp thủ tục ủi nếp tự động giải quyết dồn cụm đa chiều trên lưới số trị.
A.5.2. Tổng hợp chẩn đoán và lộ trình hoàn thiện thực nghiệm
Bảng A1 tổng hợp toàn diện các chiều kích chẩn đoán kinh tế lượng, chỉ rõ hạn chế trong mô hình nguyên bản của Golosov và Krasikov (2025) và đề xuất các giải pháp nâng cấp đáp ứng tiêu chuẩn công bố khoa học đỉnh cao.
| Thứ nguyên chẩn đoán | Mô hình gốc (Golosov & Krasikov, 2025) | Rủi ro nhận dạng / Hạn chế kinh tế lượng | Hệ quả ước lượng chính sách | Khuyến nghị cải tiến chuẩn Q1 |
|---|---|---|---|---|
| Độ co giãn cung lao động | Áp đặt đồng nhất , suy ra . | Mâu thuẫn với thực nghiệm vi mô; Bỏ qua tính nhạy cảm cao của lao động thứ cấp. | Phóng đại thuế suất biên tối ưu của người phối ngẫu thứ hai lên lần. | Tách biệt , hiệu chuẩn và . |
| Cấu trúc phụ thuộc cặp đôi | Sử dụng copula Gauss với tương quan tuyến tính . | Độc lập tiệm cận phần đuôi; Bỏ qua hiện tượng siêu kết đôi ở nhóm giàu nhất. | Đánh giá thấp cơ sở thuế đỉnh cao; Thuế suất biên vùng đuôi phải bị suy giảm nhân tạo. | Ước lượng copula Student-, Clayton hoặc Gumbel có phụ thuộc đuôi trên. |
| Cận biên cung lao động | Chỉ xem xét cận biên chuyên sâu; Lọc bỏ lao động làm dưới 20 tuần trong năm. | Thiên lệch chọn mẫu do loại trừ nhóm không tham gia lực lượng lao động. | Không thiết kế được chính sách trợ cấp gia nhập thị trường và thuế suất biên âm. | Tích hợp cận biên mở rộng với chi phí gia nhập cố định ngẫu nhiên. |
| Cấu trúc thỏa dụng và ra quyết định hộ | Dạng tựa tuyến tính theo tiêu dùng; Mô hình hộ gia đình đơn nhất. | Triệt tiêu hiệu ứng thu nhập chéo; Bỏ qua quyền lực thương lượng và sản xuất gia đình. | Bỏ lỡ kênh tái phân phối nội bộ và méo mó do chuyển dịch sang việc nhà tự cấp. | Ứng dụng thỏa dụng tổng quát với mô hình tập thể và thời gian sản xuất gia đình. |
| Phương pháp số trị và ràng buộc khuyến khích | Nới lỏng ràng buộc hướng xuống; Giới hạn tối ưu hóa 200 vòng lặp; Làm mịn spline. | Ràng buộc tương thích khuyến khích toàn cục và dồn cụm đa chiều chưa được kiểm chứng. | Biểu thuế tối ưu tiềm ẩn nguy cơ bất khả thi khuyến khích trên không gian thực. | Triển khai thuật toán ủi nếp hai chiều và kiểm định vi phạm khuyến khích toàn cục. |
Ghi chú: Phân tích cấu trúc đối chiếu trực tiếp giữa các tệp mã nguồn lưu trữ Harvard Dataverse mang mã định danh DOI: 10.7910/DVN/MCNBPF và khung giải tích kinh tế lượng công bố trên The Quarterly Journal of Economics.
golosov_krasikov_2025_couples_optimal_taxcouple_idw1w2w_totalw_ratioy1_hsvy2_hsvy_total_hsvearner_share2log_y_total_hsvlog_y1_hsvlog_y2_hsvMở khóa dữ liệu & mã lệnh tái lập
Sau khi theo dõi phần phân tích định lượng và bình duyệt học thuật phía trên, mời bạn đăng nhập nếu đã có gói thành viên hoặc tham gia cộng đồng nghiên cứu EcoLab để trực tiếp kiểm chứng từng hệ số ước lượng trên máy cá nhân.
Khớp chính xác tên biến, đặc tả sai số chuẩn vững và ma trận kiểm định chẩn đoán của bài nghiên cứu.
Sẵn sàng nạp trực tiếp vào môi trường thống kê cá nhân để đối chiếu độc lập từng bảng kết quả.
Đóng gói đồng bộ bản thảo chuẩn công bố tạp chí DOCX & PDF, tệp dữ liệu CSV, ba kịch bản ước lượng R · Stata · Python và hướng dẫn thực thi.
Mỗi liên kết tải xuống được cấp chữ ký bảo mật riêng cho tài khoản thành viên và tự động làm mới mượt mà ngay trên trang đọc.